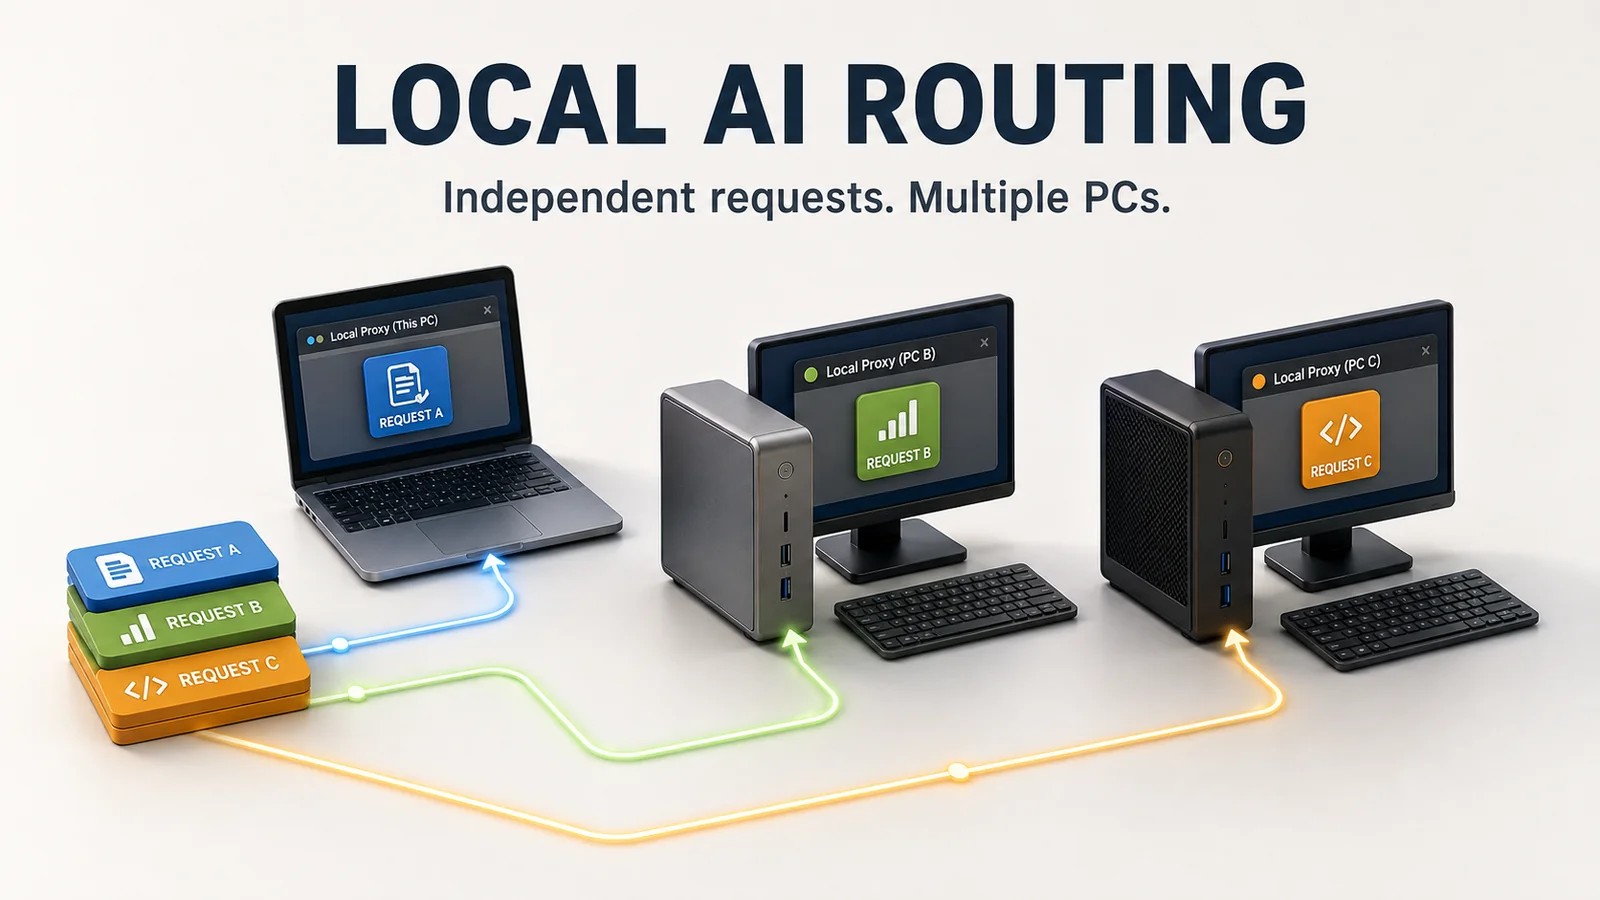
NVIDIA PAIR는 여러 PC를 어떻게 묶을까? 로컬 AI 요청 분산의 구조와 한계
NVIDIA PAIR는 여러 PC의 GPU 메모리(VRAM)를 하나로 합치는 기술이 아니라, 독립적인 추론 요청을 로컬 네트워크의 실행 가능한 장비에 나누어 보내는 도구입니다. 같은 모델을 실행할 수 있는 장비가 여럿이고 동시에 처리할 요청이 충분하면 전체 작업의 대기 시간을 줄일 수 있습니다. 한 PC에서 실행하지 못하던 큰 모델을 여러 PC의 메모리를 합쳐 실행하는 용도로는 쓸 수 없습니다.
NVIDIA는 2026년 9월 3일 Personal AI Router(PAIR) 베타를 소개했습니다. 모델을 실제로 실행하는 것은 여전히 Ollama나 LM Studio이고, PAIR는 요청이 어느 장비에서 실행될지를 결정합니다. 이 글은 PAIR를 직접 설치해 측정한 사용기가 아니라, 2026년 9월 6일 확인한 공식 발표·문서·저장소를 근거로 구조와 한계를 정리한 글입니다. 본문에 나오는 성능 수치는 모두 NVIDIA가 공개한 데모의 값이며, 확인된 동작과 구조에서 예상한 가능성은 문장에서 구분해 적었습니다. NVIDIA 발표
1. 먼저 살펴볼 병목은 모델 크기보다 동시 요청입니다
로컬 AI를 혼자 대화하는 도구로 쓰면 한 번에 한 요청을 보내는 경우가 많습니다. 하지만 여러 문서를 각각 요약하거나, 여러 에이전트가 자료 조사와 코드 검토를 나누어 수행하면 상황이 달라집니다. 사용자가 준 과제는 하나여도 모델 호출은 여러 개가 겹쳐 발생할 수 있습니다.
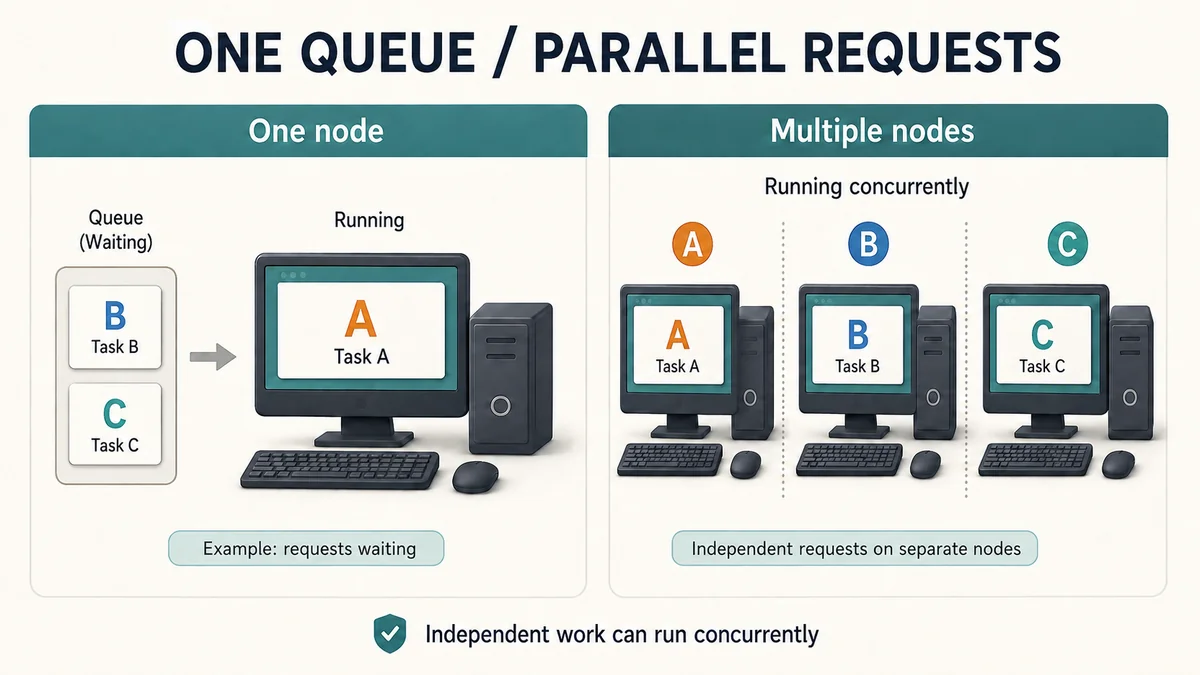
동시에 실행할 수 있는 독립 요청이 있어야 여러 노드에 나누어 처리할 여지가 생깁니다. 한 요청을 여러 조각으로 나누는 방식은 아닙니다.
이때 모델이 GPU 메모리에 들어간다는 사실만으로 작업이 원활해지지는 않습니다. 요청들이 같은 추론 엔진의 실행 자리를 두고 경쟁하기 때문입니다. 다른 방의 PC가 쉬고 있어도 애플리케이션이 한 엔진만 바라보고 있으면 그 장비를 활용하지 못합니다.
PAIR가 겨냥하는 것은 이 지점입니다. NVIDIA는 PAIR의 역할을 로컬 네트워크에서 준비된 장비에 독립 작업을 보내, 한 엔진 뒤에 쌓이던 대기를 줄이는 것으로 설명합니다. 동시에 실행해도 되는 요청을 여러 장비에 배치해 처리량(throughput)을 늘리는 방식입니다.
| 작업 형태 | 나누어 실행할 수 있는 일 | PAIR에 기대할 수 있는 효과 |
|---|---|---|
| 독립 문서 여러 개 요약 | 문서별 추론 요청 | 여러 장비에서 동시 처리 |
| 여러 에이전트의 독립 검토 | 각 검토에 필요한 모델 호출 | 한 엔진에 몰리는 대기 완화 |
| 하나의 긴 답변 생성 | 해당 요청 하나 | 여러 PC로 요청 내부를 분할하지 않음 |
| 앞 답변을 받아 다음 질문 생성 | 순서가 정해진 호출 | 동시에 실행할 요청이 적으면 효과 제한 |
에이전트가 과제를 나누는 원리는 AI Agent 가이드에서 이어 볼 수 있습니다. 여기서는 역할을 구분하면 이해하기 쉽습니다. 에이전트는 무슨 일을 요청할지 정하고, PAIR는 그 요청을 어디에서 실행할지 정합니다.
2. 중앙 서버 한 대가 아니라 각 PC의 로컬 프록시가 출발점입니다
PAIR에서 노드(node)는 PAIR가 실행되는 장비 한 대를 뜻합니다. 페어링한 노드들이 클러스터(cluster)를 구성하며, 항상 우선하는 중앙 노드나 최초 생성자 역할은 없습니다. 각 노드는 같은 서비스를 실행하고, 자신의 요청을 처리하거나 다른 노드에 전달할 수 있습니다.
요청을 보내는 애플리케이션은 자기 PC의 프록시(proxy)에 접속합니다. 이 프록시가 선택한 곳이 자기 PC라면 로컬 엔진을, 다른 PC라면 그 PC의 PAIR 프록시를 거쳐 해당 엔진을 사용합니다. 응답은 들어온 경로를 따라 돌아옵니다. 공식 아키텍처
flowchart LR
    subgraph A["PC A: 요청을 보내는 노드"]
        App["애플리케이션"] -->|"로컬 HTTP"| PA["PAIR 프록시"]
        PA -->|"A를 선택한 경우"| EA["A의 추론 엔진"]
    end
    subgraph B["PC B: 페어링한 노드"]
        PB["PAIR 프록시"] --> EB["B의 추론 엔진"]
    end
    PA -->|"B를 선택한 경우: mTLS"| PB
한 요청은 A 또는 B 중 한 곳에서 실행됩니다. 그림의 두 갈래는 선택 가능한 경로이며, 한 요청을 복제하거나 나누어 실행한다는 뜻이 아닙니다.
프록시는 목적지 한 곳을 정하는 것이 아니라 순서가 있는 대체 실행 목록을 만듭니다. 사용자가 직접 고정한 노드가 있으면 가장 앞에 오고, 그다음이 스케줄러(scheduler)가 매긴 우선순위이며, 마지막은 노드 ID 순서입니다. 앞 후보가 요청을 받지 못하면 다음 후보로 넘어갑니다. 다만 이 목록은 요청한 모델을 실제로 제공할 수 있는 노드 안에서만 만들어지므로, 부하가 분산되는 범위는 클러스터 전체가 아닙니다.
이 구조 때문에 다른 PC의 앱에서 http://서버IP:11434를 입력하는 방식은 기본 사용법이 아닙니다. 네트워크에서 들어오는 일반 HTTP 요청은 403으로 거부됩니다. 앱을 쓰는 PC에도 PAIR를 실행하고 클러스터에 참여시킨 다음, 그 PC의 로컬 주소에 연결해야 합니다. 이 PC에는 GPU나 추론 엔진이 없어도 됩니다. 모델 실행은 다른 노드가 맡을 수 있습니다. 클라이언트 접속 방식
3. 메모리 통합과 요청 분산은 해결하는 문제가 다릅니다
GPU 메모리가 부족할 때 찾는 기술과, 요청이 밀릴 때 찾는 기술은 구별해야 합니다. PAIR는 한 모델의 가중치를 여러 PC에 나누어 놓는 모델 샤딩(model sharding)을 제공하지 않습니다. 같은 모델을 두 노드에 준비하면 공유 모델 하나가 아니라 독립적인 복제본 두 개가 됩니다. PAIR README
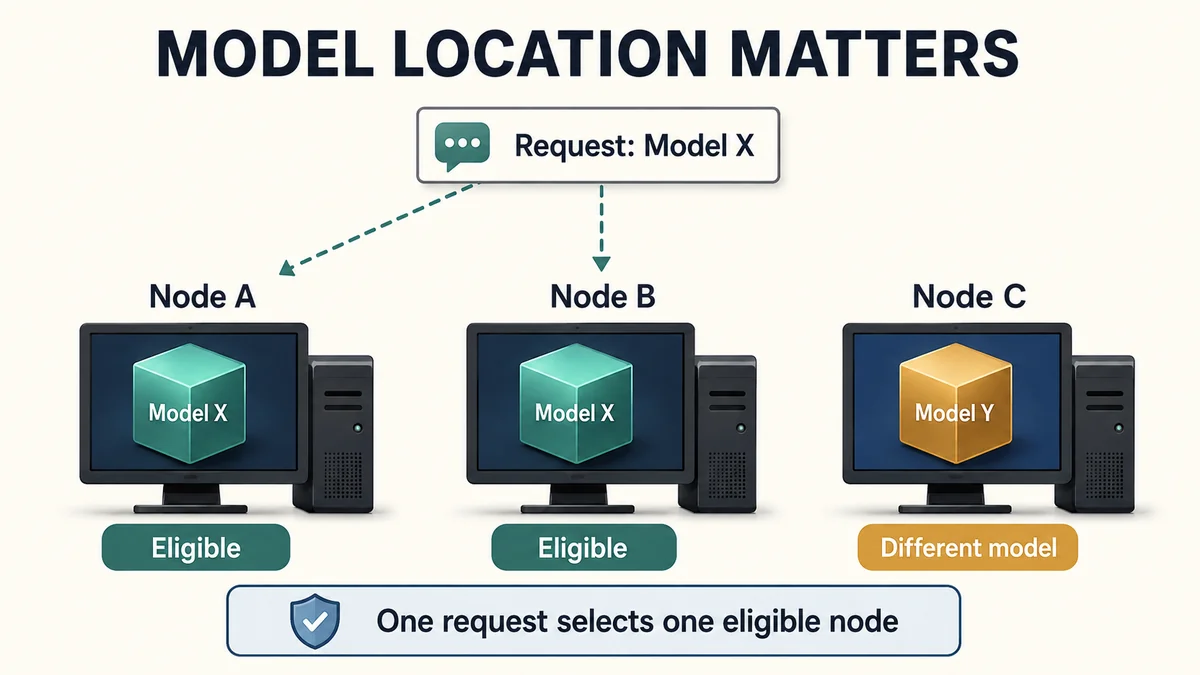
모델 X를 보유하고 엔진이 실행 중인 A·B가 후보가 되고 C는 제외됩니다. 점선은 선택 가능한 경로이며, 실제 요청은 후보 중 한 곳에서 실행됩니다.
| 질문 | PAIR의 동작 | 준비할 때의 의미 |
|---|---|---|
| 두 GPU의 메모리를 합칠 수 있나요? | 메모리 풀링을 하지 않습니다 | 각 실행 노드에서 모델이 실행 가능해야 합니다 |
| 요청 하나를 여러 PC가 함께 계산하나요? | 요청 하나는 배정된 노드에서 끝까지 처리됩니다 | 한 요청의 계산을 나눌 목적으로 도입하지 않습니다 |
| 모든 PC에 같은 모델이 필요한가요? | 서로 다른 모델 배치도 가능합니다 | 모델별로 실행 가능한 노드가 달라집니다 |
| 같은 모델의 요청을 분산하려면요? | 그 모델을 보유한 후보들 사이에서 선택합니다 | 복제본을 여러 실행 노드에 준비합니다 |
예를 들어 A와 B에 모델 X가 있고 C에 모델 Y만 있다면, X 요청의 분산 범위는 A와 B입니다. C가 아무리 한가해도 X를 대신 실행하지 못합니다. 클러스터 전체의 장비 수보다 지금 요청한 모델을 실행할 수 있는 장비 수가 중요합니다.
여기서 “각 노드에서 실행 가능해야 한다”가 “반드시 모든 가중치가 GPU 메모리에만 들어가야 한다”는 뜻은 아닙니다. 실제 메모리 사용과 실행 방식은 엔진·모델·하드웨어의 조합에 달려 있습니다. PAIR가 실행 엔진의 자원 조건을 대신 해결하지 않는다는 의미입니다.
한 요청은 배정된 노드에서 수명이 끝날 때까지 머무릅니다. 도중에 더 한가한 노드로 옮겨 가지 않습니다. 그렇다고 응답 시간이 절대 줄지 않는다는 뜻은 아닙니다. 기다리던 요청을 덜 바쁜 노드에 배정하면 대기가 줄어 응답을 더 일찍 받는 상황을 구조상 예상할 수 있습니다. 다만 이는 한 요청의 계산을 여러 GPU가 나누어 처리해서 얻는 가속과 구분해야 합니다.
4. 기존 API를 유지하지만 실제 포트의 주인은 바뀝니다
기존 앱을 연결할 때는 base URL을 무조건 바꾸기보다 PAIR의 Endpoints 화면을 먼저 확인해야 합니다. 기본 구성에서는 PAIR가 Ollama와 LM Studio의 익숙한 포트를 차지하고, 실제 엔진은 다음 사용 가능한 포트로 옮겨 갑니다. 시작 가이드의 포트 설명
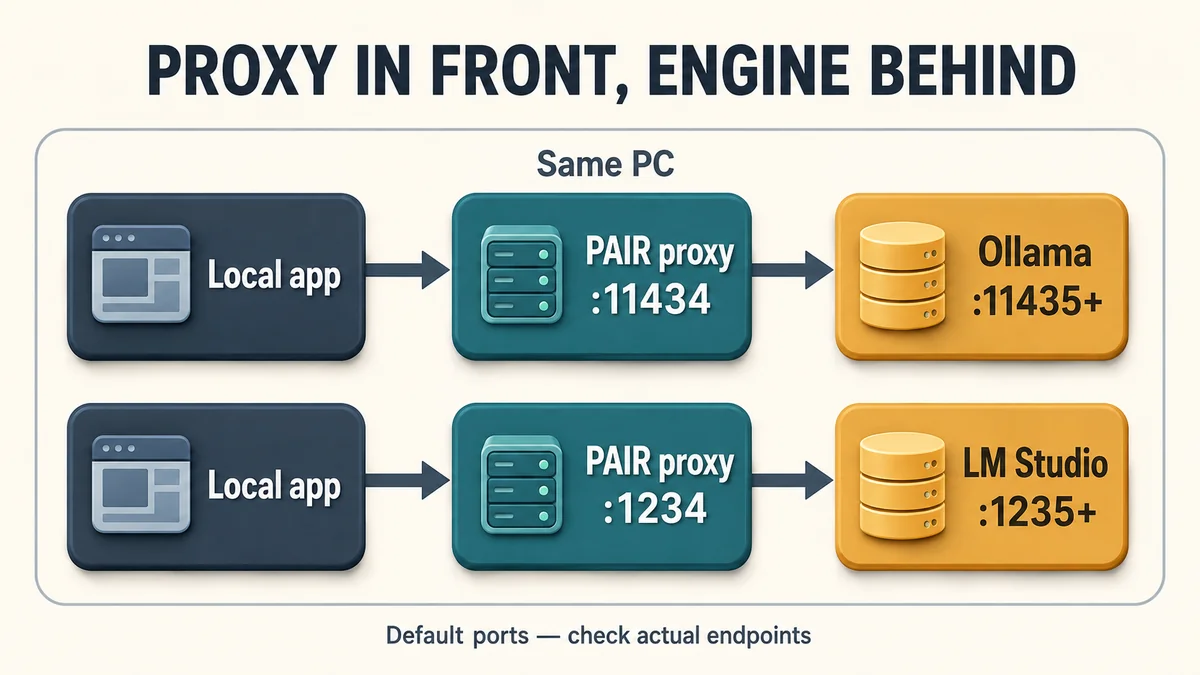
기본 구성에서 익숙한 11434·1234 포트는 프록시가 사용합니다. 실제 엔진 포트는 뒤로 이동하며, 포트 충돌이나 사용자 설정이 있으면 달라집니다.
| 구분 | 앱이 연결하는 PAIR 기본 포트 | PAIR 뒤의 엔진 기본 포트 | 채팅 요청 경로 |
|---|---|---|---|
| Ollama 쪽 | 11434 | 11435 또는 그 이상 | /api/chat, /v1/chat/completions |
| LM Studio 쪽 | 1234 | 1235 또는 그 이상 | /v1/chat/completions |
기존 앱이 같은 PC의 11434를 사용했다면 주소를 유지한 채 PAIR를 거치게 될 수 있습니다. 반대로 PAIR가 관리하지 않는 다른 프로세스가 그 포트를 사용하고 있으면 충돌을 해결해야 합니다. 프록시 포트를 변경했다면 앱의 주소도 바꿉니다. 문서에 적힌 기본값보다 현재 Endpoints에 표시되는 URL이 우선합니다.
OpenAI 호환 API를 쓰는 앱은 base URL에 /v1까지 요구하는 경우가 있습니다. 반면 Ollama 전용 앱은 보통 호스트 주소 뒤에 /api/...를 붙입니다. 앱이 경로를 덧붙이는 규칙을 확인해야 /v1을 중복하거나 누락하지 않습니다.
또한 PAIR는 API 형식을 만능으로 번역하는 계층이 아닙니다. LM Studio 쪽에 Ollama 전용 /api/chat 요청을 보내면 동작하지 않습니다. 공식 문서도 어느 쪽을 쓸지 확실하지 않으면 두 엔진에서 모두 동작하는 OpenAI 방식으로 보내라고 안내합니다. 연결이 된 뒤에도 사용하려는 경로와 기능을 엔진이 지원하는지 확인해야 합니다. 공식 요청 형식과 앱 연결 안내
5. 스케줄러는 현재 부담을 보지만 장비의 성능을 정밀하게 알지는 못합니다
PAIR는 “어느 노드가 이 모델을 실행할 수 있는가”와 “그중 어디를 먼저 선택할 것인가”를 나누어 처리합니다. 모델 이름이 있는 추론 요청은 해당 엔진의 목록에 그 모델이 있는 노드만 후보로 삼습니다. 여기에 스케줄러가 만든 순서를 적용합니다.
2026년 9월 6일 확인한 README는 현재 정책이 대기 작업과 대략적인 GPU 사용률을 조합하며, 이 방식이 성능 편차가 큰 클러스터보다 비슷한 하드웨어에서 더 잘 맞는다고 밝힙니다. GPU 종류, 사용 가능한 메모리, 모델의 메모리 로딩 상태, 요청 비용 예측은 반영하지 않습니다. 공식 아키텍처 문서는 이 성질을 스케줄러가 “용량이 아니라 부담을 본다”고 요약합니다. 따라서 성능이 크게 다른 장비를 섞으면 한가한 저성능 장비가 기대보다 자주 선택될 수 있습니다. 현재 스케줄링 정책
| 판단 요소 | 현재 반영 방식 | 해석할 때의 주의점 |
|---|---|---|
| 요청 모델 보유 여부 | 실행 후보를 제한 | 디스크에 있는 것과 이미 메모리에 로딩된 것은 다름 |
| 대기·실행 중 작업 | 계산량과 무관하게 작업 수를 같은 무게로 반영 | 짧은 요청과 긴 요청의 실제 비용은 다름 |
| GPU 사용률 | 대략적인 부담 신호로 반영 | 사용률이 같아도 장비별 처리 능력은 다름 |
| GPU가 여러 개인 노드 | 가장 높은 사용률을 기준으로 보수적으로 판단 | 노드 안의 한가한 GPU가 선택에 반영되지 않음 |
| 사용 가능한 메모리·GPU 종류 | 정밀한 용량 판단에 사용하지 않음 | 큰 모델과 이기종 장비는 직접 확인 필요 |
| 모델 로딩 상태 | 우선순위에 사용하지 않음 | 요청 뒤에 모델 로딩 시간이 추가될 수 있음 |
“GPU 사용률이 낮으니 가장 빠른 노드”라고 생각하면 안 됩니다. 바쁜 고성능 장비가 한가한 저성능 장비보다 여전히 빨리 끝낼 수 있고, 모델이 로딩된 장비가 새로 로딩해야 하는 장비보다 유리할 수도 있습니다. 표의 제한으로부터 예상할 수 있는 운영상 가능성이지, 여기서 직접 측정한 성능 결과는 아닙니다.
처음 비교할 때는 비슷한 성능의 장비에 같은 모델과 실행 조건을 맞추면 결과를 해석하기 쉽습니다. 서로 다른 장비를 쓸 수 없다는 뜻은 아닙니다. 장비를 하나씩 추가하며 전체 완료 시간과 실제 실행 위치를 비교해야 추가한 노드의 효과를 판단할 수 있습니다.
6. 18분과 8분 48초는 어떤 실험의 숫자인가요?
NVIDIA의 발표에는 Hermes Desktop이 다섯 하위 에이전트에게 자료를 나누어 검토하게 한 데모가 등장합니다. 대상은 합성된 가정용 받은편지함이고, 할 일을 오늘 밤·이번 주·나중·하지 않음으로 나누고 근거를 붙인 계획을 만드는 작업입니다. 에이전트의 분업과 결과 통합은 Hermes가, 추론 요청의 배치는 PAIR가, 모델 실행은 Ollama가 담당합니다.
| 항목 | 단일 장비 구성 | PAIR 구성 |
|---|---|---|
| 장비 | RTX Spark 노트북 | RTX Spark 노트북 + DGX Spark + RTX 5090 |
| 모델 | Qwen 3.6 35B A3B | Qwen 3.6 35B A3B |
| 작업 | 다섯 하위 에이전트 작업 | 같은 작업 |
| 발표된 평균 완료 시간 | 18분 | 8분 48초 |
자료: NVIDIA의 구성 한정 비공식 데모. 독립 벤치마크나 이 글의 실측 결과가 아닙니다. 데모 원문
이 비교에서 바뀐 것은 라우터 유무만이 아닙니다. 추가 장비의 계산 자원도 투입됐습니다. “PAIR 소프트웨어만 설치하면 속도가 두 배가 된다”거나 “PC를 세 대 쓰면 어떤 작업이든 같은 비율로 빨라진다”는 결론은 낼 수 없습니다. NVIDIA 역시 이 수치를 일반 벤치마크나 선형 확장의 약속이 아니라고 못박고, 결과가 작업의 병렬성·모델·엔진 설정·하드웨어·네트워크·노드 가용성에 따라 달라진다고 덧붙입니다.
자기 환경에서 비교할 때는 같은 과제 묶음을 사용하고 모델·엔진 설정·동시 요청 수를 기록해야 합니다. 처음 모델을 로딩하는 조건과 이미 로딩한 조건도 구분하면 좋습니다. 전체 완료 시간이 줄었는지뿐 아니라 실패가 늘지 않았는지, 결과 품질이 유지됐는지 함께 확인해야 합니다.
에이전트 수와 PAIR의 작업 수 역시 같지 않습니다. 에이전트 하나가 여러 모델 호출을 만들 수 있습니다. “하위 에이전트가 다섯 개이니 노드 다섯 대가 사용됐다”고 추정하지 말고, PAIR에 기록된 실행 노드를 확인해야 합니다.
7. 첫 요청보다 중요한 검증은 여러 노드에서 실제로 실행됐는지입니다
현재 README는 Windows 11·Linux·macOS를 지원 대상으로 안내하며, x64와 arm64를 모두 다루되 Windows on ARM은 실험적 지원이라고 구분합니다. 세 운영체제의 노드를 서로 페어링하는 것은 지원 범위 안에 있습니다. 다만 PAIR가 실행되는 것과 해당 장비에서 특정 엔진·모델이 실행되는 것은 별개입니다. 설치 전에는 운영체제뿐 아니라 엔진의 GPU·드라이버·메모리 조건도 확인해야 합니다. 지원 범위
처음에는 신뢰할 수 있는 같은 로컬 네트워크의 두 장비로 확인하면 충분합니다. 아래는 공식 데스크톱 가이드를 바탕으로 정리한 절차입니다.
| 순서 | 할 일 | 다음 단계로 넘어갈 확인 기준 |
|---|---|---|
| 1 | 각 참여 PC에 공식 릴리스 설치·실행 | Overview에 자기 노드가 나타남 |
| 2 | Add node 또는 Settings → Cluster에서 페어링 | Connected nodes에서 상대 장비 확인 |
| 3 | 실행할 노드의 엔진을 시작하고 같은 모델 준비 | 요청 모델이 각 엔진 목록에 있으며 실행 가능 |
| 4 | 요청을 보낼 PC의 Endpoints 확인 | 앱이 그 PC의 PAIR 프록시를 가리킴 |
| 5 | 요청 하나를 보내 기본 경로 확인 | 응답과 Jobs의 실행 기록 확인 |
| 6 | 독립 요청 여러 개를 겹쳐 실행 | Jobs에서 둘 이상의 실행 노드 확인 |
2단계에서 상대 장비가 보이지 않으면 네트워크를 먼저 봅니다. 앱이 쓰는 프록시 포트 외에, 노드 탐색에 5353/udp(mDNS)와 노드 통신·페어링·클러스터 관리에 14318부터 14323까지가 장비 사이에서 열려 있어야 합니다. 같은 공유기에 물려 있어도 방화벽이나 무선 AP의 단말 간 통신 차단이 이 포트를 막을 수 있습니다.
다음은 Linux 또는 macOS의 Bash와 curl을 가정한 문서 기반 요청 예시입니다. 이 글에서 실제 서버에 실행한 결과는 아닙니다. PAIR가 기본 Ollama 프록시 포트를 사용한다는 전제이며, MODEL_NAME_FROM_ENDPOINTS는 준비한 실제 모델 식별자로 바꾸어야 합니다.
curl --fail-with-body --silent --show-error \
  http://127.0.0.1:11434/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "MODEL_NAME_FROM_ENDPOINTS",
    "messages": [
      {"role": "user", "content": "Explain request routing in one sentence."}
    ],
    "stream": false
  }'
Endpoints에 표시된 주소가 다르면 URL도 바꿉니다. 응답이 성공했다면 Overview → Jobs에서 해당 카드의 Ran on 또는 Running on을 확인합니다. 여러 노드가 연결돼 있다는 화면이나 통합 모델 목록만으로 분산 실행을 확인했다고 말할 수는 없습니다.
직접 여러 요청을 만들기 어렵다면 Settings → Service → Test가 60초 동안 합성 추론 요청을 몰아 보내 같은 경로로 실행을 발생시킵니다. 이 역시 실행 노드와 응답 경로를 확인하는 용도로 쓰고, 자기 업무의 성능 측정을 대신하는 결과로 해석하지 않습니다. 첫 추론 요청과 검증 절차
한 노드에만 작업이 보이면 먼저 다른 노드에도 같은 모델이 있는지, 엔진이 실행 중인지, 요청이 실제로 겹쳐 발생했는지 확인합니다. 마지막으로 앱이 PAIR 프록시가 아니라 엔진 포트에 직접 접속하고 있지 않은지 점검합니다.
응답 자체가 실패하는 경우도 원인을 구분할 수 있습니다. 요청한 모델을 알리는 노드가 하나도 없으면 프록시는 다른 노드를 찾아 나서지 않고 로컬에서 502를 돌려줍니다. 이때 모델 목록을 즉시 다시 읽지도 않으므로, 모델을 방금 내려받았다면 목록에 반영될 때까지 같은 응답이 이어질 수 있습니다.
8. 6자리 PIN과 mTLS가 보호하는 범위는 다릅니다
PAIR의 페어링은 6자리 PIN으로 최초 신뢰를 설정하고, 이후 인증서 기반의 상호 TLS(mTLS)를 사용합니다. PIN을 장기간 쓸 비밀번호나 물리적으로 옆에 있는 장비라는 강한 증명으로 취급하면 안 됩니다. 페어링할 때 양쪽 장비와 네트워크를 신뢰할 수 있어야 하며, 예상하지 않은 초대는 거부해야 합니다. PAIR 보안 정책
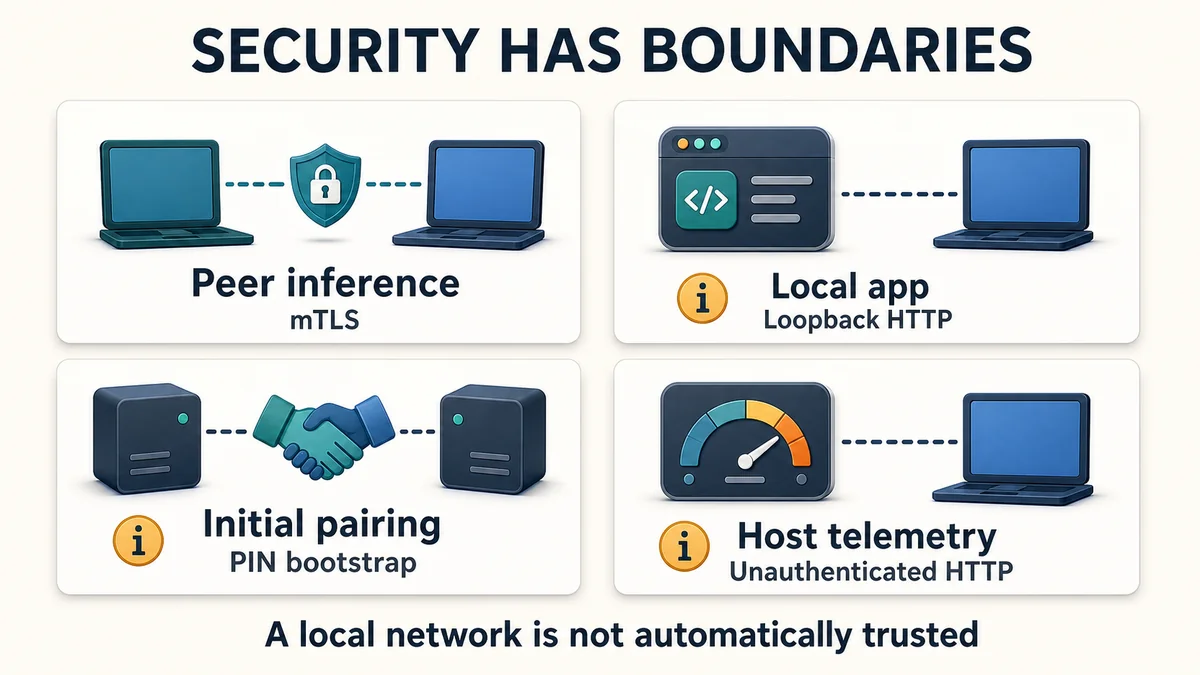
mTLS는 노드 간 추론 통신을 보호하지만 모든 통신에 적용되는 것은 아닙니다. 초기 페어링과 호스트 상태 정보는 별도의 신뢰 경계로 살펴봐야 합니다.
공식 보안 문서는 mTLS가 신원과 인증서가 갖춰진 클러스터 채널만 보호하며, 루프백 HTTP·탐색 메타데이터·노드 정보 통신·추론 엔진의 자체 API에는 자동으로 적용되지 않는다고 못박습니다. “mTLS를 사용한다”는 문구를 모든 통신에 대한 설명으로 확대하면 안 됩니다.
| 통신 구간 | 문서에 명시된 보호 방식 | 운영자가 알아야 할 범위 |
|---|---|---|
| 같은 PC의 앱 → 로컬 프록시 | 루프백 주소의 일반 HTTP | 로컬 프로세스와 운영체제 계정도 신뢰 경계에 포함 |
| 페어링한 노드 사이의 추론 | mTLS | 인증된 클러스터 채널 보호 |
| 최초 페어링 | PIN으로 인증하는 평문 교환 | PIN은 초기 신뢰 설정용 |
| 호스트·GPU 상태 정보 | 인증 없는 평문 HTTP | 같은 서브넷에서 하드웨어·사용률 등의 정보 조회 가능 |
| 뒤로 옮겨 간 추론 엔진의 API | mTLS 적용 대상이 아님 | 엔진 포트를 외부 인터페이스에 열지 않도록 별도 관리 |
통신 구간은 아키텍처의 인증 표를 기준으로 구분했습니다.
공유 사무실망이나 공용 Wi-Fi에서는 “같은 LAN이므로 안전하다”고 가정할 수 없습니다. 호스트·GPU 상태 정보는 추론 내용과 보호 범위가 다르고, 인증된 노드 자체가 침해된 경우도 mTLS만으로 해결되지 않습니다.
공식 보안 정책은 PAIR 포트를 공유기로 포워딩하거나, 인증 없는 공개 리버스 프록시(reverse proxy)를 앞에 두는 구성을 경고합니다. 또한 local-first(로컬 우선)는 네트워크 설계 방향이지 외부 통신이 없다는 보증이 아닙니다. 모델 다운로드, 업데이트, 추론 엔진, 연결한 앱의 설정이 외부 서비스와 통신할 수 있습니다. 데이터가 LAN 안에 머물러야 하는 업무라면 PAIR 외의 구성 요소까지 함께 확인해야 합니다. 보안상 가정과 제한
9. 도입 여부는 장비 수보다 요청 구조로 판단합니다
PAIR를 검토할 때 먼저 셀 것은 PC의 대수가 아니라 동시에 실행 가능한 요청과 모델 복제본입니다. 이를 확인한 뒤 실제 작업에서 얻는 시간 절감이 모델 관리와 장비 운영의 부담보다 큰지 비교하면 됩니다.
| 지금 필요한 것 | PAIR 판단 | 먼저 확인할 사항 |
|---|---|---|
| 여러 로컬 요청의 대기 완화 | 도입을 시험할 만함 | 요청 병렬성, 같은 모델의 복제본, Jobs 실행 위치 |
| 한 PC에서 실행 불가능한 큰 모델 | 해당 문제를 해결하지 않음 | 모델·엔진의 메모리 요구와 실행 방식 |
| 긴 답변 한 건의 생성 가속 | 효과를 가정하기 어려움 | 대기 시간과 실제 모델 계산 시간을 구분 |
| 성능 차이가 큰 여러 장비 활용 | 실측 후 판단 | 느린 노드나 모델 로딩이 전체 완료 시간에 미치는 영향 |
| PAIR 없는 여러 클라이언트에 API 공개 | 기본 접속 구조와 맞지 않음 | 클라이언트 PC의 PAIR 참여 가능 여부 |
가장 타당한 출발점은 이미 보유한 장비 두 대에 같은 모델을 준비하고, 실제로 자주 수행하는 독립 작업 묶음을 비교하는 것입니다. 작업이 둘 이상의 노드에서 실행되는지 먼저 확인한 뒤 전체 완료 시간과 실패 여부를 봅니다. 이 순서를 거치면 “여러 PC가 연결됐다”는 사실과 “내 업무에 도움이 됐다”는 결론을 구별할 수 있습니다.
참고한 공식 자료
- NVIDIA 기술 블로그 — PAIR 발표와 Hermes 데모: 2026년 9월 3일 발표, 특정 구성의 비공식 데모.
- Personal AI Router README: 지원 범위와 요청 분산의 범위.
- Getting Started: 페어링, 모델 준비, 포트, 실행 위치 확인.
- Architecture: 노드 구조, 모델 후보 선정, 대체 실행 목록, 스케줄링과 통신 경계.
- Security policy: PIN, mTLS, 로컬 네트워크와 외부 노출의 제한.
저장소 문서는 2026년 9월 6일의 커밋 13b68115fa2c을 기준으로 확인했습니다. main의 설명은 이후 바뀔 수 있으므로 설치할 릴리스의 동작과 함께 대조해야 합니다.