LLM은 한 토큰씩 만드는데 어떻게 더 빨라질까? Speculative Decoding의 원리와 조건
Speculative Decoding은 후보 토큰을 미리 만들고 큰 모델이 묶어서 검증해 순차 실행을 줄입니다. 정확한 확률 보정으로 목표 분포를 유지할 수 있지만, 가속 여부는 채택된 토큰 수와 초안 생성·검증 비용을 함께 측정해야 판단할 수 있습니다.
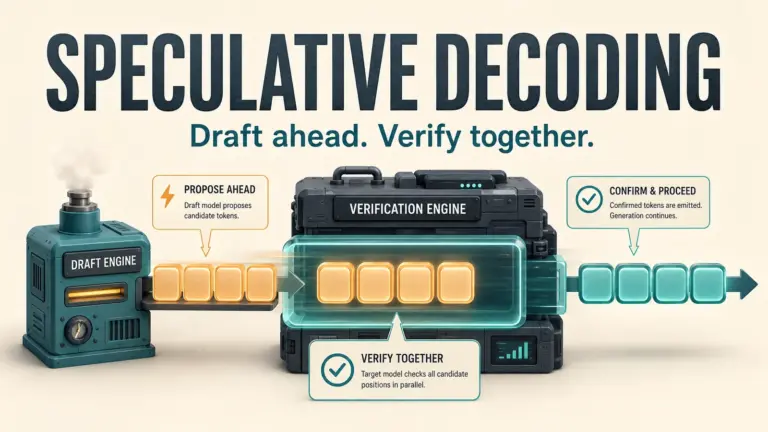
Speculative Decoding은 후보 토큰을 미리 만들고 큰 모델이 묶어서 검증해 순차 실행을 줄입니다. 정확한 확률 보정으로 목표 분포를 유지할 수 있지만, 가속 여부는 채택된 토큰 수와 초안 생성·검증 비용을 함께 측정해야 판단할 수 있습니다.
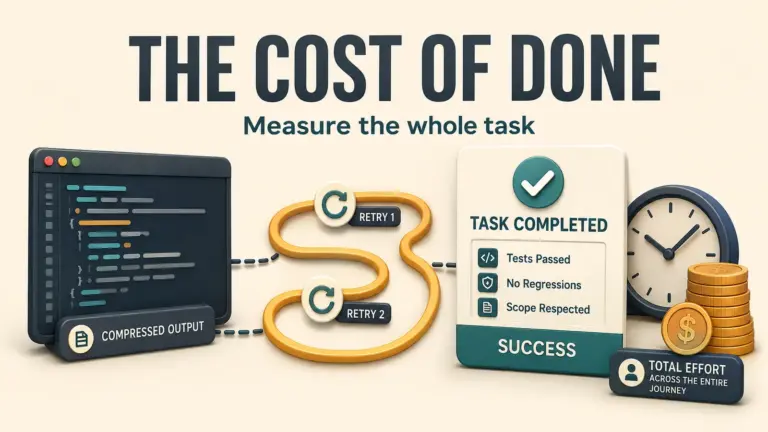
AI 코딩 에이전트의 효율은 재검색·재실행·추가 턴까지 포함해 작업 하나를 성공시키는 데 든 총비용과 시간으로 평가해야 합니다. 출력 압축으로 정보가 사라지면 짧아진 응답이 오히려 복구 작업을 늘릴 수 있습니다.
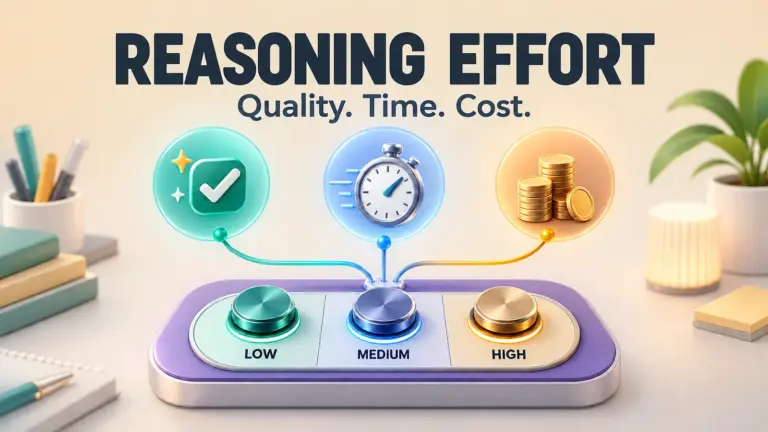
추론 수준은 업무의 성공률과 제한 시간 기준을 충족하는 설정 중 성공한 작업당 총비용이 낮은 것을 선택해야 합니다. Gemini 3.8 Flash의 공식 설정과 가격을 바탕으로 비교 실험을 설계하며, 자체 성능 실측 결과를 제시하는 글은 아닙니다.
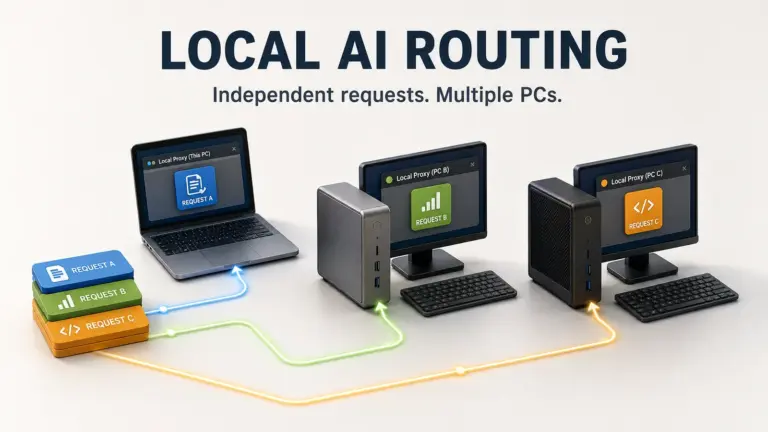
NVIDIA PAIR는 여러 PC의 GPU 메모리를 합치지 않고, 독립적인 추론 요청을 실행 가능한 노드에 나누어 보냅니다. 같은 모델을 처리할 장비와 동시에 실행할 요청이 충분할 때 대기 시간을 줄이는 데 유용합니다.
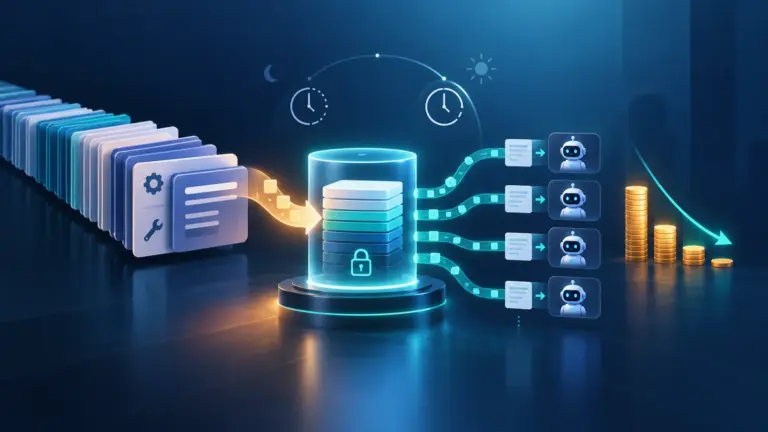
긴 시스템 지시와 tool definition을 TTL 안에서 정확히 재사용할 수 있다면 Claude Prompt Caching은 두세 번째 요청부터 반복 prefix의 입력 비용을 낮춥니다. 반대로 한 번뿐인 요청이거나 prefix가 매번 달라져 계속 miss한다면 그 prefix의 입력 비용이 오히려 1.25배에서 2배로 늘므로, 실제 usage 지표로 손익을 확인해야 합니다.
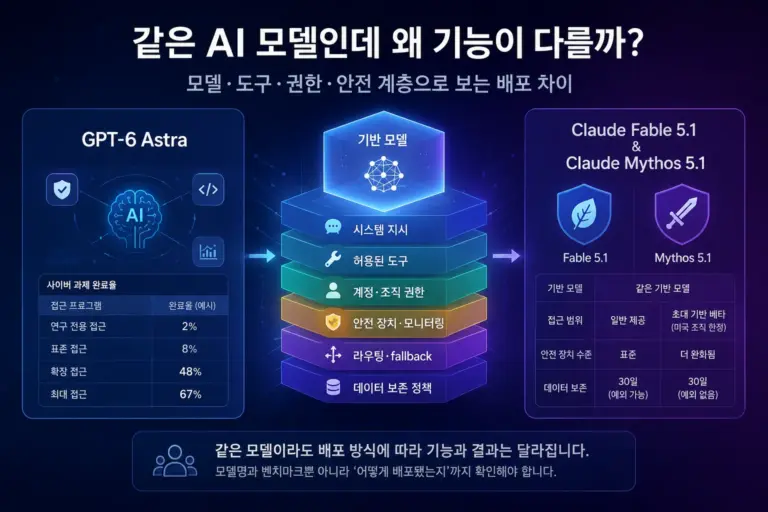
같은 이름이나 같은 기반 모델을 선택해도 실제 기능과 결과는 제품이 허용한 도구, 계정 권한, 시스템 지시, 안전 장치와 fallback 정책에 따라 달라집니다. 이제 AI를 비교할 때는 모델명과 벤치마크뿐 아니라 어떻게 배포됐는지까지 함께 기록해야 합니다.
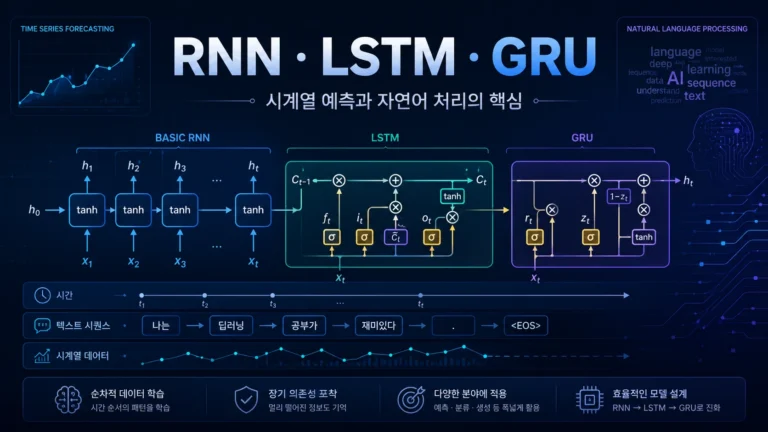
RNN은 이전 시점의 은닉 상태를 다음 시점으로 전달해 순서가 있는 데이터를 처리합니다. 이 글은 기본 RNN의 한계, LSTM과 GRU의 게이트 구조, 정확한 수식, 시계열 예측과 텍스트 분류 예제, 그리고 Transformer·상태공간모델 시대에도 순환 모델이 필요한 이유를 설명합니다.
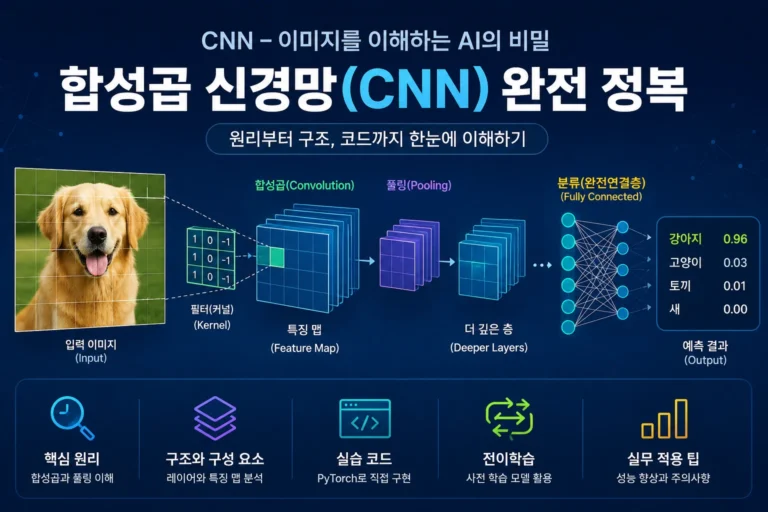
CNN은 이미지를 통째로 외우는 모델이 아니다. 작은 필터를 반복 적용해 엣지와 질감, 부분 형태, 객체 구조를 계층적으로 학습한다. 합성곱 계산부터 최신 CNN 설계와 전이학습 실전까지 한 번에 정리한다.
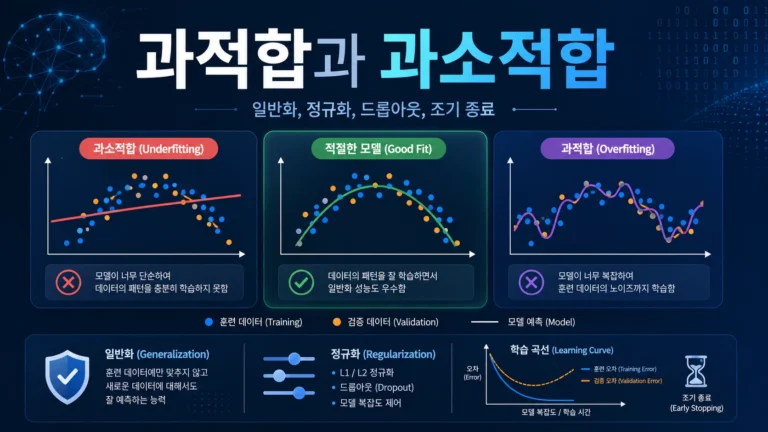
훈련 성능이 높다고 좋은 모델은 아닙니다. 과적합과 과소적합을 학습 곡선, 교차검증, 편향과 분산으로 진단하고 정규화·드롭아웃·조기 종료를 상황에 맞게 적용하는 방법을 정리합니다.
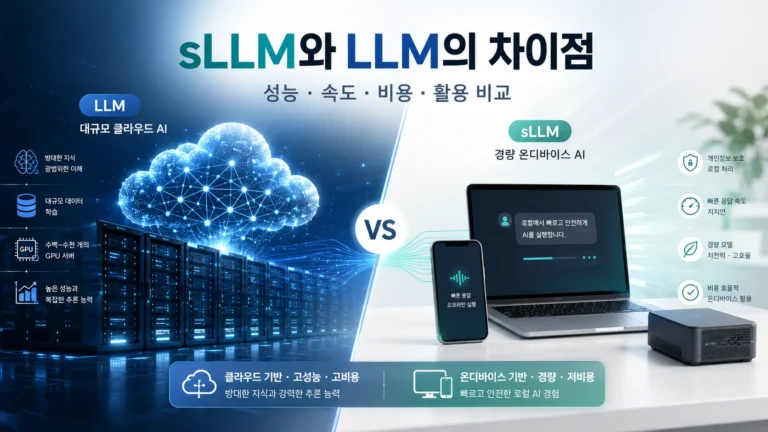
sLLM은 단순히 파라미터가 적은 LLM이 아닙니다. 처음부터 작은 구조로 학습한 모델, 대형 모델의 구조를 줄인 모델, 웨이트를 양자화한 모델을 구분하고 실제 기업과 개인이 sLLM을 선택하는 이유를 설명합니다.
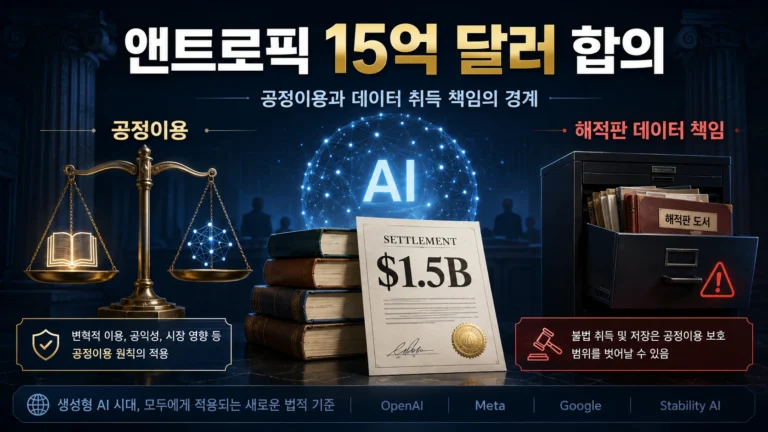
미국 연방법원이 앤트로픽과 작가·출판사 사이의 15억 달러 합의를 최종 승인했습니다. AI 학습의 공정 이용과 불법 데이터 취득을 분리한 법원의 논리, 다른 AI 기업의 진행 중 소송, 15억 달러가 업계 협상 기준이 될 가능성을 살펴봅니다.
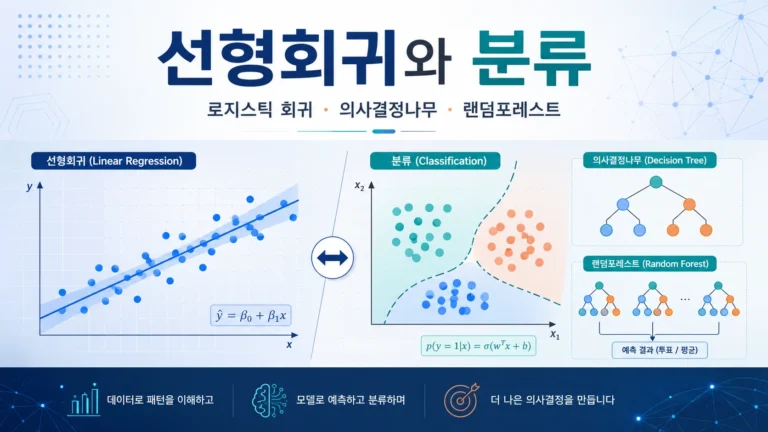
연속값을 예측하는 선형회귀부터 확률 기반 분류인 로지스틱 회귀, 규칙을 학습하는 의사결정나무, 여러 나무를 결합하는 랜덤포레스트까지 고전 머신러닝의 핵심을 실전 관점에서 정리합니다.
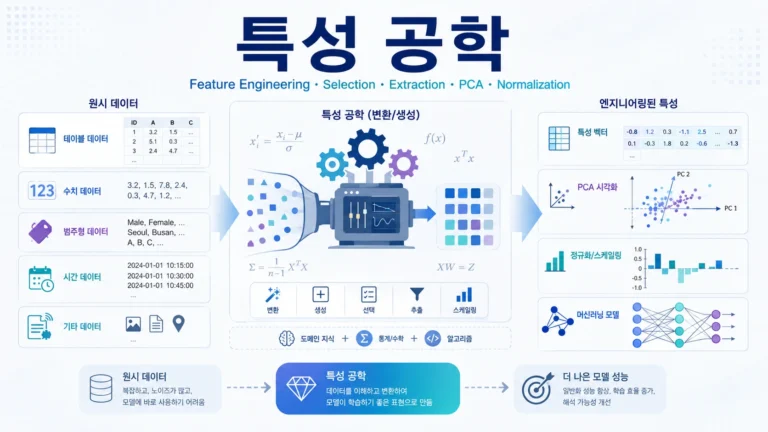
원시 데이터를 유용한 피처로 바꾸는 방법부터 특성 선택·특성 추출, 스케일링, PCA, 누수 방지와 운영 파이프라인까지 한 번에 설명합니다.
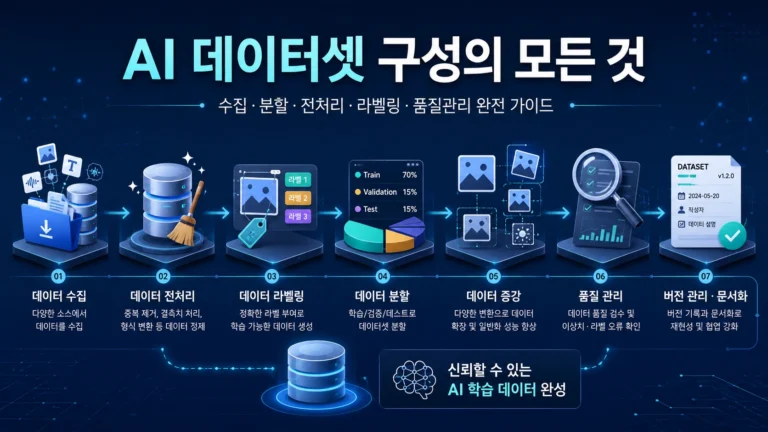
좋은 AI 모델은 좋은 데이터셋에서 시작됩니다. 이 글은 문제 정의와 데이터 수집부터 훈련·검증·테스트 분할, 데이터 누수와 중복 방지, 전처리, 라벨링, 클래스 불균형, 증강, 골든 세트, 문서화와 버전 관리까지 데이터셋 구축 전 과정을 실전 중심으로 정리합니다.

AI가 예측하고, 틀린 정도를 계산하고, 기울기를 구해 가중치를 바꾸는 전 과정을 한 번에 이해하는 모델 학습·최적화 실전 가이드입니다.
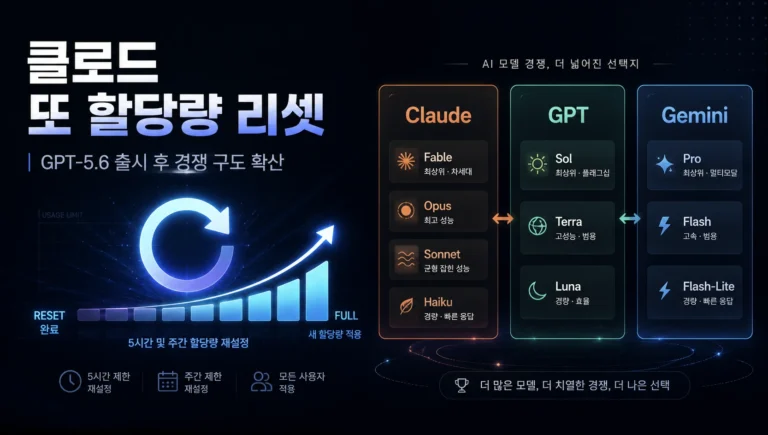
GPT-5.6 공개 직후 Anthropic이 Claude 사용량 한도를 연이어 초기화했다. 공식 사유는 공개되지 않았지만 경쟁 대응 가능성을 살펴보고, Claude·GPT·Gemini 최신 모델을 최상위·주력·경량 등급으로 나눠 비교한다.

손실함수는 모델이 어떤 실수를 더 크게 벌점 줄지 정의하는 학습 목표입니다. 주요 손실함수의 수식, 확률적 의미, 출력층 조합, 선택 기준, 구현 실수와 실전 코드를 한 번에 정리합니다.

높은 정확도가 좋은 모델을 뜻하지는 않습니다. 이 글은 회귀·분류·컴퓨터 비전·LLM·RAG·추천·이상 탐지·강화학습별 핵심 평가 지표와 임계값 설정, 확률 보정, 데이터 누수, 운영 성능까지 실전 관점에서 설명합니다.
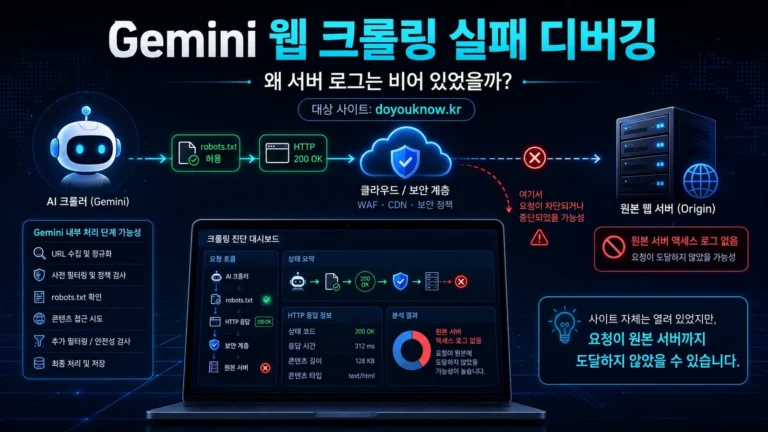
정상적으로 운영 중인 워드프레스 블로그를 Gemini가 보안 설정 때문에 읽을 수 없다고 답해 원인을 추적했습니다. robots.txt, Cloudflare, HTTP 헤더, HTML 메타 태그, Google Apps Script를 점검했지만 차단 근거는 발견되지 않았으며, 재현 테스트 중 원본 서버에도 요청이 도달하지 않았습니다. 이 글에서는 Gemini의 웹 접근 실패가 서버 차단보다 내부 처리 단계에서 발생했을 가능성과 Google-Extended를 둘러싼 잘못된 설명을 실제 로그와 공식 문서를 바탕으로 분석합니다.

코딩 몇 줄로 전국 50개 지역 1년치 태양광 데이터를 쓸어 담는 비법. 엑셀은 이제 그만! 기상청 관측-통계 묶음형 API 완전 정복 가이드.

기상청 평년값 API로 30년 기후 데이터를 파이썬으로 수집하고, LSTM 모델로 기후변화를 예측하세요. 이상기후 판단부터 AI 모델링까지 완벽 가이드!

기상청 API 허브의 [산업특화-에너지-태양광] 섹션, ‘지상관측데이터 일통계 조회서비스’를 활용해보세요! 데이터 수집부터 PyTorch LSTM 모델링까지 A to Z 가이드.

“내일 전기가 얼마나 생산될까?” 한국동서발전 공공데이터 API와 파이썬을 활용해 태양광 발전량을 예측하는 법! 코드 복사/붙여넣기로 1년치 데이터 수집부터 분석까지 완벽하게 정복하세요.

MIT가 개발한 LNN은 미분방정식 기반의 혁신 신경망. 시간 연속 처리로 LSTM보다 10배 작으면서 더 정확. 자율주행·의료진단·드론 제어에서 실시간 성능 극대화. 왜 AI 칩들은 LNN에 주목할까?

DPO vs RLHF 완벽 비교! RLHF 3단계 복잡성. Bradley-Terry 모델. DPO 수학적 유도: 보상 함수 역추출, 정규화 상수 소거! 암시적 보상: 정책이 자신의 로그비율로 보상 인코딩. 16배 빠름, 메모리 50% 절감! nrDPO·ADPO로 노이즈 대응. 미래: 온라인 DPO, 다중 목표 최적화까지!

왜 VGGNet은 여전히 딥러닝 교과서의 주인공일까요? 3×3 컨볼루션만으로 ImageNet을 뒤흔든 초심플 초딥 CNN 아키텍처를, 직관적 예시와 밈으로 풀어보는 완전 가이드. CNN 입문자부터 연구자까지 반드시 알아야 할 구조·훈련·전이학습 비밀을 한 번에 정리했습니다.

MLP 대체? KAN 완벽 해부! Kolmogorov-Arnold 정리 70년 역사. 고정→학습 활성화 함수. B-Spline 엣지 배치. 파라미터 90% 감소, 메모리 10배 절감! KAN 3B = MLP 10B. 과학 계산·TinyML 성공. 불규칙함수는 MLP 우수. 미래 Hybrid 아키텍처까지!

AI의 역사는 ‘과장된 약속 → 혹독한 겨울 → 하드웨어·데이터·알고리즘 삼박자의 혁신’이 반복된 이야기예요. 지금의 ChatGPT, Sora, DeepSeek-R1은 하늘에서 뚝 떨어진 기적이 아니라, 80년에 걸친 시행착오의 결과랍니다. 1. AI 역사의 큰 그림: 5단계로 보는 빅픽처 AI의 70~80년을 아주 거칠게 나누면 이렇게 다섯 단계로 나뉜답니다. 이제부터는 이 흐름을 연대기 + 핵심 논문·모델·서비스 + 시사점 중심으로 압축 정리하는…

Mamba \& 상태 공간 모델 완벽 가이드! Transformer O(N²) 극복, Mamba O(N) 달성. 선택적 스캔 메커니즘, 입력-종속 파라미터. 하드웨어 최적화: Kernel Fusion + Parallel Scan. 성능: 5배 빠름, 87.5% 메모리 절감. Mamba 3B = Transformer 6B! 비디오, 음성, 의료 멀티모달 확장. SSM의 미래까지!

기계적 해석성 완벽 가이드! 다의성(Polysemanticity) 문제와 중첩 가설. Sparse Autoencoder로 1600만 개 특징 추출! Golden Gate Bridge 사건: SAE로 모델 행동 직접 조종. Monosemanticity 달성, 인과 개입으로 미지의 개념 발견. Claude 3 뇌 지도, AI 안전의 미래까지!