LLM은 한 토큰씩 만드는데 어떻게 더 빨라질까? Speculative Decoding의 원리와 조건
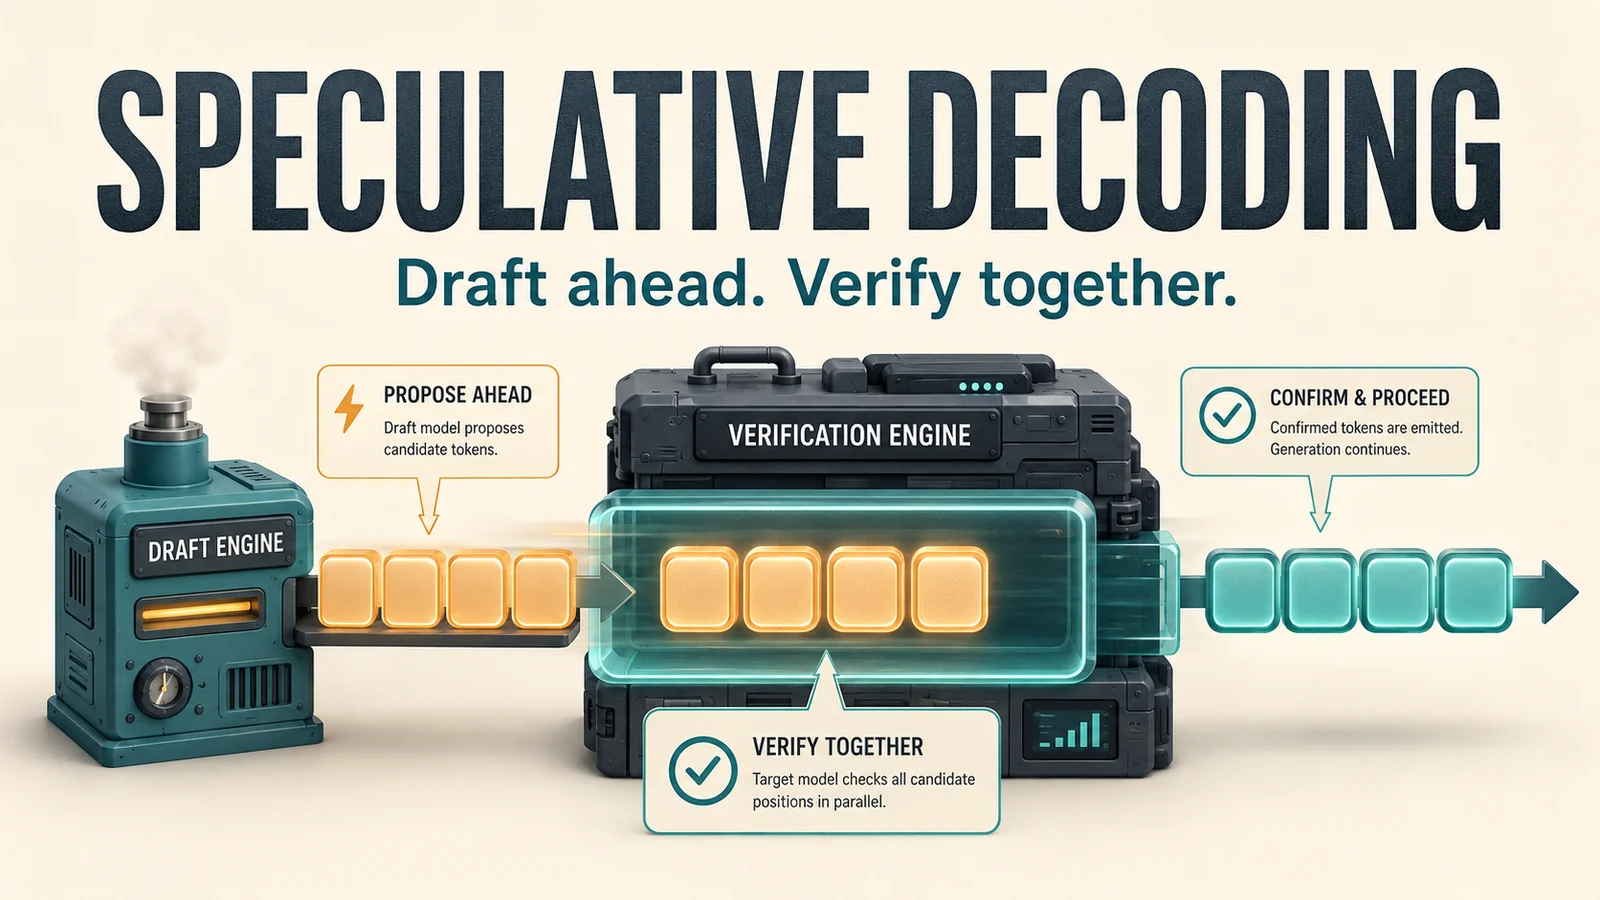
Speculative Decoding(추측 디코딩)은 후보 토큰을 미리 만든 뒤 큰 모델이 묶어서 검증해 순차 실행을 줄이는 기술입니다. 정확한 확률 보정 절차를 사용하면 목표 모델의 출력 분포를 유지할 수 있습니다. 다만 초안이 많이 채택돼도 초안을 만드는 시간이 길면 느려질 수 있으므로, 채택률과 실제 지연시간을 함께 봐야 합니다.
이 글은 한 요청 안에서 토큰을 생성하는 방법을 다룹니다. 여러 요청을 다른 GPU로 보내는 요청 분산과는 적용 위치가 다릅니다. 원리 설명은 작은 별도 모델이 초안을 만드는 방식부터 시작하고, 뒤에서 보조 모듈과 문자열 재사용 방식으로 범위를 넓힙니다.
자료 확인 기준은 2026년 9월 7일입니다. NVIDIA의 새 공동 설계 글은 공식 페이지에 2026년 9월 2일로 표시돼 있습니다. 여기서는 해당 제조사 해설을 초기 논문과 함께 읽고, 원리와 특정 구현의 권고를 구분합니다. GPU에서 직접 재현한 성능 결과를 제시하는 글은 아닙니다.
1. 토큰을 하나씩 만드는 과정에서 무엇을 줄일 수 있을까요?
자기회귀 생성(autoregressive generation)은 이미 나온 토큰에 조건을 걸어 다음 토큰을 만듭니다. 아직 결정되지 않은 앞 토큰을 건너뛰고 뒤 토큰부터 확정할 수는 없습니다. 하지만 앞 토큰을 가정한 후보열이 주어지면 각 위치의 조건부 확률을 함께 계산할 수 있습니다. 가정을 검증하는 계산과 그 결과를 최종 채택하는 판단은 구분해야 합니다.
flowchart LR
    A["입력 문맥"] --> B["후보 A를 가정"]
    B --> C["후보 A·B를 가정"]
    A --> V["각 가정의 다음 토큰 확률을 함께 계산"]
    B --> V
    C --> V
    V --> K["앞에서부터 채택 여부 결정"]
일반적인 작은 배치의 생성 단계에서는 계산량보다 가중치와 이전 상태를 읽는 메모리 대역폭이 병목이 될 수 있습니다. 검증할 위치를 여러 개 묶으면 읽어 온 가중치를 더 많은 계산에 사용할 여지가 생깁니다. 연산 자체를 없애기보다, 필요한 순차 실행과 메모리 접근의 부담을 줄이는 접근입니다. 계산 자원이 이미 꽉 찬 환경에서는 같은 이득을 기대하기 어렵습니다. Leviathan 등의 ICML 논문
입력 전체를 처리하는 prefill(입력 처리)과 이후 토큰을 이어 만드는 decode(토큰 생성)도 나눠 봐야 합니다. 긴 입력을 읽는 시간이 대부분인 요청은 decode만 빨라져도 전체 응답시간이 크게 줄지 않을 수 있습니다. 모델 규모와 실행 환경의 관계가 익숙하지 않다면 sLLM과 LLM의 차이를 먼저 읽어도 좋습니다.
2. 초안과 검증 사이에는 확률 보정이 필요합니다
초안 모델(draft model)은 빠르게 후보를 제안하고, 목표 모델(target model)은 최종적으로 유지하려는 분포를 제공합니다. 이후에는 각각 초안 모델, 목표 모델로만 부르겠습니다. 다음은 한 줄의 후보열을 사용하는 기본 절차입니다.
flowchart TD
    P["확정된 문맥"] --> D["초안 후보 D개 생성"]
    D --> V["목표 모델이 후보 위치들을 병렬 검증"]
    V --> A["앞에서부터 확률적으로 채택"]
    A --> Q{"첫 거절이 있는가?"}
    Q -->|"있음"| R["그 위치에서 보정 분포로 한 토큰 추출
뒤쪽 후보는 폐기"]
    Q -->|"없음"| B["목표 분포로 보너스 토큰 하나 추출"]
    R --> N["확정된 토큰을 문맥에 추가"]
    B --> N
    N --> P
확률을 이용해 출력하는 sampling(표본 추출)에서는 단순히 두 모델의 가장 높은 확률 토큰이 같은지만 비교하지 않습니다. 목표 확률을 p, 초안 확률을 q라고 두면 후보 x의 채택 확률은 min(1, p(x) / q(x))입니다. 처음 거절한 위치에서는 max(0, p - q)를 전체 토큰에 대해 정규화한 분포로 다시 뽑습니다. 이 보정이 목표 분포를 복원합니다. Leviathan 논문 Algorithm 1 및 부록 A.1
아래는 실제 모델의 출력이 아니라, 보정의 의미를 보여주는 두 토큰짜리 가상 분포입니다.
| 항목 | 토큰 A | 토큰 B |
|---|---|---|
초안 확률 q | 0.8 | 0.2 |
목표 확률 p | 0.5 | 0.5 |
| 후보로 나왔을 때 채택 확률 | 0.625 | 1 |
| 채택 경로로 최종 출력될 확률 | 0.5 | 0.2 |
| 거절 후 보정 경로로 추가되는 확률 | 0 | 0.3 |
| 최종 출력 확률 | 0.5 | 0.5 |
초안이 A를 지나치게 선호해도 그 일부를 거절하고 부족한 B 쪽 확률을 보충하면 목표 비율을 회복합니다. 이 예에서 거절 직후 목표 분포로 무조건 다시 뽑으면 A의 최종 확률은 0.5 + 0.3 × 0.5 = 0.65가 됩니다. 따라서 “틀리면 큰 모델로 다시 뽑는다”만으로는 알고리즘을 충분히 설명하지 못합니다.
같은 분포와 매번 같은 문자열은 다릅니다. 난수 사용 순서와 하드웨어 수치 오차가 달라지면 개별 출력은 달라질 수 있습니다. 정확한 보정의 보장을, 채택 기준을 완화한 모든 변형에 그대로 적용해서도 안 됩니다. Chen 등의 논문, 4.2절과 6.1절
3. 초안 길이와 채택 길이는 서로 다른 지표입니다
초안 길이 D는 한 번에 제안한 토큰 수입니다. 이 글에서는 채택 길이(acceptance length, AL)를 검증 한 회당 최종 확정한 평균 토큰 수로 정의합니다. 초안에서 채택한 토큰뿐 아니라 보정 또는 보너스 토큰 하나를 포함합니다. 이는 NVIDIA 공동 설계 글의 정의이며, 다른 도구의 같은 이름이 같은 분모·분자를 뜻하는지는 별도로 확인해야 합니다. NVIDIA 공동 설계 해설
D = 4인 기본 절차의 예 | 채택한 초안 토큰 | 보정 또는 보너스 | 이번 회의 확정 토큰 |
|---|---|---|---|
| 첫 후보에서 거절 | 0 | 1 | 1 |
| 두 후보 채택 후 거절 | 2 | 1 | 3 |
| 네 후보 모두 채택 | 4 | 1 | 5 |
표는 종료 토큰이나 출력 길이 제한으로 중간 종료하지 않는 경우입니다. “네 개를 제안했으니 네 배 빠르다”는 계산은 성립하지 않습니다. 평균적으로 몇 개를 확정했는지뿐 아니라, 그 회차에 걸린 시간도 필요합니다.
성능 기록에는 proposed_tokens, accepted_draft_tokens, emitted_tokens, verification_rounds를 따로 남기는 편이 명확합니다. 그러면 초안 채택률은 accepted_draft_tokens / proposed_tokens, 이 글의 AL은 emitted_tokens / verification_rounds로 집계할 수 있습니다. 종료 처리로 버린 토큰을 포함하는지도 함께 정합니다.
예를 들어 가상의 계산 예시에서 기존 방식이 토큰당 10ms, 새 방식이 회차당 평균 3토큰을 24ms에 확정한다면 토큰당 시간은 8ms이고 속도 향상은 1.25배입니다. 같은 3토큰을 확정하는 데 초안 비용이 늘어 36ms가 걸리면 12ms가 되어 오히려 느립니다. 채택 길이가 같아도 결론이 바뀝니다.
4. 초안을 길게 만들면 왜 다시 느려질까요?
더 긴 초안은 초안 생성 시간, 검증 연산, 임시 상태 관리 비용을 늘립니다. 앞 후보에서 거절되면 뒤 후보에 쓴 계산을 활용하지 못합니다. 배치와 문맥 길이가 달라지면 이 비용의 비중도 달라집니다.
flowchart LR
    D["초안 길이 증가"] --> G["더 많은 토큰을 확정할 기회"]
    D --> O["초안 생성·검증 비용 증가"]
    D --> W["거절 뒤 후보 계산 낭비"]
    G --> M["실제 토큰당 시간 비교"]
    O --> M
    W --> M
    M --> S["요청 조건별 길이 선택"]
KV cache(키·값 캐시)는 앞선 토큰의 attention(어텐션) 계산에 필요한 상태를 보존합니다. 외부 초안 모델의 가중치와 상태까지 얹으면 목표 모델의 배치에 쓸 메모리 여유가 줄어들 수 있습니다. 반대로 동일한 앞 문맥을 검증 위치들이 재사용하는 이점도 있습니다. “초안이 길면 KV cache가 무조건 같은 비율로 늘어난다”처럼 단순화할 수는 없습니다.
NVIDIA 글의 D = 128 / G - 1 권고는 query head들이 KV head를 공유하는 수 G와, 분석한 attention 커널의 타일 조건을 전제로 한 출발점입니다. 모든 GPU·커널·모델에 적용되는 정답이 아닙니다. NVIDIA의 attention 성능 조건 설명
초기 Chen 연구의 수치도 조건을 붙여 읽어야 합니다. 목표 Chinchilla 70B, 초안 4B, TPU v4 16개, 배치 1, 초안 길이 4에서 보고한 decode 결과는 다음과 같습니다. 추출 방식은 XSum이 top-p = 0.8, HumanEval이 top-p = 0.95와 temperature = 0.8입니다. 여기서 nucleus sampling은 확률이 높은 쪽부터 누적 확률 top-p까지만 후보로 두고 뽑는 방식이고, greedy는 매번 가장 높은 확률의 토큰만 고르는 방식입니다. Chen 논문 Table 1과 6절
| 작업과 생성 방식 | 기존 평균 토큰 시간 | 제안 방식 | 보고된 속도 향상 |
|---|---|---|---|
| XSum 요약, nucleus sampling | 14.1ms | 7.52ms | 1.92배 |
| XSum 요약, greedy | 14.1ms | 7.00ms | 2.01배 |
| HumanEval 코드, nucleus sampling | 14.1ms | 5.73ms | 2.46배 |
속도 향상 열은 논문이 보고한 값이라, 같은 표의 시간값을 그대로 나눈 비율과 소수점에서 조금 다릅니다. 이것은 해당 연구의 결과이며 현재 GPU 서버의 예상 성능표가 아닙니다. 동일 논문에서도 초안 길이를 늘릴 때 이득이 정체되거나 줄어드는 경우가 나타났습니다. 하드웨어를 고를 때처럼 메모리·연산·통신을 함께 봐야 한다는 점은 AI 하드웨어 비교 글과도 연결됩니다.
5. 후보를 만드는 방법부터 비교해야 합니다
작은 별도 LLM만 후보를 만들 수 있는 것은 아닙니다. 목표 모델 내부의 정보를 쓰거나, 문맥의 반복 패턴을 재사용할 수도 있습니다. 아래는 방식의 구조를 구분하기 위한 표이며, 모든 엔진에서 지원한다는 호환성 표는 아닙니다.
| 방식 | 후보 생성의 재료와 방식 | 도입 전에 확인할 비용 |
|---|---|---|
| 외부 초안 모델 | 별도 LLM으로 후보를 순차 생성 | 추가 가중치·KV cache와 실행 시간 |
| EAGLE-3 | 목표 모델의 내부 표현을 보조 모듈에 전달 | 목표 체크포인트에 맞춘 모듈과 학습 |
| MTP(Multi-Token Prediction) | 목표 모델에 결합된 미래 토큰 예측 모듈 활용 | 체크포인트의 모듈 제공·훈련 여부 |
| DFlash | 목표 모델 정보를 이용해 후보 블록을 병렬 생성 | 보조 모듈의 학습과 블록 생성 비용 |
| DSpark | 병렬 후보 생성 뒤 가벼운 순차 보정 | 보조 모듈과 추가 보정 비용 |
| suffix·n-gram | 토큰열에서 반복 문자열을 찾아 재사용 | 실제 입력의 반복성, 탐색 구현 비용 |
비교의 근거는 NVIDIA 공동 설계 글의 방식 비교와 EAGLE-3 구조 해설입니다. self-speculative라는 표현은 문서마다 범위가 다를 수 있으므로, 별도 모델이 없는지뿐 아니라 실제로 어떤 층·모듈·상태를 쓰는지 확인해야 합니다.
이 표로부터 도입 순서를 정해 볼 수 있습니다. 이미 호환 모듈이 있다면 그것을 첫 비교 대상으로 삼고, 없으면 새로 학습할 비용과 기존 외부 모델을 얹는 비용을 비교합니다. 반복적인 출력이 많은 작업에는 문자열 재사용도 후보가 됩니다. 어느 경우든 새 체크포인트로 바꾼 뒤에는 이전 채택률을 그대로 성능 예측에 넣지 않는 편이 타당합니다.
6. 실제 서버에서는 무엇을 측정할까요?
vLLM이나 TensorRT-LLM으로 평가할 때도 기준은 동일한 서비스 조건에서 기존 생성 방식보다 유리한가입니다. 기능을 켤 수 있는지는 출발 조건이고, 운영상 이득은 별도의 측정 문제입니다.
flowchart TD
    B["동일 모델·요청 집합으로 기준 성능 측정"] --> C["호환되는 초안 방식 선택"]
    C --> D["초안 길이·문맥 길이·동시 요청 수를 나눠 측정"]
    D --> Q["출력 검증과 오류·종료 처리 확인"]
    Q --> M["사용자 지연시간·처리량·메모리 비교"]
    M --> R{"목표 서비스 기준을 충족하는가?"}
    R -->|"예"| A["해당 조건에서 적용 후보"]
    R -->|"아니요"| N["설정 재조정 또는 기존 방식 유지"]
다음 표는 실험을 설계할 때 사용할 수 있는 측정 항목입니다. 같은 측정 프로그램과 지표 정의를 두 설정에 적용해야 합니다.
| 지표 | 이 글에서 사용할 정의 | 함께 기록할 조건 |
|---|---|---|
| TTFT(time to first token, 첫 토큰 수신 시간) | 요청 시작부터 첫 토큰 수신까지 | 대기열·네트워크 포함 여부, prefill 길이 |
| ITL(inter-token latency, 토큰 간 지연시간) | 스트리밍에서 연속 토큰 수신 사이 간격 | 여러 토큰을 한 묶음으로 보내는 처리 방식 |
| 요청 완료시간 | 요청 시작부터 종료까지 | 입력·출력 길이, 취소·실패율 |
| 처리량 | 측정 구간의 최종 출력 토큰 수/초 | 동시 요청 수와 지연시간 제한 |
초안 채택률·AL | 앞 절에서 정한 원시 카운터로 계산 | 종료 토큰·출력 제한의 집계 방식 |
| 메모리와 비용 | 목표·초안 모델을 합친 사용량 | GPU 수, 실행 시간, 모듈 준비 비용 |
ITL은 내부 검증 단계 시간과 다릅니다. 서버가 한 번에 확정한 토큰을 묶어서 전송하면 사용자에게 보이는 간격은 버퍼링의 영향도 받습니다. 평균 하나에 의존하지 말고 요청 완료시간과 TTFT의 중앙값·상위 백분위도 나란히 기록하는 것이 좋습니다.
실험은 먼저 같은 목표 체크포인트, 토크나이저, 정밀도, sampling 설정, 출력 제한을 고정하고 시작합니다. 코드와 요약처럼 실제 사용할 요청을 나누고, 짧은 문맥과 긴 문맥, 적은 요청과 많은 요청을 각각 비교합니다. 예열과 반복 순서도 두 설정에 같은 기준을 적용합니다. SPEED-Bench 같은 공개 평가 자료는 공통 비교에 유용하지만, 자체 요청을 대체하는 보장은 없습니다.
현재 지원 방식과 측정 옵션은 vLLM의 Speculative Decoding 문서 및 TensorRT-LLM의 성능 측정 안내에서 실행할 버전에 맞춰 확인해야 합니다. 이 글에서는 특정 GPU에서 검증하지 않은 실행 명령을 제시하지 않습니다.
최종 선택은 단순합니다. 초안이 잘 맞는다는 이유만으로 적용하지 않고, 품질 조건을 지키면서 필요한 지연시간 또는 처리량을 개선하는 설정을 남깁니다. 더 많은 후보를 검증한 횟수보다 사용자가 실제로 받은 결과와 비용이 중요합니다.
참고자료
- NVIDIA: Co-Designing AI Models Using Speculative Decoding for Faster LLM Inference — 2026년 9월 2일 공식 기술 해설.
- NVIDIA: An Introduction to Speculative Decoding for Reducing Latency in AI Inference — 2025년 9월 17일 입문 해설.
- Chen 등: Accelerating Large Language Model Decoding with Speculative Sampling — 분포 보정과 Chinchilla 실험 원논문.
- Leviathan 등: Fast Inference from Transformers via Speculative Decoding — ICML 2023, 알고리즘과 시간·연산 비용 분석.