LLM 추론 수준은 어떻게 정할까? Gemini 3.8 Flash의 성공률·시간·비용
추론 수준을 높여도 모든 작업의 품질이 좋아지는 것은 아니므로, 실제 업무의 성공률과 제한 시간 기준을 충족하는 설정 중 성공한 작업당 총비용이 낮은 것을 선택해야 합니다. 낮은 설정으로 여러 번 실패하는 것보다 높은 설정으로 한 번에 끝내는 편이 저렴할 수도 있습니다. 반대로 간단한 분류에 불필요한 추론을 쓰면 품질 이득 없이 기다리는 시간만 늘어날 수 있습니다.
이 글은 Gemini 3.8 Flash를 사례로 설정 방법과 평가 설계를 설명합니다. 공식 문서와 가격의 확인일은 2026년 9월 6일이며, 유료 API를 실행해 얻은 자체 성능 비교 결과는 포함하지 않습니다. 아래 요청 예제와 결과 집계 코드를 자신의 업무 데이터에 적용해 판단하는 것이 목적입니다.
추론 수준은 모델 교체와 무엇이 다를까요?
추론 수준(reasoning effort)은 같은 모델에 요청하면서 추론에 들일 노력을 조절하는 설정입니다. 모델 이름을 바꾸는 것과 달리 같은 모델 안에서 비교할 수 있지만, 수준 하나가 고정된 생각 토큰 수나 실행 시간을 보장하는 것은 아닙니다.
Google이 2026년 9월 2일 발표한 Gemini 3.8 Flash는 복잡한 작업에서 추가 추론과 반복적인 도구 호출을 수행하도록 설계됐습니다. Google은 특히 높은 설정에서 토큰을 더 사용할 수 있다고 설명합니다. 이는 제조사의 설계 설명이며, 모든 요청에서 high가 더 정확하거나 도구를 더 많이 호출한다는 보장은 아닙니다. Google 발표
| 바꾸는 항목 | 비교에서 달라지는 것 | 같은 것으로 가정하면 안 되는 것 |
|---|---|---|
| 모델 ID | 모델 자체의 능력과 지원 기능 | 모델별 high가 같은 계산량이라는 가정 |
| 추론 수준 | 같은 모델의 추론 노력 설정 | 정확한 토큰 수·도구 호출 횟수·시간 |
| 출력 제한 | 생성에 허용하는 길이의 상한 | 같은 상한이면 모든 설정이 충분히 답한다는 가정 |
| 도구 권한 | 검색·코드 실행 등 수행 가능한 행동 | 모델의 추론 수준과 도구 접근 범위가 같다는 가정 |
같은 모델이라도 배포 경로와 도구·권한 구성에 따라 실제로 할 수 있는 일이 달라집니다. 이 차이는 같은 AI 모델인데 왜 기능이 다를까에서 따로 정리했습니다.
Gemini 3.8 Flash는 low, medium, high를 지원하고 기본값은 medium입니다. minimal은 지원하지 않습니다. 다른 Gemini 모델에서 쓰던 설정을 이름만 바꿔 옮기면 안 되는 이유입니다. Thinking 설정 문서
짧은 답변도 비용이 커질 수 있는 이유
사용자가 보는 답변 길이만으로 요금을 추정하면 생각 토큰(thinking tokens)을 놓칩니다. 생각 토큰은 최종 답변을 생성하는 과정의 토큰이며, Gemini 3.8 Flash에서는 출력 요금으로 과금됩니다. 짧은 최종 답변이 나와도 그 전에 생성한 생각 토큰이 많을 수 있습니다.
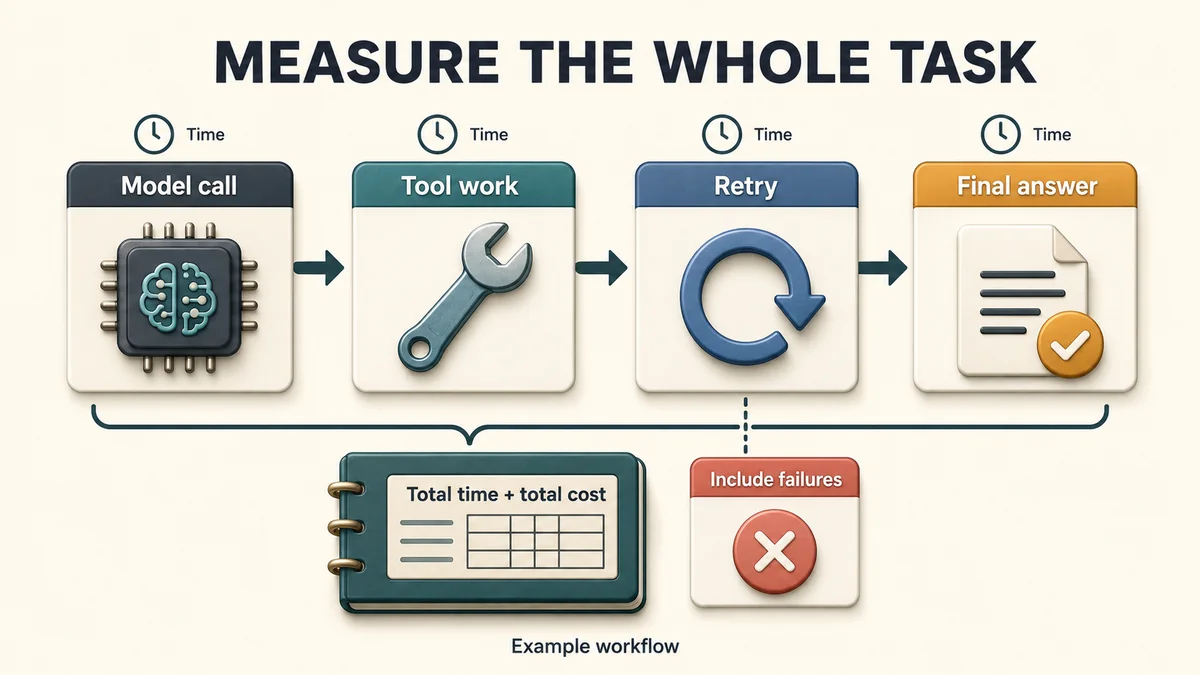
최종 응답 한 번의 사용량이 아니라, 실패한 시도와 도구 실행까지 포함한 작업 전체를 집계합니다.
다음은 Gemini Developer API의 유료 Standard 요금입니다. 단위는 미국 달러이며, 각각 100만 토큰당 가격입니다. Batch·Flex 요금, cache(캐시) 입력·저장 요금, 별도 도구 요금을 이 표에 섞지 않았습니다. 공식 가격표
| 적용 기간 | 입력 | 출력·생각 토큰 |
|---|---|---|
| 2026년 12월 31일까지 | $0.75 | $3.75 |
| 2027년 1월 1일부터 예정 | $1.50 | $7.50 |
cache 할인과 별도 도구 요금이 없는 단순 요청이라면 모델 비용 계산은 다음과 같습니다. billed_output_tokens는 생각 토큰을 이미 포함하도록 정규화한 값입니다.
model_cost_usd = (
    input_tokens * input_price_per_million
    + billed_output_tokens * output_price_per_million
) / 1_000_000
하지만 에이전트(agent)는 한 번의 모델 응답으로 끝나지 않을 수 있습니다. 첫 응답에서 도구를 요청하고, 도구 결과를 다시 입력받아 검토하고, 실패하면 재시도합니다. 이때 비교해야 할 비용은 작업 종료까지 발생한 모든 모델 호출과 도구 실행 비용의 합계입니다. 도구 실행과 모델의 반복 관계가 낯설다면 AI Agent 가이드를 먼저 참고하셔도 좋습니다.
높은 설정의 첫 호출 비용이 늘어도 재시도가 줄어 총비용이 낮아질 수 있고, 반대 결과도 가능합니다. 어느 쪽인지는 같은 과제에서 측정해야 합니다.
Gemini API와 OpenAI 호환 API의 설정 위치
Gemini의 Interactions API와 OpenAI 호환 API는 추론 수준을 지정하는 필드가 다릅니다. 하나의 요청에 두 방식을 함께 넣지 말고, 현재 사용하는 API에 맞춰 설정합니다.
| 요청 방식 | 요청 경로 | 추론 수준 필드 |
|---|---|---|
| Gemini Interactions API | /v1beta/interactions | generation_config.thinking_level |
| OpenAI 호환 Chat Completions | /v1beta/openai/chat/completions | reasoning_effort |
아래는 Bash와 curl에서 실행하는 최소 요청 예제입니다. 해당 API를 사용할 수 있는 키를 GEMINI_API_KEY 환경 변수로 준비해야 합니다. 실행하면 API 요청이 발생하며 사용 조건에 따라 요금이 부과됩니다. 설정 형식을 보여 주는 코드로, 완성된 평가 수집기는 아닙니다.
Interactions API에서는 다음처럼 지정합니다. 공식 Thinking 요청 예제
curl --fail-with-body \
  'https://generativelanguage.googleapis.com/v1beta/interactions' \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-3.8-flash",
    "input": "17과 29의 곱을 숫자만으로 답하세요.",
    "generation_config": {"thinking_level": "medium"}
  }'
OpenAI 호환 API에서는 reasoning_effort만 바꿔 세 수준을 호출할 수 있습니다. 아래 순서는 문법 확인용입니다. 실제 비교에서는 뒤에서 설명하는 대로 과제별 실행 순서를 섞습니다. 공식 OpenAI 호환 문서
for effort in low medium high; do
  curl --fail-with-body \
    'https://generativelanguage.googleapis.com/v1beta/openai/chat/completions' \
    -H "Authorization: Bearer $GEMINI_API_KEY" \
    -H 'Content-Type: application/json' \
    -d "{
      \"model\": \"gemini-3.8-flash\",
      \"reasoning_effort\": \"$effort\",
      \"messages\": [{\"role\": \"user\", \"content\": \"17과 29의 곱을 숫자만으로 답하세요.\"}]
    }" > "response-$effort.json" || break
done
호환 문서는 reasoning_effort와 별도의 thinking_level·thinking_budget을 동시에 사용하지 말라고 명시합니다. 또한 “OpenAI 호환”을 응답 필드의 세부 의미까지 모든 서비스와 동일하다는 뜻으로 해석하지 않아야 합니다. OpenAI 호환 문서의 설정 주의사항
비교 전에 성공과 제한 시간을 정합니다
“어느 답이 더 좋아 보이는가”만으로는 운영 설정을 정하기 어렵습니다. HTTP 응답을 정상 수신했더라도 답이 틀리거나, 필수 필드가 빠졌거나, 사용자가 기다릴 수 있는 시간을 넘겼다면 업무를 성공했다고 볼 수 없습니다.
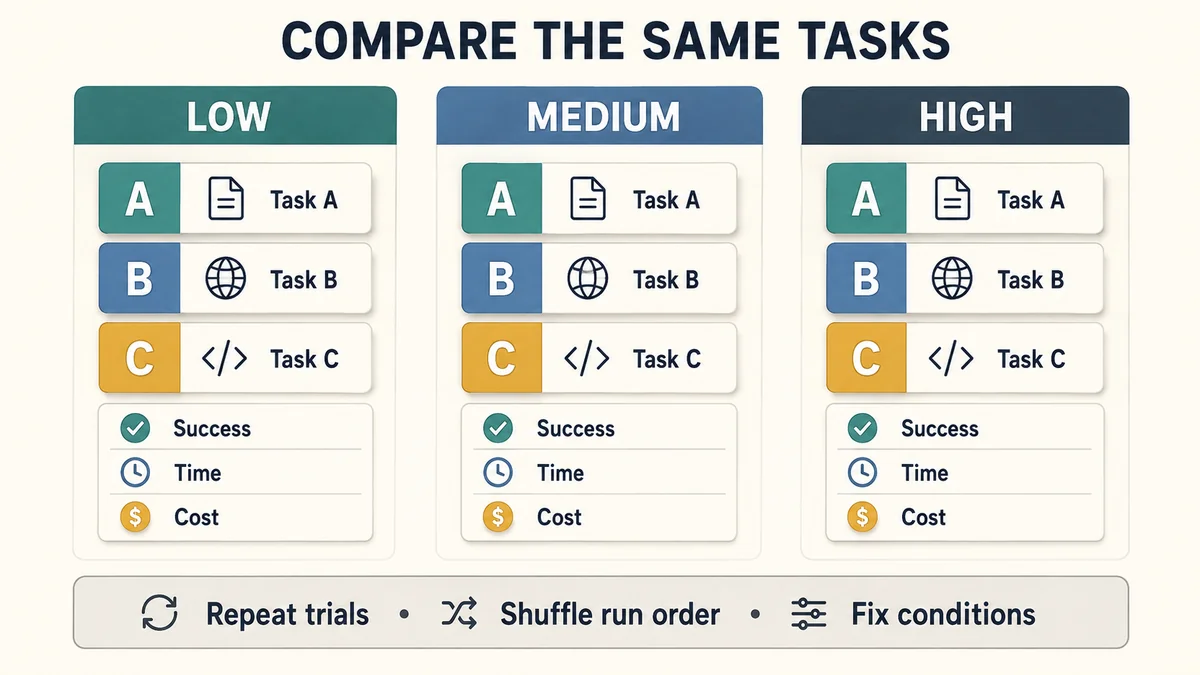
세 설정에 같은 과제와 평가 기준을 적용하고, 도구·지시문·출력 제한을 고정한 채 실행 순서만 섞습니다.
먼저 과제 유형에 맞는 채점 기준을 정합니다. 정답을 기계적으로 확인하기 어려운 작업은 추론 수준을 가린 상태에서 같은 평가표로 판정합니다. 모델을 평가자로 쓰는 경우에도 평가 모델과 평가 지시문을 고정하고 일부 표본을 사람이 대조해야 합니다. 지표 자체의 개념은 AI 모델 성능 평가 지표 가이드와 연결해서 보시면 좋습니다.
| 평가 요소 | 기록할 내용 | 방지하는 오류 |
|---|---|---|
| 업무 성공 | 정답·필수 조건·테스트 통과 여부 | 정상 응답을 성공으로 세기 |
| 제한 시간 내 성공 | 업무 성공과 제한 시간 기준을 모두 충족 | 너무 늦은 정답을 실시간 서비스 성공으로 세기 |
| 실패 유형 | 오답·형식 오류·도구 오류·출력 잘림·시간 초과 | 서로 다른 원인을 추론 부족으로 묶기 |
| 과제와 반복 | 같은 과제 ID를 세 수준에서 여러 번 실행 | 쉬운 과제가 많은 설정에 유리한 비교 |
| 실행 조건 | 모델·지시문·출력 상한·도구·재시도·cache 조건 | 설정 외 차이를 추론 수준의 효과로 오인 |
같은 과제 묶음을 low, medium, high에 모두 적용하고 각 과제를 반복합니다. 과제마다 수준의 실행 순서를 섞으면 특정 시간대의 서버 지연이 한 수준에만 몰리는 영향을 줄일 수 있습니다. 반복 횟수와 과제 수는 결과를 본 뒤 유리하게 바꾸지 말고 사전에 정합니다.
cache 설정을 고정하더라도 실행 순서에 따라 실제 적중률이 달라질 수 있으므로, 적용된 할인과 관련 사용량도 기록합니다. cache가 반복 요청의 비용을 어떻게 바꾸는지는 Claude API의 Prompt Caching 비용 계산에서 따로 다뤘습니다. 도구를 쓰는 과제라면 같은 외부 데이터나 고정된 응답 자료를 제공하는 비교와, 실제 서비스 환경의 비교를 나누면 결과 해석이 쉬워집니다.
전체 경과 시간(wall-clock time)은 첫 요청 직전부터 최종 성공 또는 실패 판정까지 잽니다. 모델 응답 시간뿐 아니라 도구 실행과 재시도 대기도 포함합니다. 이 값은 중앙값인 p50과 느린 쪽 꼬리를 보여 주는 p95를 함께 보고, 성공한 실행만 골라 계산하지 않습니다.
토큰 집계에서 가장 조심할 것은 중복과 누락입니다
실제 응답은 원본 그대로 보관하고, 그다음 비교에 쓸 공통 필드로 정규화합니다. 응답에 없는 수치를 0으로 채우면 측정하지 못한 사용량이 무료였던 것처럼 보이므로, 알 수 없는 값은 null로 남깁니다.
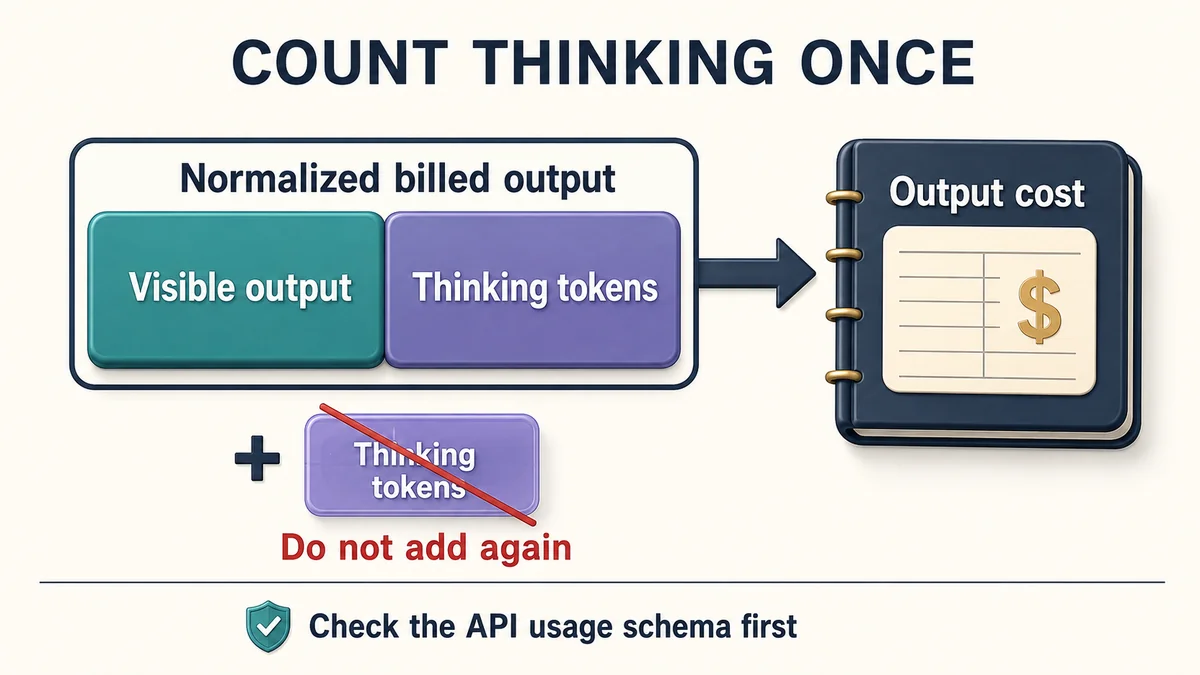
과금 대상 출력량에 생각 토큰을 포함시킨 뒤에는 다시 더하지 않습니다. 원본 응답의 합산 방식은 API별 필드 정의부터 확인합니다.
Interactions API의 현재 Thinking 문서는 total_output_tokens와 total_thought_tokens를 구분하고, 출력 요금은 두 토큰 수의 합에 적용한다고 설명합니다. 따라서 이 API의 문서화된 정의에서는 두 값을 더해 과금 대상 출력량을 만듭니다. 이 계산을 다른 API의 비슷한 이름을 가진 필드에 그대로 적용하면 안 됩니다. Thinking 문서의 가격·사용량 설명
| 집계용 필드 | 의미 | 주의할 점 |
|---|---|---|
input_tokens | 호출의 입력 토큰 | cache 입력이 있다면 가격 계산용 세부량도 별도로 보존 |
billed_output_tokens | 생각 토큰을 포함한 과금 대상 출력 토큰 | 생각 토큰을 다시 더하지 않음 |
thinking_tokens | 확인 가능한 생각 토큰 부분량 | 없으면 null, 출력 비용 계산에 재합산하지 않음 |
tool_calls | 실제 실행한 도구 호출 수 | 모델의 도구 제안과 실행 기록을 구분 |
cost_usd | 해당 호출·시도에 귀속한 모델·도구 비용 | 요금 적용이 불명확하면 null |
OpenAI 호환 경로를 쓴다면 원본 usage와 실제 응답 스키마를 확인해 변환기를 만들어야 합니다. 특정 SDK가 제공하는 생각 토큰 필드가 Gemini 호환 응답에서도 항상 존재한다고 가정하지 않습니다. 토큰 수를 모두 확보하더라도 별도 도구 요금과 cache 요금을 누락하면 작업 총비용이 되지 않습니다.
생각 토큰 수가 많다고 논리적 사고 단계가 그만큼 늘었다고 계산할 수도 없습니다. 사용량은 자원 측정값이며, 내부 추론 과정을 완전히 관찰하는 기록은 아닙니다.
평가 결과를 작업 단위로 집계하는 코드
아래 집계 예제는 API를 호출하지 않는 오프라인 집계기입니다. Python 3.11 이상에서 표준 라이브러리만 사용합니다. API 응답 수집, 정답 판정, 도구 실행 기록, 요금 적용은 사용 중인 서비스에 맞춰 먼저 수행해야 합니다.
입력은 한 줄에 JSON 객체 하나를 쓰는 task-results.jsonl입니다. 한 행은 특정 추론 수준에서 수행한 과제 한 번의 전체 결과입니다. 같은 과제를 반복한 횟수는 trial로 구분하고, 그 실행에서 발생한 모든 모델 호출·실패 시도는 attempts에 넣습니다. 도구 비용을 각 시도에 귀속할 때는 한 번만 계산합니다.
| 입력 항목 | 저장 기준 |
|---|---|
effort, task_id, trial | 수준·과제·반복 실행을 식별하는 조합 |
success | 미리 정한 업무 채점 기준의 통과 여부 |
wall_seconds | 도구와 재시도 대기를 포함한 과제 전체 경과 시간 |
attempts | 성공 전에 실패한 호출까지 포함한 모든 시도 |
다음은 입력 형식만 설명하는 가상 행이며 Gemini 실측값이 아닙니다. 요금을 확인하지 못했다는 상황을 표현하려고 cost_usd를 null로 두었습니다.
{"effort":"low","task_id":"format-example","trial":1,"success":false,"wall_seconds":4.2,"attempts":[{"cost_usd":null,"input_tokens":100,"billed_output_tokens":700,"thinking_tokens":500,"tool_calls":0}]}
집계기 전체 코드는 다음과 같습니다. benchmark.py로 저장한 뒤 결과 파일과 같은 디렉터리에 둡니다.
"""Aggregate normalized task results; never calls an API or invents token prices.

Python 3.11+, standard library only. One JSONL row per complete task trial:
{"effort":"low","task_id":"case-1","trial":1,"success":true,
 "wall_seconds":4.2,"attempts":[{"cost_usd":0.003,"input_tokens":100,
 "billed_output_tokens":700,"thinking_tokens":500,"tool_calls":0}]}

cost_usd includes the attempt's model and tool charges; use null when unknown.
billed_output_tokens already includes thinking tokens. thinking_tokens is an
optional diagnostic subset and is NEVER added again. Attempts include failures.
wall_seconds spans the whole task, including tools, retries, and backoff.
Fixtures demonstrate arithmetic only; they are not Gemini performance results.
"""

import argparse
import json
import math
from collections import defaultdict
from pathlib import Path


def nonnegative(value, name):
    if isinstance(value, bool) or not isinstance(value, (int, float)):
        raise ValueError(f"{name} must be a number")
    if not math.isfinite(value) or value < 0:
        raise ValueError(f"{name} must be finite and nonnegative")
    return value


def percentile(values, q):
    """Nearest-rank percentile, not interpolation."""
    ordered = sorted(values)
    return ordered[max(0, math.ceil(q * len(ordered)) - 1)]


def summarize(rows, deadline_seconds):
    nonnegative(deadline_seconds, "deadline_seconds")
    groups = defaultdict(list)
    seen = set()
    for row in rows:
        if row.get("effort") not in ("low", "medium", "high"):
            raise ValueError("effort must be low, medium, or high")
        if not isinstance(row.get("task_id"), str) or not row["task_id"]:
            raise ValueError("task_id must be a nonempty string")
        if type(row.get("trial")) is not int or row["trial"] < 1:
            raise ValueError("trial must be a positive integer")
        key = (row["effort"], row["task_id"], row["trial"])
        if key in seen:
            raise ValueError(f"duplicate task trial: {key}")
        seen.add(key)
        if type(row.get("success")) is not bool:
            raise ValueError("success must be boolean, decided by your grader")
        nonnegative(row["wall_seconds"], "wall_seconds")
        attempts = row.get("attempts")
        if not isinstance(attempts, list) or not attempts:
            raise ValueError("attempts must contain every charged or attempted call")
        for attempt in attempts:
            if not isinstance(attempt, dict) or "cost_usd" not in attempt:
                raise ValueError("each attempt needs cost_usd (null if unknown)")
            if attempt["cost_usd"] is not None:
                nonnegative(attempt["cost_usd"], "cost_usd")
            for field in ("input_tokens", "billed_output_tokens", "thinking_tokens", "tool_calls"):
                value = attempt.get(field)
                if value is not None and (type(value) is not int or value < 0):
                    raise ValueError(f"{field} must be a nonnegative integer or null")
            think, output = attempt.get("thinking_tokens"), attempt.get("billed_output_tokens")
            if think is not None and output is not None and think > output:
                raise ValueError("thinking_tokens cannot exceed billed_output_tokens")
        groups[row["effort"]].append(row)
    if not groups:
        raise ValueError("no results")
    sets = [{(r["task_id"], r["trial"]) for r in rs} for rs in groups.values()]
    comparable = len(groups) == 3 and all(s == sets[0] for s in sets)
    report = {"same_task_trials_all_three_efforts": comparable,
              "deadline_seconds": deadline_seconds, "by_effort": {}}
    for effort, trials in groups.items():
        attempts = [a for r in trials for a in r["attempts"]]
        known_cost = sum(a["cost_usd"] for a in attempts if a["cost_usd"] is not None)
        unknown = sum(a["cost_usd"] is None for a in attempts)
        successes = sum(r["success"] for r in trials)
        on_time = sum(r["success"] and r["wall_seconds"] <= deadline_seconds for r in trials)
        times = [r["wall_seconds"] for r in trials]
        totals = {}
        for field in ("input_tokens", "billed_output_tokens", "thinking_tokens", "tool_calls"):
            values = [a.get(field) for a in attempts]
            totals[field] = None if any(v is None for v in values) else sum(values)
        report["by_effort"][effort] = {
            "task_trials": len(trials), "attempts": len(attempts),
            "successes": successes, "success_rate": successes / len(trials),
            "on_time_successes": on_time, "on_time_success_rate": on_time / len(trials),
            "wall_p50_seconds": percentile(times, 0.50),
            "wall_p95_seconds": percentile(times, 0.95),
            "known_cost_usd": known_cost, "unknown_cost_attempts": unknown,
            "total_cost_usd": None if unknown else known_cost,
            "cost_per_success_usd": known_cost / successes if successes and not unknown else None,
            "cost_per_on_time_success_usd": known_cost / on_time if on_time and not unknown else None,
            "token_and_tool_totals": totals,
        }
    return report


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("results", type=Path, help="normalized task-results JSONL")
    parser.add_argument("--deadline-seconds", type=float, required=True)
    args = parser.parse_args()
    with args.results.open(encoding="utf-8") as source:
        rows = [json.loads(line) for line in source if line.strip()]
    print(json.dumps(summarize(rows, args.deadline_seconds), ensure_ascii=False, indent=2, allow_nan=False))


if __name__ == "__main__":
    main()
실행은 아래 한 줄입니다. 30초는 명령 예시이므로 실제 서비스의 제한 시간으로 바꿉니다.
python benchmark.py task-results.jsonl --deadline-seconds 30
출력은 JSON 한 덩어리입니다. 다음은 위의 가상 행 하나만 넣고 실행했을 때의 출력이며, 역시 Gemini 실측값이 아닙니다.
{
  "same_task_trials_all_three_efforts": false,
  "deadline_seconds": 30.0,
  "by_effort": {
    "low": {
      "task_trials": 1,
      "attempts": 1,
      "successes": 0,
      "success_rate": 0.0,
      "on_time_successes": 0,
      "on_time_success_rate": 0.0,
      "wall_p50_seconds": 4.2,
      "wall_p95_seconds": 4.2,
      "known_cost_usd": 0,
      "unknown_cost_attempts": 1,
      "total_cost_usd": null,
      "cost_per_success_usd": null,
      "cost_per_on_time_success_usd": null,
      "token_and_tool_totals": {
        "input_tokens": 100,
        "billed_output_tokens": 700,
        "thinking_tokens": 500,
        "tool_calls": 0
      }
    }
  }
}
집계기는 수준별 성공률, 제한 시간 내 성공률, 전체 비용, 성공한 작업당 비용, p50·p95를 계산합니다. p50·p95는 모든 과제 실행의 전체 경과 시간을 정렬한 뒤 보간 없이 순위로 고르는 nearest-rank(최근접 순위) 방식으로 구합니다. 표본이 적으면 p95가 거의 최대값에 해당하므로 표본 수와 함께 읽어야 합니다.
위 출력에서 known_cost_usd가 0인데도 total_cost_usd와 cost_per_success_usd는 null입니다. 확인된 비용의 합계가 0달러라는 뜻이지 실제 비용이 0이라는 뜻이 아니며, 비용을 확인하지 못한 시도가 unknown_cost_attempts에 남아 있기 때문입니다. 성공한 작업당 비용의 분자에는 끝내 실패한 과제와 성공 전에 실패한 시도의 비용도 포함하고, 성공 건수가 0이면 이 값도 null이 됩니다. 여기서 null은 비용이 낮다는 뜻이 아니라 비교에 필요한 정보가 부족하다는 뜻입니다.
same_task_trials_all_three_efforts는 세 수준에 같은 과제·반복 조합이 들어왔는지 확인합니다. 위 출력에서 false인 것은 low 한 수준의 행만 넣었기 때문입니다. 값이 false이면 우선 입력 누락이나 실험 설계를 점검합니다. true여도 지시문·도구·서버 상태까지 같았다는 보증은 아니므로 실행 설정 기록이 필요합니다.
이 집계기는 실패한 시도의 비용 합산, 비용 미확인 처리, 성공 0건, 제한 시간을 넘긴 성공, 세 수준의 과제 조합 대조, 중복 행과 잘못된 입력의 거부라는 여섯 가지 경계 사례를 Python 3.11에서 오프라인으로 확인했습니다. 집계 산술과 입력 검증을 확인한 것이며 Gemini의 성능을 검증한 것은 아닙니다.
결과를 읽고 업무별 설정을 고르는 순서
먼저 필요한 성공률과 제한 시간 내 성공률을 통과하지 못한 설정을 제외합니다. 남은 설정에서 성공한 작업당 비용과 p95를 비교합니다. 비용 차이가 작고 실패의 영향이 큰 업무라면 성공률이 더 안정적인 설정을 선택하는 판단도 가능합니다.
성공률 차이가 작고 과제 수와 반복 횟수가 적다면 그 차이는 표본 변동일 수 있습니다. 같은 묶음을 다시 실행했을 때 순위가 유지되는지 확인하고, 유지되지 않으면 과제나 반복을 늘린 뒤 다시 비교합니다.
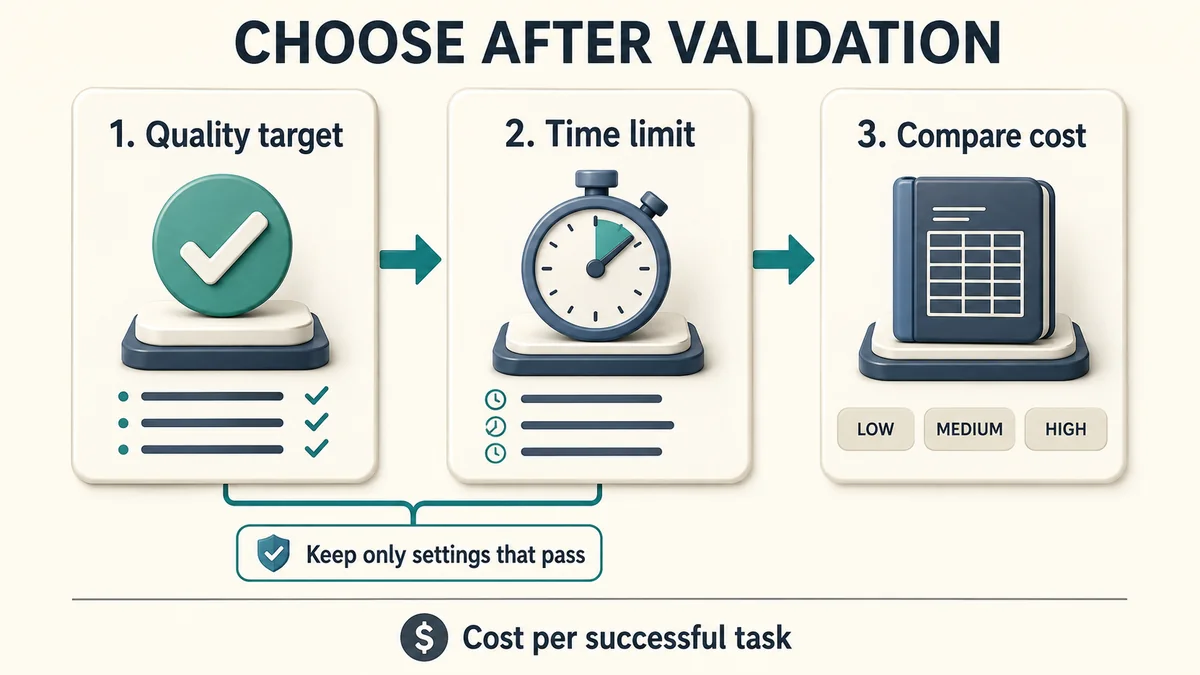
업무 이름만으로 low·medium·high 중 하나를 정답처럼 고정하지 않고, 기준을 통과한 설정만 남겨 비용을 비교합니다.
아래는 정답표가 아니라 첫 실험에서 검증할 가설입니다. 업무 이름만으로 수준을 고정하지 않고 실제 결과에 따라 올리거나 내립니다.
| 업무 유형 | 첫 비교 가설 | 수준을 바꾸기 전에 확인할 것 |
|---|---|---|
| 짧은 분류·정해진 형식 추출 | low로도 성공 기준을 충족하는지 확인 | 지시문·입력 자료 부족으로 인한 실패인지 |
| 여러 조건을 고려하는 일반 작업 | medium을 기준으로 양쪽 비교 | 높은 설정이 실패·재시도를 실제로 줄이는지 |
| 복잡한 코딩·수학·다단계 계획 | high에서 추가 비용에 맞는 성공률 이득이 있는지 확인 | 테스트·검증 기준이 충분한지 |
| 응답 시간에 민감한 대화 | 제한 시간 내 성공률을 먼저 비교 | 첫 출력 시간과 최종 완료 시간을 혼동했는지 |
모든 수준에서 비슷하게 실패하면 추론 수준이 원인이 아닐 수 있습니다. 필요한 자료가 없거나 도구 권한이 막혀 있거나, 출력 제한 때문에 답이 잘린 상황부터 확인합니다. 높은 설정이 이런 문제를 자동으로 해결하지는 않습니다.
운영 설정에는 모델 ID와 추론 수준뿐 아니라 지시문 버전, 출력 상한, 도구 권한, 재시도 정책, 요금 기준일도 함께 남깁니다. 기본값을 생략하지 않아야 이후 비교에서 무엇이 바뀌었는지 추적하기 쉽습니다. 모델이나 가격, 업무 분포가 달라졌을 때 같은 평가 묶음으로 다시 검증할 수 있도록 원본 응답과 채점 근거를 보존합니다.
참고한 공식 자료
- Gemini 3.8 Flash 발표 — Google: 발표일과 추가 추론·도구 사용에 관한 제조사 설명입니다.
- Gemini Thinking 문서: 지원 수준, 기본값, Interactions API 설정과 생각 토큰 과금을 확인했습니다.
- Gemini API OpenAI 호환 문서: 요청 경로와
reasoning_effort설정을 확인했습니다. - Gemini API 가격표: Standard 가격과 예정 변경일을 확인했습니다.