시험지로 AI 커닝을 막을 수 있을까? 숨은 지시문과 적대적 입력의 원리와 한계
시험지에 사람 눈에 잘 띄지 않는 지시문이나 무늬를 넣어 AI가 틀리거나 답을 거부하게 만드는 방법은 제한된 실험에서 일부 효과를 보였지만 아직 실제 시험에서 검증되지는 않았습니다. 효과는 모델과 입력 방식에 따라 크게 달랐습니다. 2026년 8월 독일 연구에서는 시험 문항 이미지에 적대적 섭동(adversarial perturbation)을 넣은 뒤에도 AI의 데이터셋별 평균 정답률이 90.36-96.04%였고, 이 장치는 여러 문항의 답을 모아 분석했을 때 AI 답을 그대로 옮긴 답안을 사후에 가려낼 가능성을 보였을 뿐입니다. 수능 직전 공개된 숭실대 연구팀의 예비 실험에서는 그래프 무늬가 소형 공개 모델을 속였지만 상용 Claude 모델 2종에는 통하지 않았고, 연한 글씨로 적은 거짓 정답은 소형 모델에만 시험했습니다. 시행 중인 시험이라는 안내문을 넣자 상용 모델은 12회 중 7회 거절하거나 되물었지만, 다른 환경의 14회에서는 한 번도 거절하지 않았습니다. 이번 수능과 세무사 시험에서 부정행위를 드러낸 것은 감독관의 관찰과 기기 통제, 당사자의 시인이었습니다.
이 글은 2026년 11월 19일 치러진 2027학년도 대학수학능력시험(수능)에서 스마트안경을 소지한 수험생이 적발돼 입건된 일을 출발점으로 삼습니다. 사건 정보는 2026년 11월 20일까지의 보도와 교육부 발표를 전한 보도로 확인한 것이며, 수사와 처분은 아직 진행 중입니다. 시험지 방어 기법은 원리와 연구 결과, 한계까지만 설명합니다. 특정 모델을 겨냥한 문구나 AI를 속이는 무늬를 만드는 절차는 다루지 않습니다.
AI가 쓴 답에 보이지 않는 통계적 표식을 남기는 출력 워터마크(output watermark)도 Claude·ChatGPT·Gemini에서 쓰이기 시작했습니다. 하지만 수능처럼 답만 옮겨 적는 시험에는 쓸모가 없고, 글쓰기 과제에서도 단독 증거가 되지 못합니다.
사람이 대수롭지 않게 여기는 입력 변화가 시스템의 판단을 바꾸는 현상은 자율주행 차량의 표지판 인식과 얼굴 인식, 웹을 읽고 행동하는 AI 에이전트에서도 관찰됐습니다. 다만 피해로 이어지는 경로는 다릅니다. 시각 인식에서는 표지판이나 얼굴 같은 단서를 잘못 분류하고, 에이전트에서는 지시와 데이터가 충분히 분리되지 않아 신뢰할 수 없는 외부 내용이 모델의 판단과 도구 호출에 끼어듭니다.
수능과 세무사 시험에서 확인된 사실
AI를 이용한 시험 부정행위가 국내에서 문제로 떠오른 것은 2026년 가을입니다. 대학 논술시험과 중·고교 시험에서 스마트안경 사례가 먼저 나왔고, 11월 중순에는 국가자격시험인 세무사 시험의 수석 합격자가 생성형 AI를 이용한 부정행위를 스스로 밝혔습니다. 수능 당일에는 스마트안경을 소지한 수험생이 적발돼 경찰에 입건됐습니다.
| 시험 | 기기·수법 | 드러난 방식 | 현재 상태(2026-11-20 확인) |
|---|---|---|---|
| 서울시립대 논술(10월 3일) | 신분 확인 때 일반 안경, 시험 중 스마트안경으로 교체 | 감독 중 적발 | 3년간 대학 입학시험 응시 제한 |
| 연세대 논술(11월) | 같은 방식 | 감독 중 적발 | 불합격 처리, 응시 자격 정지·형사 고발 검토 |
| 전국 중·고교 시험(2026년) | 스마트안경 4건 | 3명은 안경을 반복해 만지다, 1명은 시험 중 교체하다 적발 | 4명 모두 0점 처리 |
| 제63회 세무사 시험(1차 4월, 2차 7월) | 초소형 카메라·모니터와 스마트폰의 생성형 AI를 이용해 답을 받았다고 시인 | 감독 단계에서는 잡히지 않았고, 당사자가 11월 15일 유튜브 방송과 자수서로 시인 | 위계에 의한 공무집행방해·업무방해 혐의로 경찰 수사, 한국산업인력공단이 고소하고 다른 국가자격시험 전수조사 |
| 2027학년도 수능(11월 19일) | 스마트안경, 초소형 카메라·무선 이어폰, 휴대전화 촬영 등 | 감독관 확인, 미제출 휴대전화를 찾기 위한 위급재난문자 | 전자기기 관련 부정행위 111건, 이 중 시험 중 실제 활용 5건. 평가원 심의 후 12월 11일 성적 발표 전 처분 |
세무사 시험 사건은 감독이 무엇을 놓쳤는지 보여 줍니다. 머니투데이 보도에 따르면 이 시험은 휴대전화를 걷지 않고 전원을 끈 뒤 가방에 넣게 했고, 시험실에는 CCTV가 없었습니다. 공단은 11월 13일 감독위원 4명을 조사해 특이사항이 없다고 밝혔다가, 이틀 뒤 당사자가 직접 시인하면서 감독 공백이 드러났습니다. 당사자는 3월 공인회계사 1차 시험에서도 같은 수법을 시도했다고 밝혔고, 그 시험에는 불합격했습니다. 경찰은 제출받은 카메라·노트북·휴대전화를 포렌식 분석하면서 조력자가 있었는지도 확인하고 있습니다.
수능 사례 가운데 스마트안경 건은 충남 천안 시험장에서 나왔습니다. 서울경제 보도에 따르면 20세 졸업생 수험생이 2교시 수학 시험 중 화장실을 두 번 다녀오고, 풀이 과정 없이 답을 적고, 안경을 자주 만졌습니다. 감독관이 안경을 달라고 하자 일반 뿔테 안경을 냈고, 동의를 받아 소지품을 확인하자 스마트안경이 나왔습니다. 감독관은 오후 1시 56분쯤 경찰에 신고했습니다. 교육부는 이 건을 시험 중 실제로 기기를 활용한 5건에 넣었고, 충남교육청에 따르면 이 수험생은 수학 시험 중 스마트안경을 사용했다고 감독관에게 인정했습니다. 경찰은 위계에 의한 공무집행방해 혐의로 입건해 조사한 뒤 귀가시켰고, 증거물을 분석해 구체적인 경위와 조력자가 있었는지를 확인하고 있습니다. 스마트안경을 어떤 방식으로 썼는지는 아직 밝혀지지 않았습니다. 같은 날 경기 용인 시험장에서는 옷 속에 초소형 카메라를 숨기고 무선 이어폰을 낀 수험생이 적발됐습니다.
11월 20일 교육부 발표를 전한 경향신문 보도에 따르면 최종 집계에서 위급재난문자를 세 차례 보내 숨긴 휴대전화를 찾아낸 것이 54건, 그와 별개로 적발한 것이 52건, 시험 중 실제로 기기를 쓴 것이 5건입니다. 전날 발표한 98건은 4교시까지의 잠정 집계였습니다. 재난문자를 수능 부정행위 적발에 쓴 것은 이번이 처음입니다.
교육 당국은 시험 직전부터 대책을 내놓았습니다. 시험장마다 스마트안경 판별 전담 인력을 1명씩 두고, 수험생 안경을 전수 확인하고, 초소형 카메라를 막으려고 옷 단추에 스티커를 붙이게 했습니다. 스마트안경은 반입 금지 물품으로 명시돼 착용하거나 사용하면 그 시험이 무효가 되고 다음 해 응시 자격도 정지됩니다. 전파 탐지기 도입은 내년 시험부터 검토하고 있습니다. 국회에서는 AI 부정행위자의 수능 응시 자격 제한을 1년에서 10년으로 늘리는 고등교육법 개정안과, 공공 시험·입학시험·자격 검정의 AI 부정행위를 벌금 없이 징역형으로 처벌하는 형법 개정안이 논의되고 있습니다.
보도된 적발 경위를 보면 단서는 사람의 관찰과 기기 통제, 그리고 당사자의 시인이었습니다. 안경을 반복해 만지는 행동, 풀이 없이 적은 답, 숨긴 휴대전화를 울린 재난문자가 그 예입니다. 여러 방어 수단의 효과를 비교해 측정한 결과는 아니며, 이번 수능과 세무사 시험에서 시험지 장치가 적발에 쓰였다는 보도는 확인되지 않았습니다.
시험지 쪽에서 쓸 수 있는 방법은 네 갈래입니다
부정행위의 흐름을 단계로 나누면 시험지 방어가 어디에 작용하는지 보입니다. 카메라가 시험지를 찍고, 그 이미지를 OCR(광학 문자 인식)로 글자로 바꾸거나 VLM(시각 언어 모델, vision-language model)에 그대로 넣고, 모델이 답을 만들어 수험생에게 돌려보냅니다. 시험지에 심는 장치는 이 가운데 “이미지가 모델에 들어가는 단계”만 노립니다.
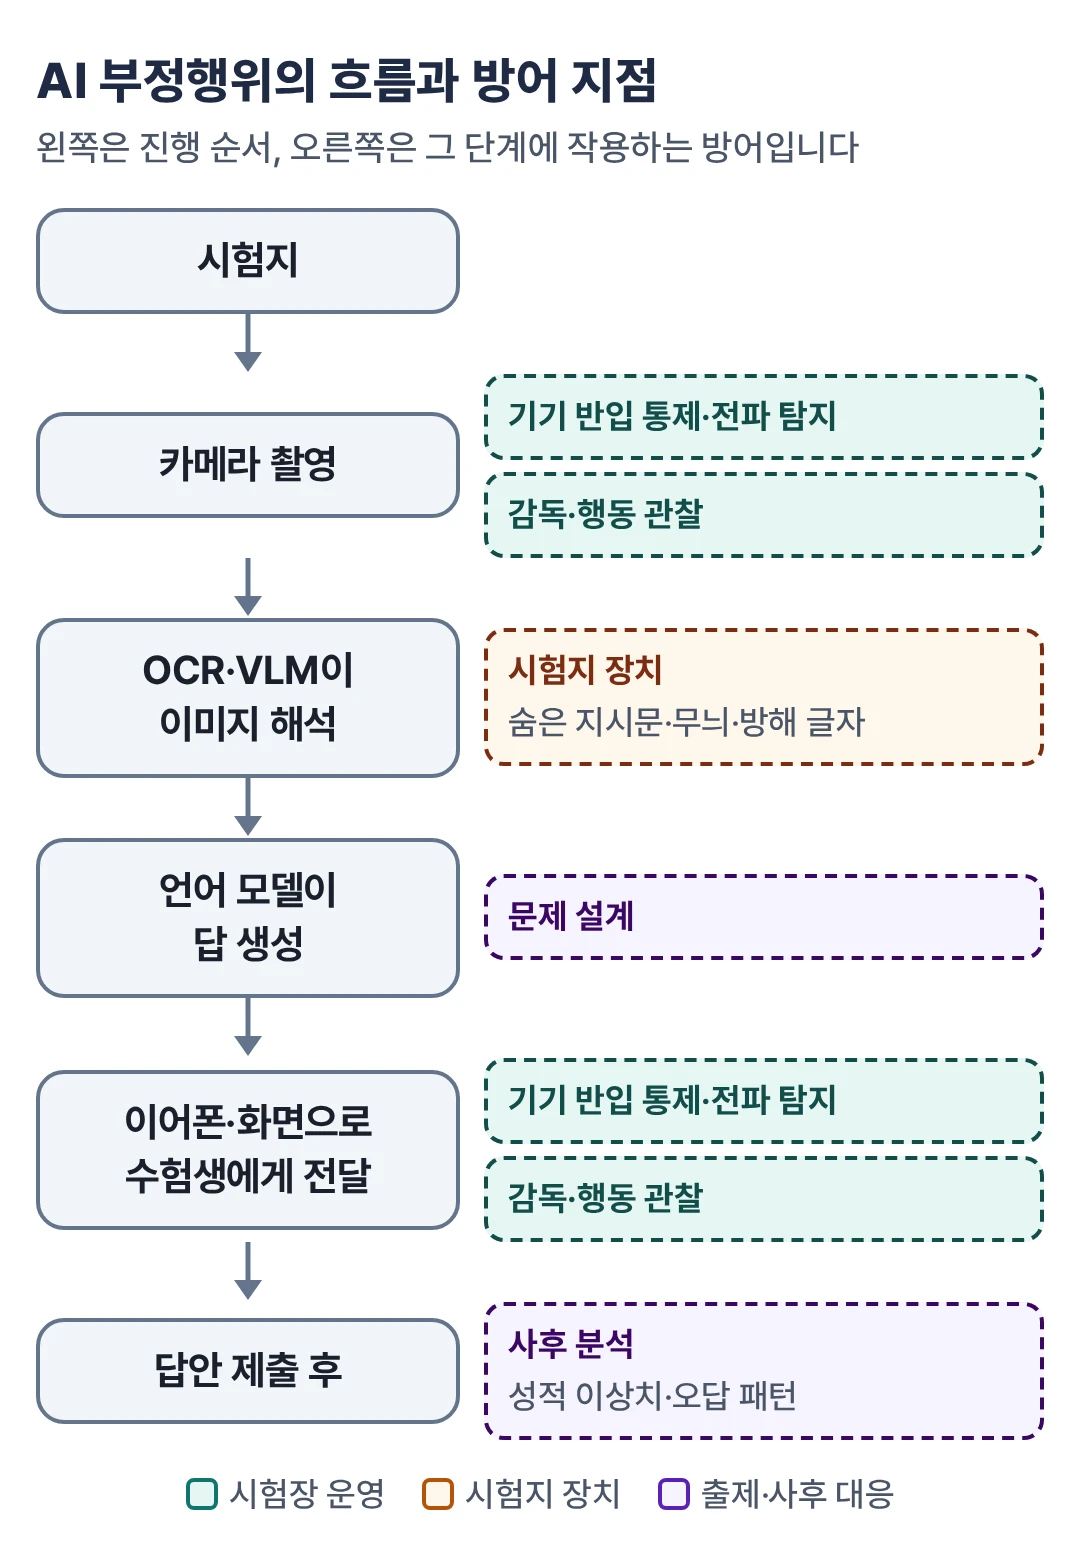
시험지에 넣을 수 있는 장치는 크게 네 가지로 나눌 수 있습니다.
| 방법 | 노리는 것 | 원리 | 연구·사례 근거 |
|---|---|---|---|
| 숨은 지시문 | 언어 모델의 지시 따르기 | 사람은 못 보거나 지나칠 만큼 작고 흐린 글씨로 모델에게 보내는 지시 | 논문 속 숨은 심사 지시(2025), PDF 시험지 보호 시스템(2026), AI 브라우저 스크린샷 공격(2025), 숭실대 예비 실험(2026, 소형 모델) |
| 거부 유도 | 모델의 안전 정책 | 시험이 진행 중이고 AI 도움은 부정행위라는 안내로 모델이 스스로 풀이를 멈추기를 기대하는 방식 | 숭실대 예비 실험(2026, 상용 모델 12회 중 7회 거절·되묻기, 다른 환경 14회 중 0회). 동료 심사를 거친 연구는 아직 없음 |
| 적대적 섭동 | 시각 인식 신경망 | 사람 눈에는 거의 같은 이미지에 더한, 모델 판단을 바꾸도록 계산된 미세한 변화 | 인쇄·촬영 실험(2016), 상용 챗봇 대상 전이 공격(2023), 시험 문항 보호 실험(2026), 숭실대 예비 실험(2026, 소형 모델만) |
| 방해 글자·무늬 | OCR과 이미지 분류 | 모델이 다른 것을 읽게 만드는 엉뚱한 글자, 배경 무늬, 워터마크 | CLIP(이미지와 글을 함께 학습한 OpenAI 모델) 분석 연구(2021) |
수능 직전 나온 국내 예비 실험
이 네 갈래 가운데 세 가지를 국내에서 직접 시험해 본 결과가 수능 직전에 공개됐습니다. 숭실대 AI안전성연구센터(센터장 최대선 정보보호학과 교수)가 11월 16일 작성한 기술 메모를 센터장 SNS에 요약해 올렸고, 한겨레·지디넷코리아·KBS 등이 보도했습니다. 연구진 스스로 “초기 실험 결과”라고 밝힌 예비 실험이며, 동료 심사를 거친 논문은 아닙니다. 중앙일보 보도에 따르면 연구팀은 추가 실험을 거쳐 12월 중 논문으로 발표할 계획입니다.
| 방식 | 대상 모델 | 보도된 결과 |
|---|---|---|
| 그래프 색·무늬 변경(적대적 섭동) | 공개 소형 모델 Qwen3-VL-2B | 월별 판매량 막대그래프에서 막대 높이·눈금·윤곽은 두고 색과 무늬만 바꾸자, 정답 3월 대신 4월을 골랐습니다 |
| 같은 무늬 | Anthropic의 Claude Fable 5.2·Claude Haiku 5.5 | 10회 입력에서 모두 값과 정답을 맞혔습니다 |
| 연한 회색 글씨로 쓴 거짓 정답 | Qwen3-VL-2B | 시험지 아래에 오답을 정답이라고 적은 문구를 넣자, 이미지 속 지시를 따르지 말라고 해도 그 오답을 골랐습니다. 상용 모델에는 시험하지 않았습니다 |
| 시행 중인 시험이라는 안내문 | Claude Fable 5.2·Claude Haiku 5.5 | 시험이 진행 중이고 AI 도움은 부정행위라는 문구를 넣자 12회 중 7회 답을 거절하거나 되물었습니다(Fable 4회 중 2회, Haiku 8회 중 5회). 다른 환경에서 한 14회에서는 한 번도 거절하지 않았습니다 |
연구팀은 한계도 밝혔습니다. 이 적대적 섭동은 Qwen 모델의 내부 값을 이용해 계산한 것이라 한 모델, 한 문항에서만 확인됐습니다. 실험은 문항 한두 개를 이미지 파일로 모델에 직접 넣는 방식이었고, 인쇄·촬영·축소·압축을 거쳤을 때의 효과나 수험생이 이런 표시를 읽을 때 겪는 불편은 아직 확인하지 않았습니다. 연구팀은 인쇄한 시험지를 안경으로 찍는 실험을 다음 단계로 예고했습니다.
숨은 지시문: 사람은 지나치고 모델은 읽는 글
숨은 지시문은 프롬프트 인젝션(prompt injection)의 한 형태입니다. 언어 모델은 사용자가 내린 질문과, 처리하라고 건넨 문서 속 문장을 근본적으로 같은 방식으로 읽습니다. 그래서 문서 안에 “이 문서를 이렇게 다뤄라” 같은 문장이 있으면 그것을 사용자의 지시처럼 따를 수 있습니다. 흰 바탕에 흰 글씨, 아주 작은 글씨, 배경과 거의 같은 색 글씨는 사람 눈에는 띄지 않지만 텍스트를 추출하는 도구에는 다른 글자와 똑같이 잡힙니다.
숨은 지시문이 발견된 사례와 실험
가장 널리 알려진 것은 학술 논문입니다. 2025년 7월 닛케이 아시아는 arXiv에 올라온 영어 논문에서 AI 심사자를 겨냥한 숨은 문장을 찾아냈다고 보도했습니다. AI 사고 데이터베이스(AIID)에 수록된 이 기사에 따르면 대상은 논문 17편, 제1저자 소속 기관 14곳이었고 그 가운데 KAIST도 있었습니다. 긍정적인 평가만 하라거나 약점을 언급하지 말라는 짧은 문장이 흰 글씨나 극히 작은 글씨로 들어 있었습니다. 이 사건을 분석한 Zhicheng Lin의 글(Communications of the ACM 게재)은 18편을 확인했고, 일부 저자가 “AI로 대충 심사하는 사람을 잡는 장치”라고 해명한 것에 대해 문장이 늘 저자에게 유리한 쪽으로 쓰여 있었다는 점을 들어 받아들이기 어렵다고 판단했습니다. 여기서 확인된 것은 숨은 문장이 들어 있었다는 사실까지이고, 실제 심사 결과를 얼마나 바꿨는지는 알려지지 않았습니다.
시험 문항으로 직접 실험한 연구도 있습니다. Guo 등이 2025년 8월 arXiv에 공개한 「Too Easily Fooled?」는 아주 쉬운 산수 문제를 객관식·참거짓 형식으로 PDF에 넣고 숨은 지시문을 함께 넣었더니, 언어 모델이 쉬운 문제조차 틀리게 답했다고 보고했습니다. 연구의 원래 관심은 학생이 AI 채점기를 속이는 쪽이었지만, 방향을 뒤집으면 출제자가 AI의 답을 흔드는 데도 같은 약점이 쓰일 수 있다는 뜻입니다.
그 방향을 실제 도구로 만든 것이 미국 애리조나주립대 연구진이 2026년 3월 EACL 학회 시연 부문에 발표한 IntegrityShield입니다. 교사가 시험지 PDF를 올리면 화면에 보이는 모습은 그대로 둔 채, 눈에 안 보이는 글자, 글꼴 대응표 조작, 화면 밖 덧씌우기로 AI가 읽는 내용만 바꿉니다. 사람이 보는 화면과 AI가 PDF에서 뽑아내는 글자가 다를 수 있다는 틈을 이용한 것입니다. 시험지 30개로 상용 모델 4종(GPT-5, Claude Sonnet 4.5, Grok 4.1, Gemini 2.5 Flash)을 시험했더니, 모델이 쓸 만한 답을 내지 못한 시험지가 모델과 설정에 따라 약 90-94%였다고 보고했습니다. 같은 논문에서 흰색 작은 글씨로 지시만 넣는 단순한 방식은 그 비율이 3.5-7.2%에 그쳤습니다.
다만 이 결과는 학생이 PDF 파일을 그대로 AI에 올리는 상황에 한정됩니다. 연구진은 PDF를 이미지로 바꾸거나 다른 형식으로 다시 저장하는 경우를 평가하지 않았고, 파일을 거치지 않고 문제를 옮기는 경우도 연구 범위 밖이라고 밝혔습니다. 종이 시험지를 카메라로 찍는 수능 상황은 이 범위에 들어가지 않습니다. 숭실대 실험의 연한 회색 글씨도 소형 공개 모델에서만 시험됐습니다.
이미지 속 숨은 글씨도 통했습니다. 브라우저 회사 Brave는 2025년 10월, Perplexity의 AI 브라우저 Comet이 사용자가 찍은 스크린샷 속에서 사람이 알아보기 어려운 외부 문장을 읽어 내 지시로 처리했다고 공개했습니다. Perplexity는 문제를 고쳤다고 밝혔습니다. 사진 속 흐린 글씨가 모델에게는 명령이 될 수 있다는 점에서 시험지 장치와 가장 가까운 사례입니다.
KBS와 한겨레가 소개한 미국 앨콘주립대 강사 제이슨 깁슨의 사례도 자주 언급됩니다. 2026년 7월 온라인 중간고사 지시문에 흰 글씨로 답에 엉뚱한 단어를 넣으라는 명령을 숨겼더니, 학생 35명 중 32명이 AI로 답 전체를 써서 일부 문항에서 낙제점을 받았다고 본인이 틱톡에 밝혔습니다. 당사자 게시물에 기반한 내용이라 세부는 확인하기 어렵지만, 이 방식이 방어가 아니라 탐지로 쓰였다는 점은 눈여겨볼 만합니다.
시험장에서는 왜 약한가
| 한계 | 설명 |
|---|---|
| 인쇄와 촬영을 거친다 | 디지털 문서의 흰 글씨는 텍스트로 그대로 추출되지만, 종이 시험지는 카메라로 찍힌 이미지만 모델에 들어갑니다. 너무 흐리면 카메라에도 안 잡힐 수 있고, 잘 잡힐 만큼 진하면 수험생 눈에도 보일 가능성이 커집니다 |
| 효과가 입력 조건에 따라 달라진다 | 지금까지의 실험은 PDF나 이미지 파일을 모델에 직접 넣는 조건이었습니다. 촬영 범위나 입력 방식이 달라지면 장치가 빠지거나 약해질 수 있고, 시험장에서 일관되게 작동하는지는 확인되지 않았습니다 |
| 모델이 이미 대비하고 있다 | OpenAI는 2024년 시스템·사용자 지시를 외부 문서 속 지시보다 우선하도록 모델을 훈련하는 지시 계층(instruction hierarchy) 연구를 공개했고, Microsoft는 Copilot에 문서 속 프롬프트 인젝션을 걸러 내는 분류기를 두고 있습니다. 어떤 모델에 통하던 문장이 다음 업데이트에서 안 통할 수 있습니다 |
| 정직한 수험생의 부담을 확인해야 한다 | 시험지에 읽지 말아야 할 문장이 섞이면 혼란을 줄 수 있고, 시각장애 수험생이 쓰는 화면 낭독기나 확대 자료에서는 숨은 문장이 그대로 노출될 수 있습니다. 실제 부담이 얼마나 되는지는 아직 측정된 적이 없습니다 |
| 공정성 문제가 생긴다 | 같은 장치라도 어떤 모델에는 통하고 어떤 모델에는 안 통하면, 결과적으로 특정 도구를 쓴 사람만 걸리는 불균등한 장치가 됩니다 |
답을 거부하게 만드는 방법
시험지에 지금 시험이 진행 중이며 AI 도움을 받는 것은 부정행위라는 취지의 안내를 적어 두면, 그 문장을 읽은 AI가 스스로 풀이를 멈출 수 있습니다. 숭실대 연구팀은 이것을 ‘선언’ 방식이라고 불렀습니다. 이 방식은 모델을 속이는 대신, 모델이 안내문을 읽고 스스로 판단해 멈추기를 기대하는 쪽입니다. KBS 보도에서는 안내문을 넣은 모의고사 문항에 AI가 지금은 답이나 풀이를 알려 주지 않겠다고 답하는 장면이 나왔습니다.
국내 예비 실험에서 상용 모델에 시험한 방식 가운데 효과를 보인 것은 이것뿐이었습니다. Claude Fable 5.2와 Claude Haiku 5.5에 12번 넣어 7번 답을 거절하거나 되묻게 했습니다. 연구팀은 시행 중인 시험임을 알리는 표준 표시를 만들고, AI 서비스 제공자가 그 표시를 인식하면 풀이를 멈추도록 약속하자고 제안했습니다.
하지만 같은 결과가 이 방식의 약점도 보여 줍니다. 7회는 거절하거나 되물었을 뿐 나머지 5회는 답을 줬고, 환경을 바꾼 14회에서는 한 번도 거절하지 않았습니다. 같은 모델이라도 입력 조건에 따라 반응이 달라졌고, 시험장에서 일관되게 작동하는지는 확인되지 않았습니다. 이런 안내를 따르도록 설계되지 않은 모델에는 효과를 기대하기 어렵고, 표준 표시와 사업자 약속이 생기더라도 그 약속에 참여하지 않은 모델은 남습니다. 탈옥(jailbreak)이 모델이 거부해야 할 요청을 따르게 만드는 것이라면, 이 방식은 반대로 답할 수 있는 요청을 거부하게 만들려는 것입니다. 방향은 반대지만 거부 경계가 고정돼 있지 않다는 문제는 같습니다. 탈옥은 프롬프트 인젝션과 탈옥을 분석한 글에서 자세히 다뤘습니다.
적대적 섭동: 사람은 못 느끼는 변화로 모델을 흔들기
적대적 예제(adversarial example)는 사람 눈에는 원래 이미지와 거의 같아 보이지만 모델은 전혀 다르게 판단하도록 계산된 입력입니다. 신경망은 수많은 픽셀 값을 조합해 판단하는데, 판단 결과가 크게 바뀌는 방향으로 각 픽셀을 아주 조금씩 움직이면 사람은 차이를 못 느껴도 모델의 답은 바뀔 수 있습니다. 이런 미세한 변화가 적대적 섭동입니다. 더 넓은 배경은 AI 보안 가이드에서도 다뤘습니다.
종이에 인쇄해도 살아남는가
시험지에 쓰려면 적대적 섭동이 인쇄와 촬영을 버텨야 합니다. Kurakin·Goodfellow·Bengio(2016)는 적대적 이미지를 인쇄한 뒤 휴대전화 카메라로 찍어 이미지 분류 모델에 넣어도 상당수가 여전히 잘못 분류된다는 것을 보였습니다. 물리 세계에서도 적대적 예제가 작동할 수 있다는 첫 근거였습니다.
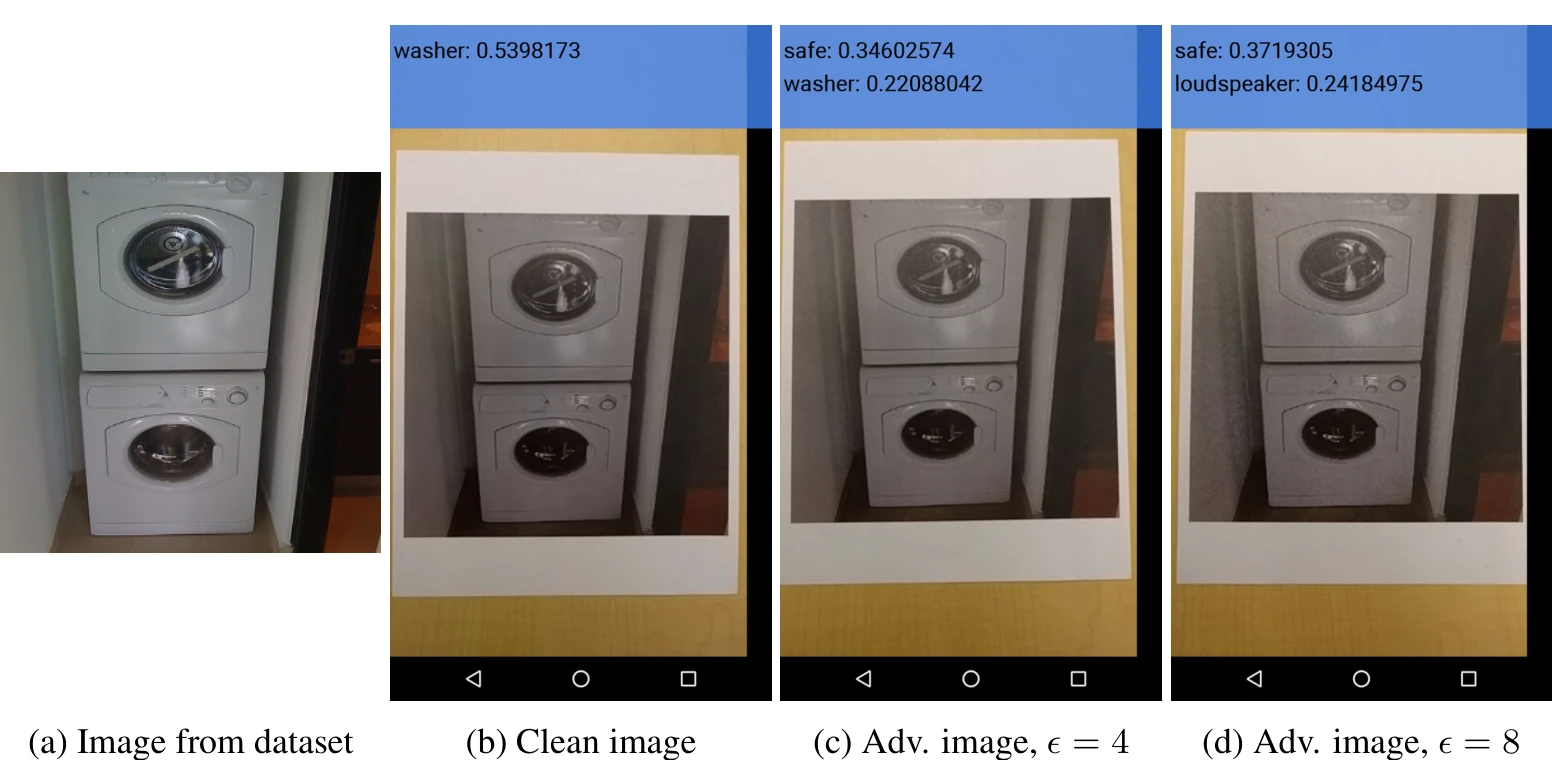
인쇄한 세탁기 사진을 휴대전화 앱으로 찍은 실험입니다. 깨끗한 사진(b)은 세탁기로, 적대적 섭동을 넣은 사진(c, d)은 다른 물체로 인식됐습니다. 출처: A. Kurakin 외, Adversarial examples in the physical world(2016), 그림 1
대형 상용 모델에도 통하는가
부정행위자가 쓰는 모델은 내부 구조를 볼 수 없는 상용 서비스입니다. 그래서 공개 모델로 적대적 섭동을 만든 뒤 다른 모델에도 통하기를 기대하는 전이(transfer) 방식을 써야 합니다. 효과는 들쭉날쭉합니다.
| 연구 | 대상 | 결과 |
|---|---|---|
| Dong 등(2023), 상용 챗봇 대상 이미지 공격 | Google Bard, Bing Chat, ERNIE Bot, GPT-4V | 공개 모델로 만든 적대적 이미지가 각각 22%, 26%, 86%, 45%의 성공률을 보였습니다 |
| Bagdasaryan 등(2023) | 공개 VLM(LLaVA, PandaGPT) | 이미지·음성에 섞은 적대적 섭동으로 모델이 공격자가 정한 문장을 출력하거나 대화 전체가 공격자의 지시를 따르게 했습니다 |
| Qi 등(2023) | 시각 입력을 받는 정렬된 언어 모델 | 적대적 이미지 하나로 모델이 평소 거부하던 유해 요청을 폭넓게 따르게 했습니다 |
공개 모델을 직접 겨냥하면 강력하지만, 상용 모델로 옮겨 가면 성공률이 22%에서 86%까지 모델마다 크게 갈렸습니다. 2023년 결과는 그 뒤 모델들이 여러 번 바뀐 만큼 지금도 그대로 재현된다고 보기 어렵습니다. 숭실대 예비 실험에서도 소형 공개 모델의 내부 값을 이용해 만든 적대적 섭동은 그 모델을 속였지만, 상용 Claude 모델 2종은 10번 모두 정답을 맞혔습니다.
시험 문항에 직접 적용한 실험
이 질문에 가장 직접 답하는 연구는 독일 다름슈타트공대 연구진(Braun 등)이 2026년 8월 arXiv에 공개한 「Fighting Fire with Fire」입니다. 아직 동료 심사를 거치지 않은 사전 공개 논문입니다. 연구진은 문항 이미지에 적대적 섭동을 넣어 AI가 출제자가 미리 정한 오답을 고르게 만들려고 했습니다. 공개 VLM 6개를 묶어 적대적 섭동을 만들고, Claude·Gemini·GPT 계열 상용 모델에 적용했습니다.
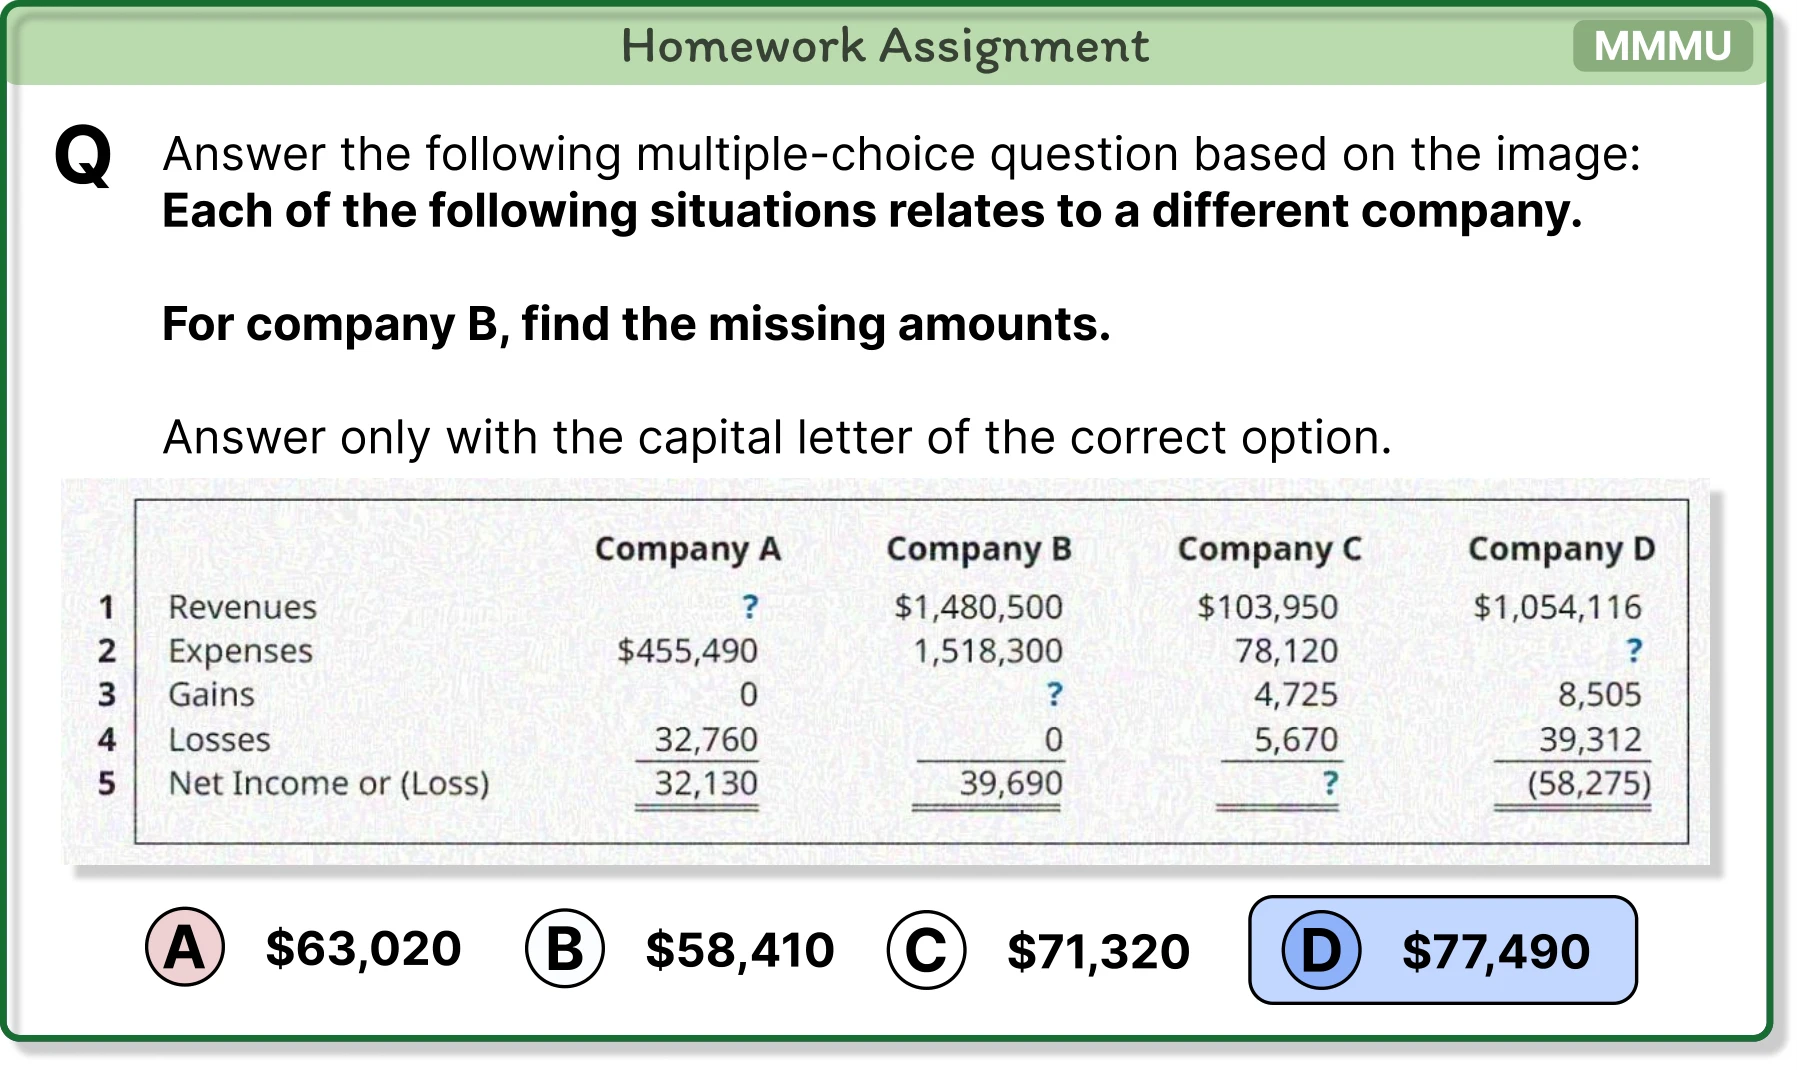
연구진이 보호한 문항 예시입니다. 사람에게는 같은 문제로 보이도록 표 이미지에 적대적 섭동을 넣었고, AI는 정답 D 대신 출제자가 정한 A 쪽으로 기울었습니다. 출처: T. Braun 외, Fighting Fire with Fire(arXiv, 2026), 그림 6
| 지표 | 결과 |
|---|---|
| 보호 문항에서 AI가 출제자가 정한 오답을 고른 비율 | 데이터셋별 평균 1.87-8.18% |
| 보호 문항에서 AI의 정답률 | 데이터셋별 평균 90.36-96.04% |
| 20문항 과제, 연구진 기본 가정(정직한 학생이 그 오답을 고를 확률을 교사가 보수적으로 판단해 정함) | 설계에 쓴 상용 모델 3종에서 검정력 0.95 이상. 여러 검정 중 한 번이라도 정직한 학생을 잘못 지목할 확률의 계산상 상한 1만분의 8 미만 |
| 같은 과제, 대체 가정(정직한 학생도 출제자가 정한 오답을 50% 확률로 고른다고 가정) | 같은 검정력에서 여러 검정 중 한 번이라도 잘못 지목할 확률의 계산상 상한이 약 2%로 올라갑니다 |
| 설계에 쓰지 않은 모델 | Gemini 3 Flash는 잘 가려냈지만 GPT-5.4 계열 2종은 거의 구분하지 못했습니다 |
적대적 섭동을 넣어도 AI는 대부분의 문항을 여전히 맞혔습니다. 연구진도 이것을 공격 성공률이 아니라 응답이 조금 기울어지는 정도로 설명합니다. 다만 같은 오답 쪽으로 기우는 패턴이 여러 문항에 걸쳐 쌓이면, AI 답을 그대로 베낀 답안을 가려낼 가능성을 보였습니다. 오탐 확률은 실제 학생 답안에서 잰 값이 아니라 정직한 학생의 응답을 어떻게 가정하느냐에 따라 달라지는 계산값입니다. 즉 시험 중에 AI를 막는 장치가 아니라 시험 뒤에 AI 사용을 가려내는 워터마크에 가까웠습니다.
전제 조건도 좁습니다. 학생이 과제의 상당 부분을 AI 답 그대로 옮겨 적는다고 가정했고, 몇 문항만 AI에 묻거나 답을 검토해 고치는 학생은 대상에서 뺐습니다. 적대적 섭동을 만들 때 쓰지 않은 모델에서는 성능이 크게 흔들렸고, 촬영이나 재입력처럼 입력 조건이 바뀌는 경우는 본문에서 평가하지 않았습니다. 수능처럼 부정행위자가 단 몇 문제만 AI에 물어볼 수도 있는 시험에는 그대로 적용하기 어렵습니다.
글자와 무늬로 모델이 다른 것을 읽게 하기
적대적 섭동보다 훨씬 거친 방법도 있습니다. 이미지 안에 엉뚱한 글자를 넣는 것입니다. OpenAI 연구진이 2021년 CLIP 모델의 내부를 분석한 「Multimodal Neurons」 연구에서 보고한 글자 공격(typographic attack)이 대표적입니다. 사과에 “iPod”이라고 쓴 종이를 붙이자 모델이 사과를 iPod으로 분류했습니다. 펜과 종이만으로 가능한 공격이었습니다. 이미지와 글자를 함께 배운 모델이 사물의 모양보다 이미지 속 글자를 더 강한 단서로 쓰는 경향이 있다는 뜻입니다.
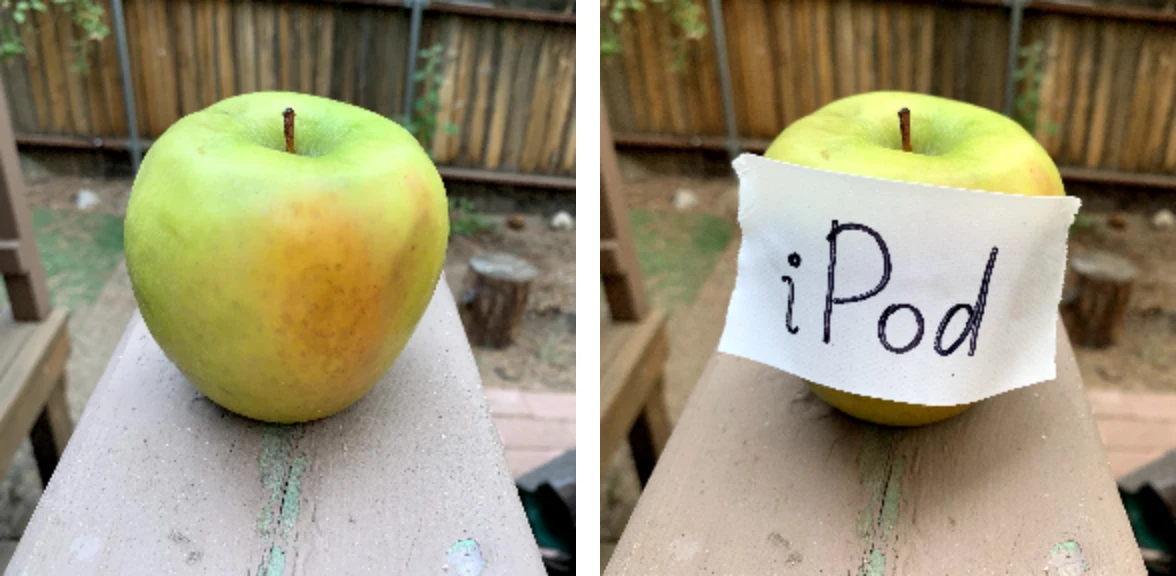
왼쪽 사과는 사과로, “iPod”이라고 쓴 종이를 붙인 오른쪽 사과는 iPod으로 분류됐습니다. 출처: G. Goh 외, Multimodal Neurons in Artificial Neural Networks(Distill, 2021), CC BY 4.0. 원문의 두 사진을 나란히 배치했습니다
시험지에 비슷한 장치를 넣는 상상은 쉽습니다. 문제와 무관한 글자, 읽기 어렵게 만든 글꼴, 문자 인식을 방해하는 배경 무늬, 시험지마다 다른 워터마크 같은 것들입니다.
| 장치 | 기대 효과 | 현실적인 문제 |
|---|---|---|
| 방해 글자·배경 무늬 | OCR이나 VLM이 문제를 잘못 읽게 함 | 이 글에서 조사한 자료(2026-11-20 확인) 가운데 종이 시험지에 방해 글자나 배경 무늬를 넣어 최신 VLM을 시험한 연구는 없었습니다. 수험생의 읽기 부담도 확인이 필요합니다 |
| 특수 글꼴·글자 변형 | 기계 판독을 어렵게 함 | 시험 공정성과 가독성 기준과 충돌할 수 있고, 입력 방식이 바뀌면 효과가 사라질 수 있습니다 |
| 시험지별 고유 워터마크 | 유출된 사진이 어느 시험지에서 나왔는지 추적 | AI를 막지는 못하지만 유출된 사진의 출처를 추적하는 데는 쓸 수 있습니다 |
시험지 장치에는 AI를 막는 것과 다른 용도도 있습니다. 시험지별 워터마크는 유출된 사진이 어디서 나왔는지 추적하는 데 쓰이고, 적대적 섭동이 남기는 오답 패턴은 Braun 등의 연구에서 여러 문항에 걸쳐 AI 답을 그대로 옮긴 답안을 가려낼 가능성을 보였습니다. 두 용도는 목적이 다르고, 같은 조건에서 효과를 비교한 자료도 없습니다.
AI가 쓴 답에 남는 워터마크는 어디까지 쓸 수 있나
지금까지 본 장치는 AI가 읽는 시험지에 무언가를 심는 입력 쪽 방법입니다. 출력 워터마크는 반대로 AI가 쓴 답에 표식을 남깁니다. 연구는 2023년부터 본격화했고, Google은 2024년 SynthID-Text를 Gemini에 적용한 실험을 공개했습니다. 2026년에는 EU AI Act의 표시 의무가 시행되면서 Anthropic과 OpenAI도 실제 서비스에 넣었습니다.
텍스트 워터마크의 원리
언어 모델은 다음에 올 토큰(token, 글을 잘게 나눈 처리 단위)의 확률을 계산한 뒤 그중 하나를 고르는 샘플링(sampling)을 반복합니다. 의미가 비슷한 후보가 여러 개일 때가 많습니다. 텍스트 워터마크는 이 선택 단계에 비밀 키로 정한 규칙을 섞어, 어떤 후보들이 아주 조금 더 자주 뽑히게 만듭니다. 한 문장에서는 티가 나지 않지만 수백 번의 선택이 쌓이면 키를 아는 탐지기는 그 치우침을 통계로 잡아낼 수 있습니다. 2023년 Kirchenbauer 등이 이 방향의 대표적인 방식을 제안했고, Google DeepMind는 2024년 Nature에 실은 SynthID-Text 논문에서 모델 학습은 건드리지 않고 샘플링 과정만 바꾸는 방식을 실제 Gemini 응답 약 2,000만 건에 적용해 품질 저하가 없었다고 보고했습니다. 탐지에는 원래 모델이 필요 없습니다.
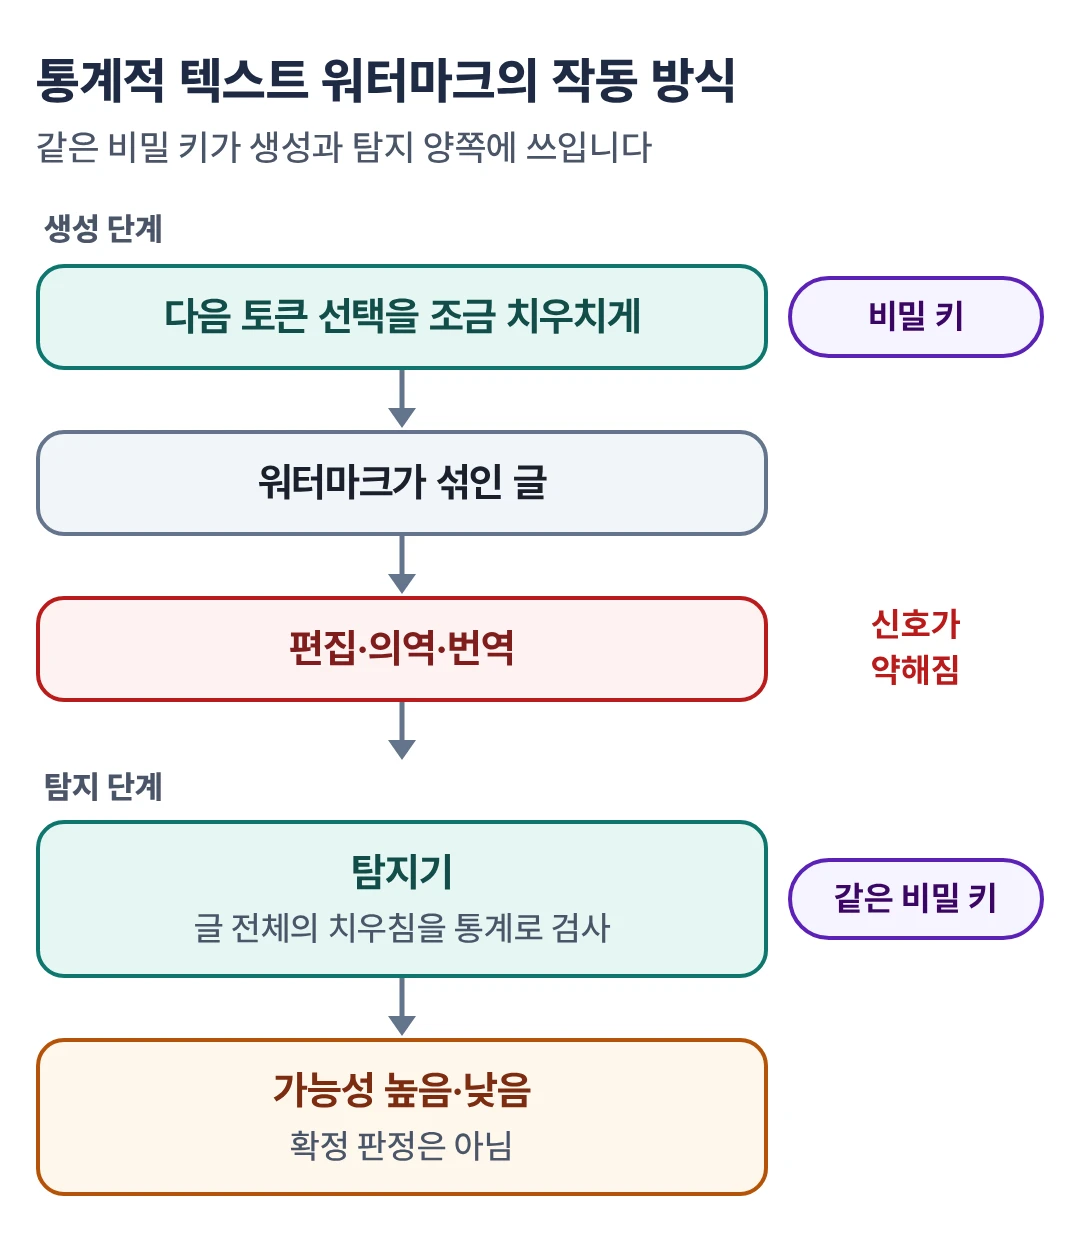
신호는 많은 선택이 쌓여야 생기므로 짧은 글에서는 약하고, 단어를 바꾸거나 다른 언어로 옮기면 치우침이 흐려집니다.
회사별로 무엇이 들어갔나 (2026-11-20 확인)
| 회사 | 방식 | 적용 범위 | 탐지 공개 여부와 밝힌 한계 |
|---|---|---|---|
| Anthropic(Claude) | 지원 모델이 생성한 텍스트의 보이지 않는 워터마크, 지원 파일 형식(PNG·JPEG 등)의 C2PA(콘텐츠 출처 증명 표준) 정보 | EU AI Act 제50조(2) 실천 강령에 서명했습니다. 2026년 8월 2일 이후 EU에서 출시되는 모델은 출시 때부터 표시하고, 표시는 API·앱·Claude Code 등 제품 전반과 전 세계 출력에 적용됩니다(일부 플랫폼·기능은 특정 표시 미지원). 이전 모델도 순차 지원합니다 | 워터마크 탐지는 비공개 미리보기로 규제기관·언론·연구자·교육기관 등 적격 조직에만 제공합니다. 표시가 있어도 교정·번역처럼 Claude가 거치기만 한 글일 수 있고, 표시가 없다고 사람이 쓴 글은 아니라고 명시했습니다. 많이 편집·의역·번역된 글이나 매우 짧은 글에서는 표시가 잡히지 않을 수 있습니다 |
| OpenAI(ChatGPT·Codex) | textGrain이라는 통계적 워터마크 | 2026년 10월 5일 발표했습니다. EU 사용자의 ChatGPT·Codex에서 적용 대상 출력에 몇 주에 걸쳐 순차 도입하고, API는 전 세계에서 일부 모델에 선택 적용합니다(기본 꺼짐) | 탐지기는 승인된 연구자·전문기관에만 제공합니다. 자체 시험에서 단어 10%를 동의어로 바꾸자 탐지율이 약 92%에서 66%로 떨어졌습니다. 짧은 글, 수학 답, 번역문은 탐지가 더 어렵고, 표시가 없다고 사람이 썼다는 증거는 아니라고 밝혔습니다 |
| Google(Gemini) | SynthID-Text | 2024년 Nature 논문에서 Gemini 응답 약 2,000만 건에 적용한 실험을 보고했습니다 | 논문에서 어떤 텍스트 탐지 방법도 완벽하지 않다고 밝혔습니다 |
OpenAI는 2024년에도 텍스트 워터마크를 만들어 두고 공개를 미룬 적이 있습니다. TechCrunch는 당시 월스트리트저널 보도를 인용해, 워터마크가 없는 경쟁 서비스로 사용자가 옮겨 갈 것을 우려한 것이 이유 중 하나였다고 전했습니다. 2026년의 변화는 EU AI Act가 생성 콘텐츠의 기계 판독 가능한 표시를 요구하면서 생긴 것입니다.
시험 부정행위에는 얼마나 도움이 되나
| 상황 | 출력 워터마크의 쓸모 |
|---|---|
| 수능 같은 선택형·단답형 시험 | 사실상 없습니다. 부정행위자는 AI 답을 눈으로 읽고 OMR(광학 마크 판독) 카드에 표시할 뿐이라, 워터마크가 담긴 글 자체가 답안에 남지 않습니다 |
| 실시간으로 답을 듣거나 보는 방식 | 없습니다. 스마트안경·이어폰으로 전달받은 답은 제출물에 흔적을 남기지 않습니다 |
| 서술형 시험·글쓰기 과제 | AI가 쓴 문장을 그대로 옮겼다면 신호가 남을 수 있습니다. 하지만 탐지기는 일반 교사가 쓸 수 없는 경우가 많고, 학생이 고쳐 쓰거나 번역하면 신호가 약해집니다 |
| 오탐 위험 | 맞춤법 교정이나 번역에만 AI를 쓴 학생의 글에도 표시가 남을 수 있습니다. 표시 하나로 부정행위를 단정하면 안 되고, 구술 확인 같은 후속 절차의 계기로만 써야 합니다 |
입력 쪽 장치도 워터마크라는 이름으로 불리곤 하지만 작동 방식은 서로 다릅니다. 앞에서 본 독일 연구는 객관식 문항에 적대적 섭동을 넣어 AI가 출제자가 정한 오답 쪽으로 조금 기울게 하고, 여러 문항의 응답에서 그 오답 패턴이 얼마나 겹치는지를 통계로 봅니다. 애리조나주립대의 IntegrityShield는 스스로를 “문서 층 워터마크”라고 부르며, PDF 입력을 받은 모델이 답을 못 내게 막는 비율과, 모델 답이 심어 둔 오답·핵심어 패턴을 따르는 비율을 따로 측정했습니다. 독일 연구 방식은 이론상 선택형 답안에도 흔적을 남길 수 있지만, 수능 OMR 답안으로 검증한 연구는 아직 없습니다. 어느 쪽이든 이런 신호는 의심을 좁히는 단서일 뿐, 혼자서 부정행위를 증명하지는 못합니다.
시험장에서는 무엇으로 적발했나
시험지 장치는 출제자에게 불리한 구조 위에 서 있습니다. 출제자는 시험지를 한 번 인쇄하면 바꿀 수 없지만, 부정행위자는 쓰는 모델과 입력 방식을 스스로 고릅니다. 기기 통제와 감독은 그보다 앞 단계, 즉 촬영과 전달 자체를 겨냥합니다. 아래 표는 각 수단이 어느 단계에 작용하는지와 이번 사건들에서 보도된 역할을 정리한 것입니다. 수단별 효과를 비교해 잰 자료는 아닙니다.
| 방어 수단 | 작용 지점 | 이번 사건에서의 역할 | 약점 |
|---|---|---|---|
| 기기 반입 통제(휴대전화 수거, 안경 확인, 단추 스티커) | 촬영 이전 | 수능에서 안경 전수 확인과 스마트안경 반입 금지를 시행했습니다 | 세무사 시험은 휴대전화를 걷지 않아 공백이 생겼습니다 |
| 숨긴 기기 탐지(재난문자, 전파 탐지기, 금속 탐지기) | 촬영·전송 | 재난문자로 휴대전화 54건을 찾아냈고, 전파 탐지기는 검토 단계입니다 | 통신을 끈 기기나 녹화만 하는 기기는 전파로 잡기 어렵습니다 |
| 감독과 행동 관찰 | 전 단계 | 천안 사례는 안경을 만지는 행동과 풀이 없는 답에서 시작됐습니다 | 감독 인력과 숙련도에 좌우되고, CCTV가 없으면 기록이 남지 않습니다 |
| 문제 설계(과정 서술, 구술, 응용 문항) | 답 생성 | 이번 수능과는 무관하고, 학교 시험·과제에서 쓰는 방법입니다 | 대규모 객관식 시험에는 적용 범위가 좁습니다 |
| 사후 분석(성적 이상치, 심어 둔 오답 패턴, 자수·제보) | 답 제출 이후 | 세무사 사건은 결국 당사자 시인으로 드러났습니다 | 이미 시험이 끝난 뒤의 대응입니다 |
| 시험지 장치(숨은 지시문, 적대적 섭동, 안내문) | 모델 입력 | 이번 사건에서 적발에 쓰였다는 보도는 확인되지 않았고, 숭실대 예비 실험 단계입니다 | 실제 시험에서 검증되지 않았고, 모델과 입력 조건에 따라 효과가 달라집니다 |
| AI 출력 워터마크 | 제출된 글 | 선택형 수능에는 해당하지 않습니다 | 짧은 글·편집·번역에 약하고 탐지기 접근이 제한돼 있습니다 |
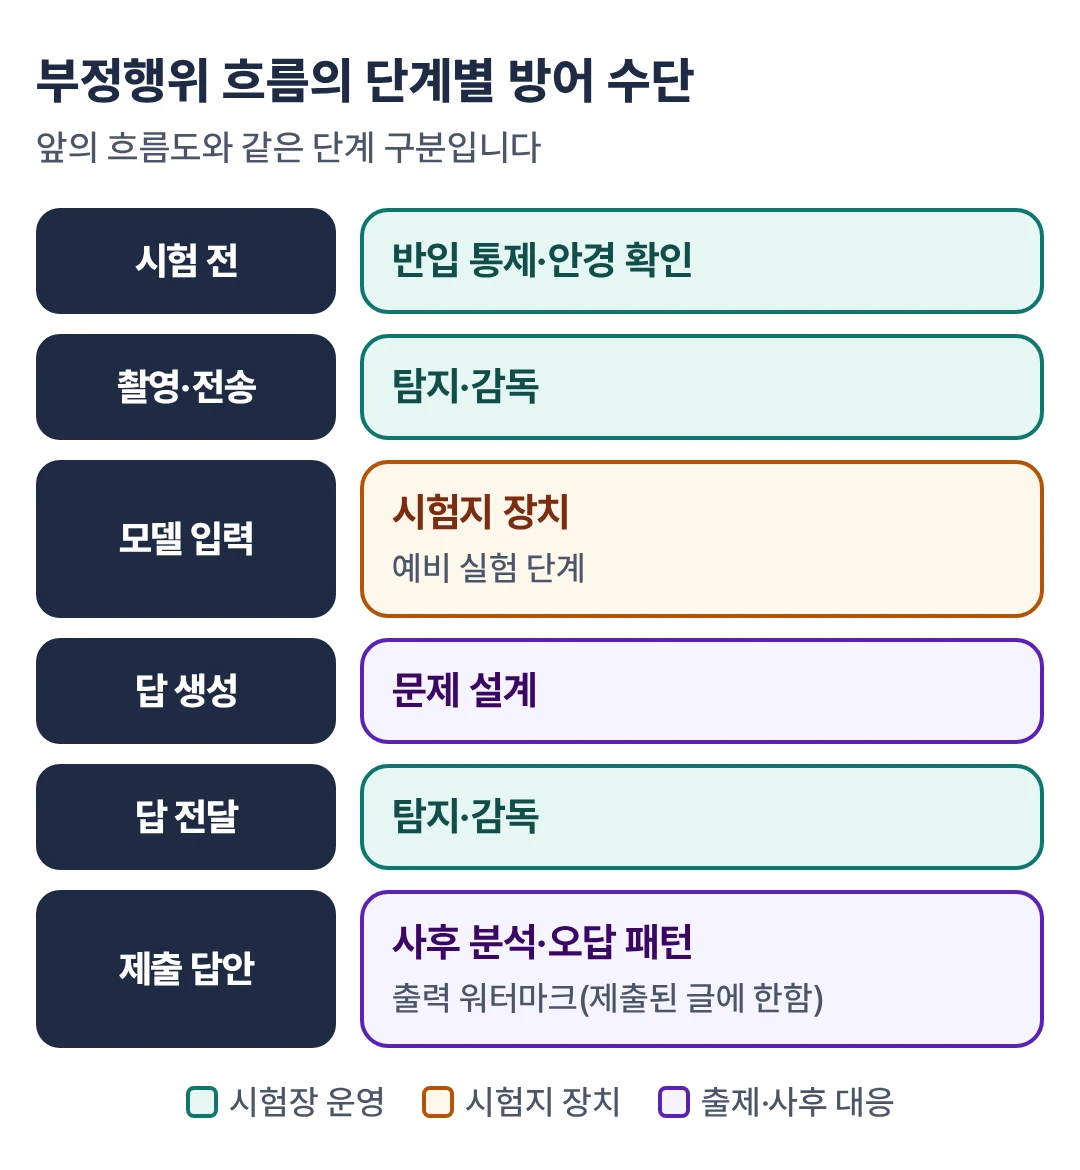
시험지 장치를 완전히 버릴 필요는 없습니다. 학교 과제처럼 학생이 문항 파일을 그대로 AI에 붙여 넣기 쉬운 환경에서는 탐지 장치로 쓸 수 있고, 시험지별 워터마크는 유출 추적에 쓸모가 있습니다. 다만 주된 방어로 삼기에는 근거가 아직 부족합니다.
같은 약점이 도로와 얼굴 인식에서는
시험지 장치가 기대는 원리, 즉 사람이 의미 있게 여기지 않는 입력 변화가 시스템의 판단을 바꿀 수 있다는 점은 방향을 바꾸면 위협이 됩니다. 이번에는 방어자가 아니라 공격자가 이 원리를 쓰고, 대상은 카메라와 센서로 세상을 보는 시스템입니다. 이 경우 문제는 시각 단서를 잘못 분류하는 데서 생깁니다. 아래 연구는 모두 통제된 실험이며, 표에는 대상과 관찰 결과만 적었습니다.
| 연구 | 대상 | 보여 준 것 |
|---|---|---|
| Eykholt 등(2018, CVPR) | 표지판 분류 모델(차량 제어는 평가하지 않음) | 실물 정지 표지판에 표식을 더하자 분류기가 다른 표지판으로 오인했습니다. 실험실 이미지 100%, 주행 차량에서 찍은 영상 프레임의 84.8%에서 목표한 오분류가 나왔습니다 |
| Tencent Keen Security Lab(2019) | 2018년 당시 Tesla Model S의 Autopilot 차선 인식과 자동 와이퍼 | 시험 환경의 노면 표식을 차선으로 인식해 차량의 조향이 잘못된 차선 쪽으로 향했습니다(실제 차량 반응). 카메라 앞 적대적 이미지로 자동 와이퍼도 오작동했습니다 |
| McAfee(2020) | 구형 Tesla 차량의 Mobileye 카메라 시스템 | 표식을 더한 속도 제한 표지판을 실제보다 높은 제한 속도로 읽고, 크루즈 컨트롤 상태의 차량이 가속하기 시작했습니다(실제 차량 반응). 이후 버전 카메라에서는 재현되지 않았다고 합니다 |
| Nassi 등(2020, ACM CCS) | Tesla Model X의 Autopilot, Mobileye 630 | 아주 짧게 비춘 가짜 표지판·장애물 영상에 Tesla는 제동으로, Mobileye 630은 잘못된 경고로 반응했습니다(실제 시스템 반응). 연구진은 여러 모델을 합의시키는 탐지기를 대응책으로 제안했습니다 |
| Cao 등(2019, ACM CCS) | Baidu Apollo의 라이다(LiDAR) 인식 | 가짜 점을 섞은 센서 데이터에서 앞에 없는 장애물을 인식했습니다. 성공률은 약 75%였습니다(기록 데이터를 쓴 시뮬레이션) |
| Sharif 등(2016, ACM CCS) | 얼굴 인식 모델 | 무늬를 넣은 안경테를 쓴 사람이 본인으로 인식되지 않거나 다른 사람으로 인식됐습니다 |
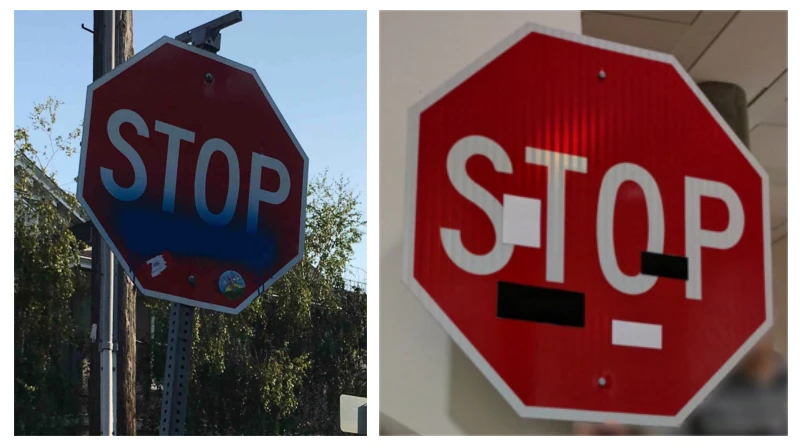
왼쪽은 실제 낙서가 있는 정지 표지판, 오른쪽은 연구진이 낙서처럼 보이게 만든 표식을 더한 표지판입니다. 오른쪽 표지판은 실험에서 분류기가 다른 표지판으로 오인했습니다. 출처: K. Eykholt 외, Robust Physical-World Attacks on Deep Learning Visual Classification(CVPR 2018), 그림 1
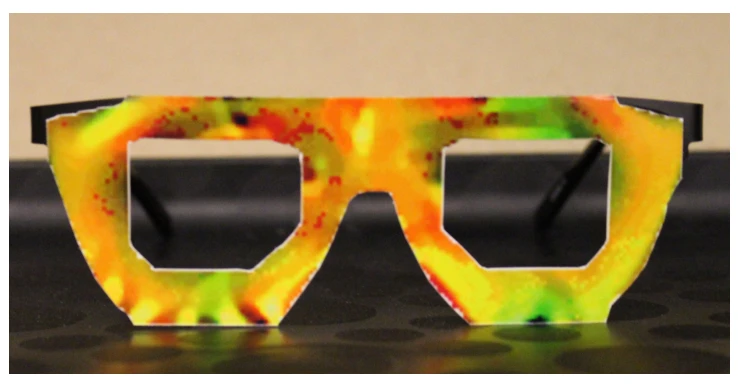
연구진이 얼굴 인식 시스템이 착용자를 본인으로 알아보지 못하게 하려고(회피) 만든 안경테입니다. 출처: M. Sharif 외, Accessorize to a Crime(ACM CCS 2016), 그림 5
마지막 연구는 이 글의 출발점과 묘하게 겹칩니다. 지금 시험장에서 걱정하는 스마트안경은 AI에 시험지를 보여 주는 입력 장치로 쓰일 수 있다는 점 때문에 문제가 됐고, 2016년 연구의 안경은 AI의 눈을 속이도록 만들어졌습니다.
이 연구들에는 공통된 단서도 있습니다. 대부분 연구자가 대상 시스템을 깊이 분석할 수 있었고, 조건을 통제한 실험이었으며, 결과는 공개 전에 제조사에 알려졌습니다. 실험실 성공률이 곧 도로 위 위험도를 뜻하지는 않습니다. 표지판 분류기의 오분류와 실제 차량의 제어 반응은 서로 다른 수준의 증거라는 점도 구분해야 합니다. 그래도 카메라 한 종류에만 의존하는 인식이 사람이 보기에 사소한 표식에 흔들릴 수 있다는 점은 여러 번 확인됐습니다. 자율주행 쪽의 기본 대응이 여러 센서를 교차 확인하는 센서 융합(sensor fusion)인 것도 이 때문입니다.
에이전트에게는 지시와 데이터가 같은 통로로 섞여 들어옵니다
언어 모델 쪽에서는 문제가 다른 경로로 나타납니다. 웹을 검색하고, 메일을 읽고, 파일을 열고, 그 결과에 따라 행동하는 AI 에이전트는 바깥에서 가져온 글을 끊임없이 읽습니다. 사용자의 지시와 웹페이지 속 문장은 결국 같은 문맥 창(context window, 모델이 한 번에 읽는 입력 범위)에 함께 들어갑니다. 지시 계층 훈련이나 외부 내용 표시로 둘을 구분하려는 장치가 있지만, 전통적인 소프트웨어가 명령과 데이터를 아예 다른 통로로 나눠 SQL 인젝션(SQL injection, 입력값에 데이터베이스 명령을 섞는 공격) 같은 문제를 막는 것만큼 확실한 분리는 아닙니다. 그래서 신뢰할 수 없는 외부 내용이 모델의 판단과 도구 호출에 끼어들 여지가 남습니다. 이렇게 외부 내용에 심어 둔 지시로 모델을 움직이는 공격을 간접 프롬프트 인젝션(indirect prompt injection)이라고 부릅니다.
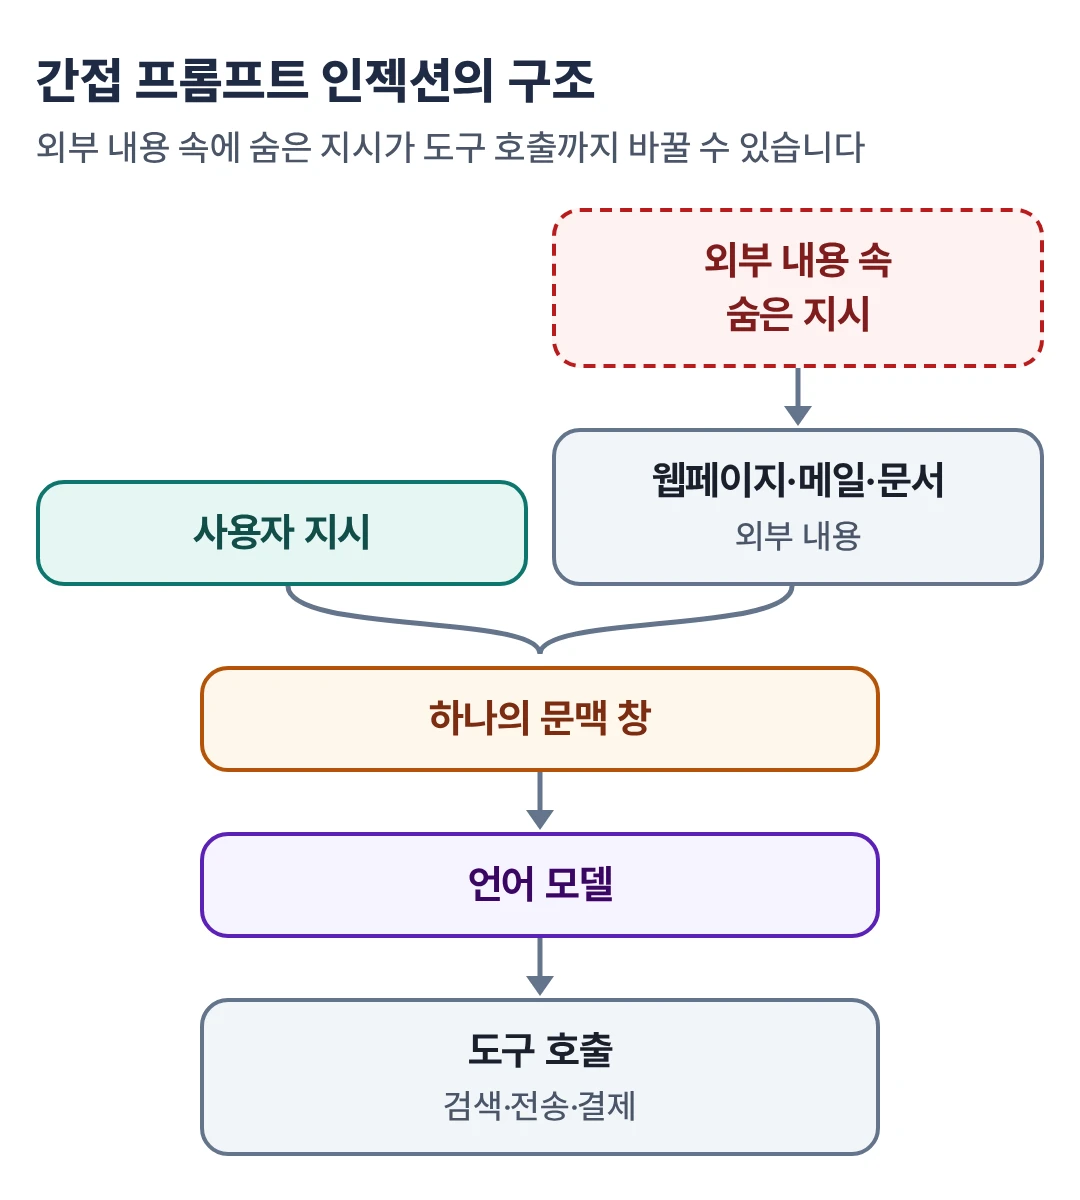
이 이름은 Greshake 등(2023)이 붙였습니다. 공격자가 모델과 직접 대화하지 않아도, 모델이 나중에 읽을 웹페이지나 문서에 지시를 심어 두면 된다는 뜻입니다. 연구진은 당시 Bing의 GPT-4 기반 채팅과 코드 자동 완성 도구에서 데이터 탈취, 기능 변경 같은 피해 시나리오를 시연했습니다. 시험지 숨은 지시문이 노리는 약점과 같은 구조입니다.
그 뒤 실제 제품에서 사례가 이어졌습니다.
| 시점 | 사례 | 내용 |
|---|---|---|
| 2025년 6월 공개 | EchoLeak(CVE-2025-32711), Microsoft 365 Copilot | 보안 업체 Aim Security가 공개했습니다. 공격자가 보낸 메일 한 통으로 사용자가 아무것도 누르지 않아도 Copilot이 내부 자료를 외부로 보내게 만들 수 있었고, Microsoft가 서버 쪽에서 수정했습니다 |
| 2025년 10월 공개 | Perplexity Comet 스크린샷 공격 | 앞에서 본 옅은 글씨 사례입니다. Brave는 근본 원인을 “신뢰할 수 있는 사용자 입력과 신뢰할 수 없는 웹 내용의 경계를 지키지 못한 것”으로 진단했습니다 |
| 2025년 12월 | OpenAI의 Atlas 브라우저 보안 강화 발표 | 프롬프트 인젝션은 사기나 사회공학처럼 완전히 해결되기 어려운 장기 과제라고 밝혔습니다. 영국 국가사이버보안센터(NCSC)도 같은 달 완전히 막지 못할 수 있다고 경고했습니다 |
같은 기반 모델이라도 어떤 도구와 권한이 붙느냐에 따라 위험이 달라진다는 점은 같은 AI 모델인데 왜 기능이 다를까에서 설명한 배포 계층 이야기와 이어집니다. 읽기만 하는 챗봇에서는 엉뚱한 답으로 끝날 일이, 메일을 보내고 결제할 수 있는 에이전트에서는 실제 피해가 됩니다.
방어는 왜 아직 완전하지 않은가
모든 분야에서 방어 연구는 활발하지만, 어느 것도 문제를 끝내지 못했습니다. 공격자가 방어를 알고 적응한다는 점이 공통 이유입니다.
| 방어 | 원리 | 확인된 한계 |
|---|---|---|
| 적대적 훈련(adversarial training) | 적대적 예제를 학습 데이터에 넣어 모델을 단련하는 방식(Madry 등, 2018) | 훈련에 쓴 공격 유형에는 강해지지만 다른 유형에는 여전히 약할 수 있고, 일반 정확도와 계산 비용을 대가로 치릅니다 |
| 입력 전처리·탐지 | 노이즈 제거, 압축, 이상 입력 탐지 | Athalye 등(2018)은 ICLR 2018 방어 9개 중 7개가 기울기를 가리는 방식에 기대고 있었음을 보이고, 그중 6개를 완전히, 1개를 부분적으로 우회했습니다 |
| 센서 융합·다중 모델 합의 | 카메라·라이다·레이더 교차 확인이나 여러 모델의 합의 | 비용이 늘고, 카메라와 라이다를 한 물체로 함께 속이는 공격도 연구됐습니다(Cao 등, 2021). 유령 공격 연구진의 탐지기도 특정 공격 유형을 대상으로 평가됐습니다 |
| 지시 계층·외부 내용 표시 | 사용자 지시를 외부 문서보다 우선하도록 하는 훈련과 외부 내용 구분 표시 | 확률적 방어라 새로운 표현에 뚫릴 수 있습니다. EchoLeak은 Microsoft의 프롬프트 인젝션 분류기를 우회했습니다 |
| 권한 분리 설계 | 신뢰할 수 있는 지시로만 실행 흐름을 정하고 외부 데이터가 그 흐름을 바꾸지 못하게 하는 격리 | Google DeepMind 등의 CaMeL(2025)은 AgentDojo 벤치마크에서 증명 가능한 보안을 갖추고 과제의 77%를 처리했지만, 방어가 없는 시스템(84%)보다 할 수 있는 일이 줄었습니다 |
권한 분리가 가장 근본적인 방향으로 꼽히는 것은 모델이 속지 않기를 기대하는 대신, 속더라도 할 수 있는 일을 제한하기 때문입니다. 시험장 운영과 닮았습니다. 시험지 장치로 AI가 틀리기를 바라기보다 AI에 닿는 통로 자체를 막으려는 것과 같은 발상입니다.
이번 수능과 세무사 시험에서 보도된 적발 경위는 감독관의 관찰, 기기 통제, 당사자의 시인이었습니다. 시험지 장치의 효과는 제한된 입력 조건에서만 관찰됐습니다. IntegrityShield는 PDF를 그대로 올릴 때 상당수 시험지의 풀이를 막았고, Braun 등의 적대적 섭동은 여러 문항을 모았을 때 AI 답을 베낀 답안을 가려낼 가능성을 보였으며, 숭실대 실험은 소형 모델과 일부 상용 모델 반응을 확인했습니다. 종이 시험지를 찍는 실제 시험에서는 어느 것도 검증되지 않았습니다. 사람이 의미 있게 여기지 않는 입력 변화가 시스템 판단을 바꿀 수 있다는 같은 성질이, 자율주행 인식과 얼굴 인식에서는 단서의 오분류로, AI 에이전트에서는 지시와 데이터가 충분히 분리되지 않은 틈으로 나타나 훨씬 심각한 문제가 됐습니다. 이미지와 텍스트를 함께 다루는 모델의 기본 구조는 멀티모달 AI 가이드에서 더 볼 수 있습니다.
참고자료
사건 보도(2026년 11월 20일 확인, 교육부 발표는 보도로 확인)
- 한국경제, AI 안경 쓰고 ‘신개념 컨닝’…수능 앞두고 ‘비상’ 걸렸다, 2026-11-11
- 머니투데이, “수능은 어쩌나” 세무사 시험장 뚫리자 발칵…’AI 부정행위’ 처벌은?, 2026-11-16
- 경향신문, ‘AI 부정행위’ 세무사 수석합격자, 13시간 경찰 조사받고 귀가, 2026-11-17
- 한국경제, 우려가 현실이 된 수능… AI 부정행위 잇단 적발, 2026-11-19
- 서울경제, 수능 도중 스마트안경·카메라 적발…AI ‘부정행위 의심’ 수험생들 잇따라 경찰 입건, 2026-11-20
- 대전일보, 수능장서 ‘스마트안경’ 걸린 20대 수험생 입건… 조력자 가능성도 수사, 2026-11-20
- 대전일보, 충남 천안 수능 스마트안경 수험생 사용 시인, 2026-11-20
- 경향신문, 교육부 “수능 스마트기기 부정행위 111건 적발…재난문자로 54건”, 2026-11-20
- 파이낸셜뉴스(뉴스1), ‘수능 끝’ 與, AI 부정시험 방지 입법 본격화, 2026-11-20
숭실대 예비 실험 보도(2026년 11월 20일 확인)
- 지디넷코리아, “시험지만으로 AI 커닝 방지”…숭실대, 실험 결과 공개, 2026-11-17
- 한겨레, ‘AI 커닝’ 막으려 시험지에 ‘AI 함정’ 심는다…역발상 연구 주목, 2026-11-17
- 중앙일보, “시험지에 AI 교란 정보 넣자”…”촬영 방지 물결무늬도 도움”, 2026-11-19
- KBS 뉴스, “AI를 속여라”…시험지에 ‘AI 함정’ 역발상, 2026-11-19
- KBS News 유튜브, ‘AI 커닝’ 못 뚫는 함정 심었다…시험지 역발상 ‘반전’, 2026-11-20
숨은 지시문과 시험 문항
- AI Incident Database, Report 5475(닛케이 아시아 기사 수록), 2025
- Z. Lin, Hidden Prompts in Manuscripts Exploit AI-Assisted Peer Review, arXiv 2025 / Communications of the ACM 2026
- X. Guo 외, Too Easily Fooled? Prompt Injection Breaks LLMs on Frustratingly Simple Multiple-Choice Questions, arXiv 2025
- Brave, Unseeable prompt injections in screenshots, 2025-10-21
- A. R. Shekhar 외, IntegrityShield: A System for Ethical AI Use and Authorship Transparency in Assessments, EACL 2026 System Demonstrations
- T. Braun 외, Fighting Fire with Fire: On the Feasibility of Protecting Exercises Against AI Cheating, arXiv 2026
적대적 예제와 멀티모달 모델
- A. Kurakin, I. Goodfellow, S. Bengio, Adversarial examples in the physical world, 2016
- Y. Dong 외, How Robust is Google’s Bard to Adversarial Image Attacks?, 2023
- E. Bagdasaryan 외, Abusing Images and Sounds for Indirect Instruction Injection in Multi-Modal LLMs, 2023
- X. Qi 외, Visual Adversarial Examples Jailbreak Aligned Large Language Models, 2023
- G. Goh 외, Multimodal Neurons in Artificial Neural Networks, Distill 2021
- The Register, CLIP 글자 공격 보도, 2021-03-05
AI 출력 워터마크
- Anthropic 지원 센터, Claude가 AI 생성 콘텐츠를 표시하는 방법 / How Claude marks AI-generated content, 2026-11-20 확인
- TechCrunch, OpenAI will start watermarking ChatGPT’s text in the EU, 2026-10-05
- OpenAI, Our approach to EU text provenance rules, 2026-10-05
- S. Dathathri 외, Scalable watermarking for identifying large language model outputs, Nature 634, 2024
- J. Kirchenbauer 외, A Watermark for Large Language Models, ICML 2023
자율주행·얼굴 인식
- K. Eykholt 외, Robust Physical-World Attacks on Deep Learning Visual Classification, CVPR 2018
- Tencent Keen Security Lab, Experimental Security Research of Tesla Autopilot, 2019
- The Register, McAfee 속도 표지판 실험 보도, 2020-02-20
- B. Nassi 외, Phantom of the ADAS, ACM CCS 2020
- Y. Cao 외, Adversarial Sensor Attack on LiDAR-based Perception in Autonomous Driving, ACM CCS 2019
- Y. Cao 외, Invisible for both Camera and LiDAR: Security of Multi-Sensor Fusion based Perception in Autonomous Driving Under Physical-World Attacks, IEEE S&P 2021
- M. Sharif 외, Accessorize to a Crime: Real and Stealthy Attacks on State-of-the-Art Face Recognition, ACM CCS 2016
AI 에이전트와 방어
- E. Wallace 외, The Instruction Hierarchy: Training LLMs to Prioritize Privileged Instructions, 2024
- K. Greshake 외, Not what you’ve signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection, 2023
- P. Reddy, A. S. Gujral, EchoLeak: The First Real-World Zero-Click Prompt Injection Exploit in a Production LLM System, 2025
- TechCrunch, OpenAI says AI browsers may always be vulnerable to prompt injection attacks, 2025-12-22
- A. Madry 외, Towards Deep Learning Models Resistant to Adversarial Attacks, ICLR 2018
- A. Athalye, N. Carlini, D. Wagner, Obfuscated Gradients Give a False Sense of Security, ICML 2018
- E. Debenedetti 외, Defeating Prompt Injections by Design, 2025