DGX Spark(GB10), 1,200만 원 주고 살 만할까? 한 대로 사내 AI를 돌려 본 실측 기록
외부로 보내기 어려운 자료를 다루면서 100B급 모델을 상시 띄워 두고 서비스 몇 개가 나눠 쓰려는 곳이라면, DGX Spark 계열(GB10) 장비는 지금 가격에도 후보로 남습니다. 외부 처리가 가능하다면 비용은 API가 훨씬 싸고, 생성 속도가 우선이면 비슷한 값의 Mac Studio가 더 빠릅니다. 저희가 운영하는 GB10 한 대(Dell Pro Max with GB10, 128GB)에는 125B 규모의 MoE(Mixture of Experts, 전문가 혼합) 비전 모델과 임베딩·리랭커 모델이 함께 올라가 있습니다. 생각 모드(thinking mode)를 끄고 출력을 256토큰으로 고정했을 때 단일 요청은 초당 약 32-34토큰을 생성했고, 동시 8건에서 합산 초당 약 96토큰으로 포화됐습니다. 제목의 1,200만 원은 이 장비 128GB/2TB 구성의 2026년 11월 20일 다나와 최저가(1,199만 원)로, 국내 출시 직후 최저가(664.4만 원)의 약 1.8배입니다.
11월 6일부터 20일까지 사내 서비스를 이 장비에 연결하며 남긴 기록에, 20일 저녁 이 글을 위해 다시 잰 결과와 공개된 가격·사양 자료를 더했습니다. 가격과 사양 분석은 구매 전에 세운 계획이 아니라 글을 쓰는 2026년 11월 20일 시점의 판단 틀입니다.
1. 이 장비에 올려 둔 것: 대화 모델 하나와 보조 모델 둘
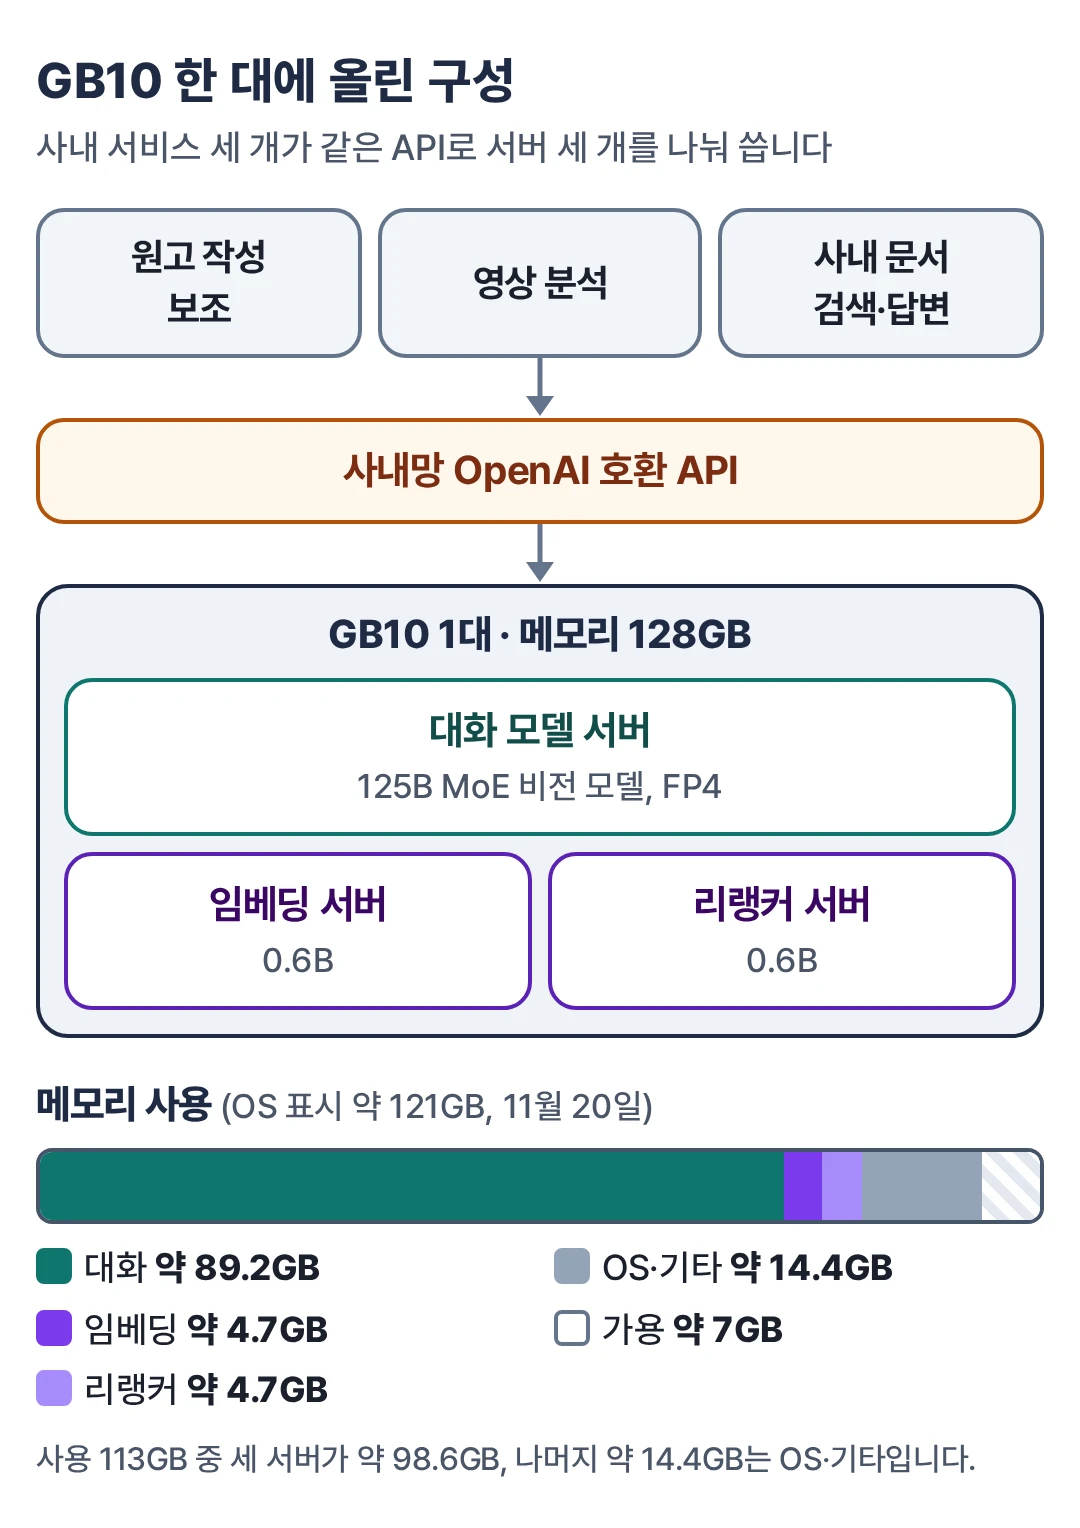
장비 한 대에 vLLM 서버 세 개가 떠 있고, 사내 서비스 여러 개가 같은 OpenAI 호환 API로 이 서버들을 함께 씁니다. 이 글에 나오는 서비스는 원고 작성 보조, 영상 분석, 사내 문서 검색·답변 세 가지입니다. 아래 구성은 11월 14일 재기동한 뒤 11월 20일에 확인한 상태이며, 그 전 측정 때도 세부 설정이 똑같았다고 보장할 수는 없습니다.
| 항목 | 값 |
|---|---|
| 대화 모델 | nvidia/Qwen3.8-Flash-Next-FP4-Local: 총 125B, 토큰당 활성 6B인 MoE, 이미지·영상 입력 지원, 체크포인트 디스크 약 96GiB |
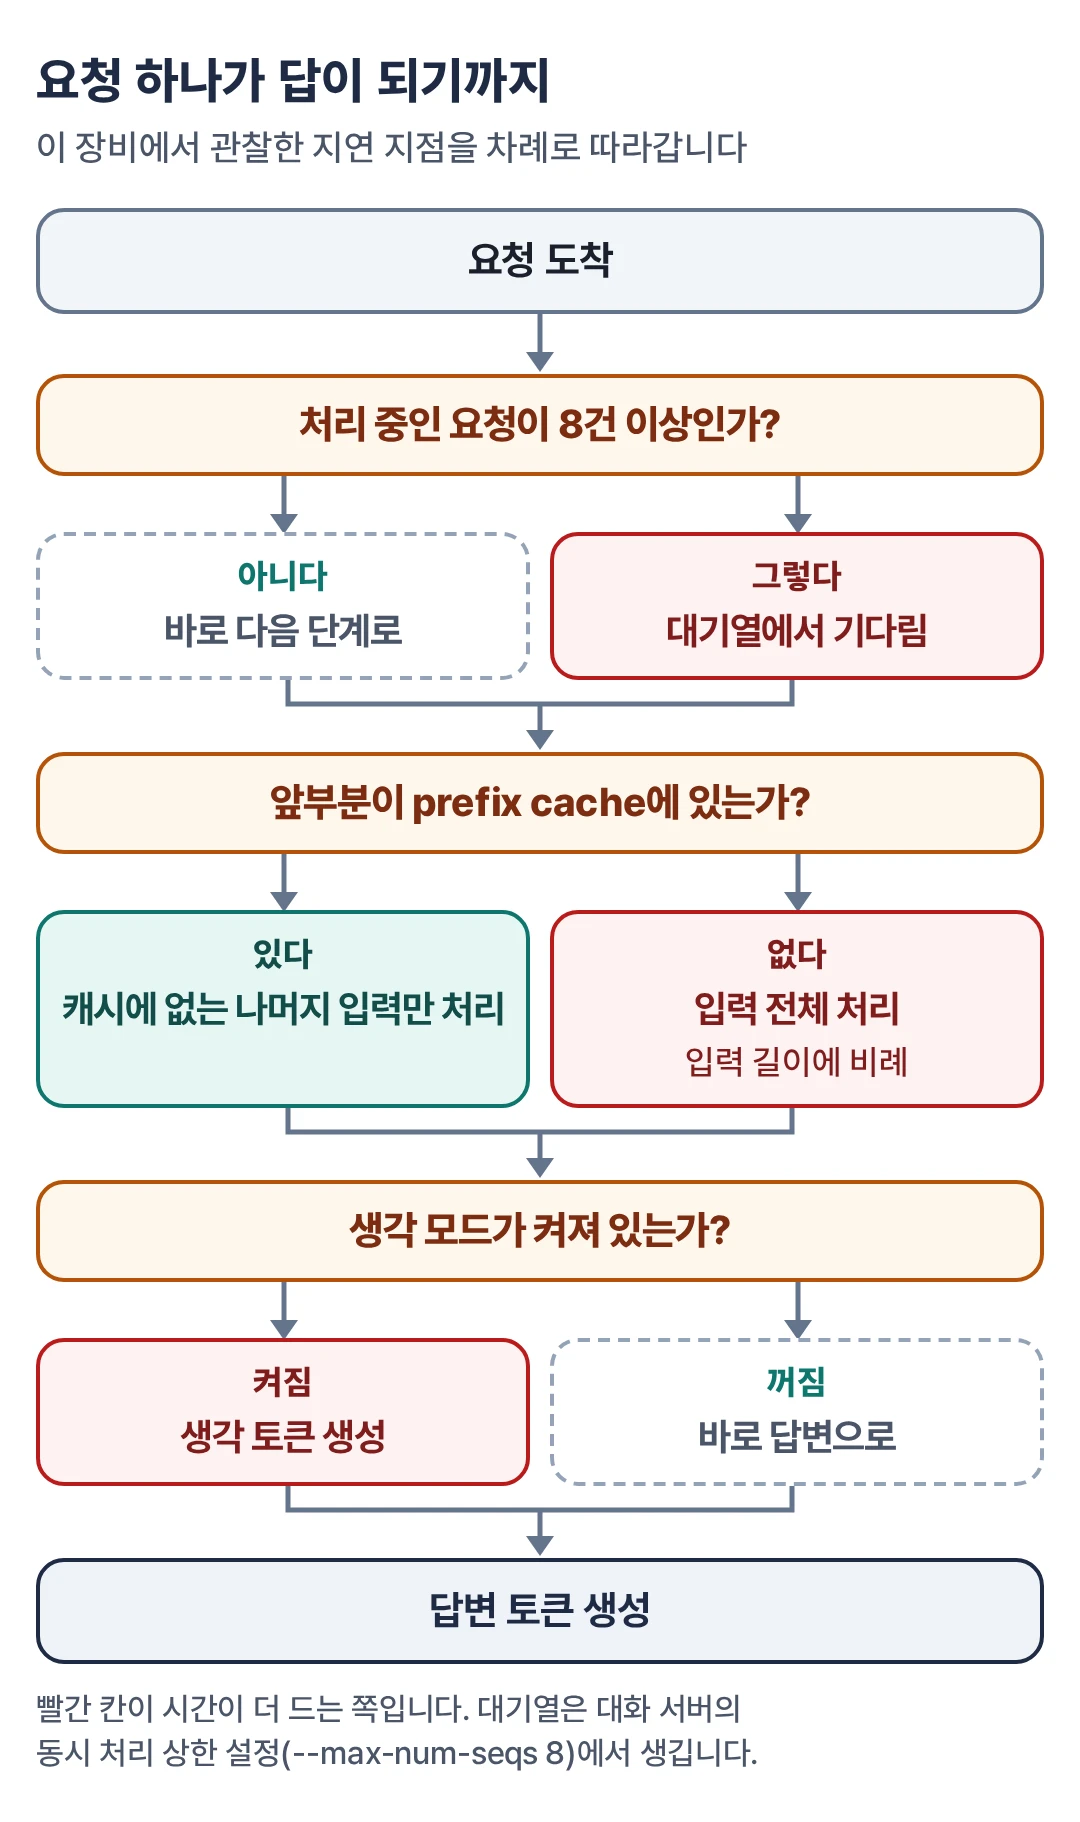
| 서빙 | 커뮤니티 vLLM 빌드(b12x 커널), MTP(Multi-Token Prediction, 다중 토큰 예측) 방식의 추측 디코딩(speculative decoding) 후보 토큰 4개, prefix cache(앞부분이 같은 입력의 계산 결과를 재사용하는 캐시) 켬, --max-num-seqs 8, KV cache(KV 캐시) fp8 12GiB |
| 보조 모델 | Qwen3-Embedding-0.6B(1,024차원), Qwen3-Reranker-0.6B |
| 메모리 | 물리 128GB 중 OS 표시 약 121GB. 사용 113GB, 가용 약 7GB |
| 프로세스별 관측 | 대화 약 89.2GB, 임베딩·리랭커 각 약 4.7GB |
이 체크포인트는 압축 형식이 새로워 공식 vLLM이 아직 읽지 못하므로 NVIDIA 모델 카드가 안내하는 커뮤니티 컨테이너를 씁니다. NVIDIA의 DGX Spark 공식 플레이북도 128GB 기기용 권장 구성에 이 모델과 같은 컨테이너를 올려 두었습니다. 그런데 같은 플레이북은 “한 번에 모델 앱 하나부터 시작하라”고 권합니다. 대화 모델 옆에 서버 두 개를 더 띄운 저희 구성은 그보다 빡빡하게 쓰는 셈입니다. 가용 메모리가 7GB 남짓이라는 숫자가 그 사정을 보여 줍니다.
이 장비 한 대에 96GiB짜리 체크포인트와 KV cache, 보조 모델 두 개를 함께 올려 둘 수 있었습니다. 이 장비에서 확인한 가장 분명한 장점입니다. 모델 크기와 문맥 길이로 필요한 메모리를 미리 가늠하려면 LLM VRAM 계산기를 쓸 수 있습니다. “여러 서비스가 상주한다”와 “여러 서비스가 동시에 부하를 걸어도 버틴다”는 다른 이야기이고, 후자는 이 글에서 재지 않았습니다.
2. 가격: 출시 때는 이랬는데, 지금은 이렇습니다
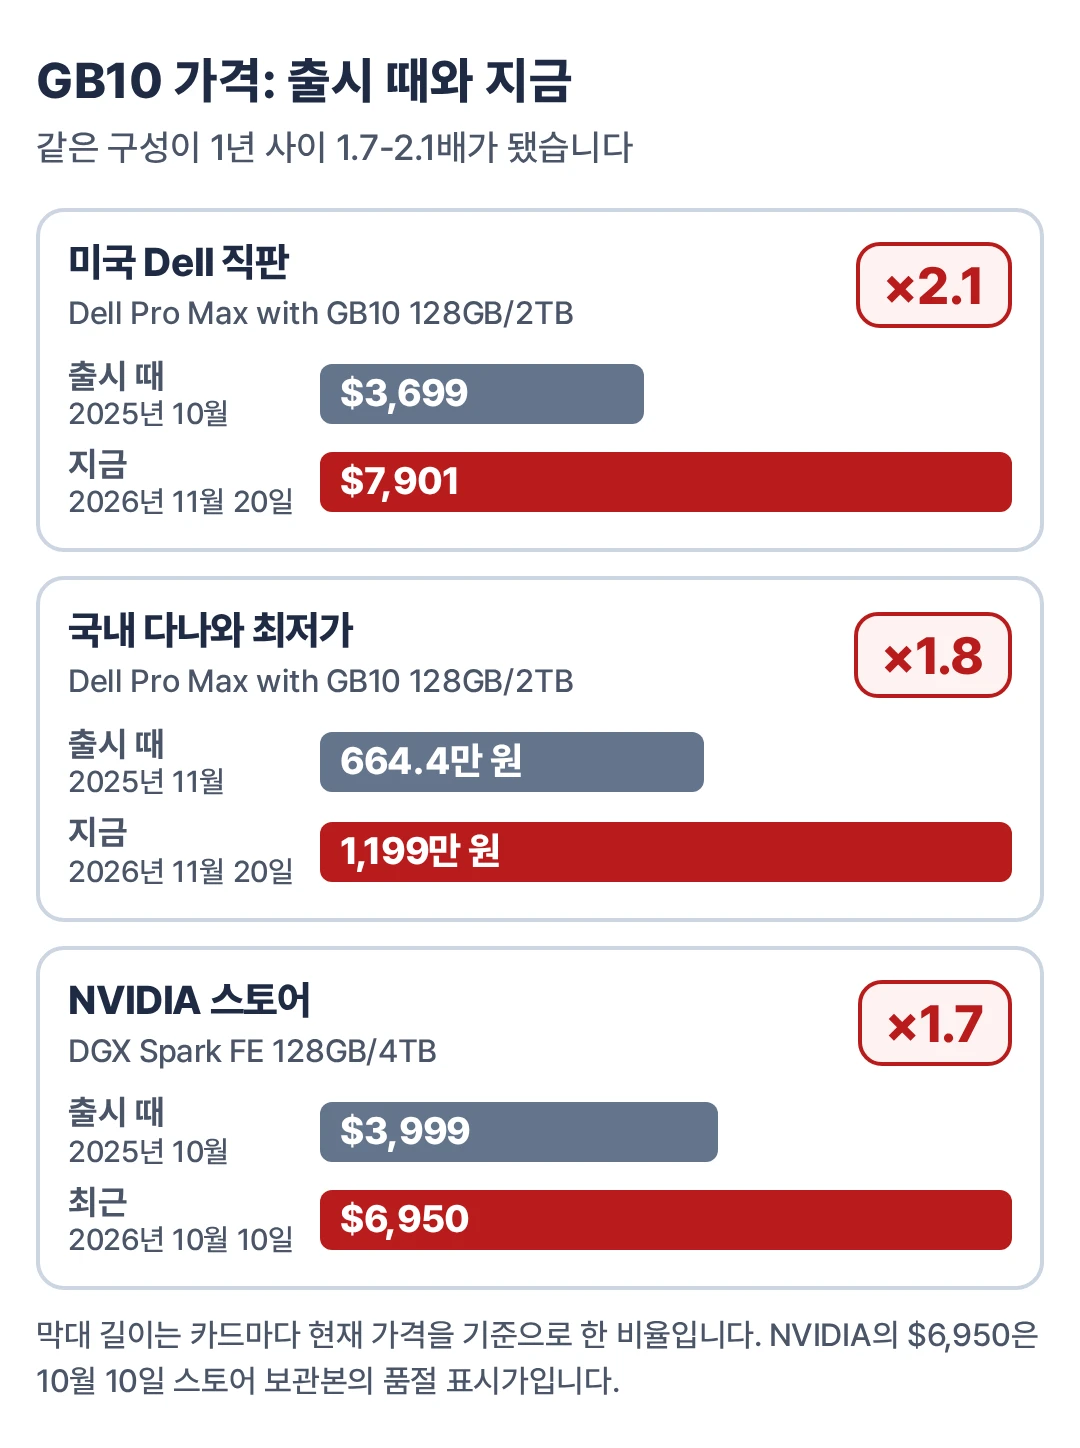
GB10 장비 가격은 1년 사이 두 배 안팎으로 올랐습니다. 미국 Dell 직판 128GB/2TB는 2025년 10월 $3,699에서 2026년 11월 20일 $7,901이 됐고, 국내 다나와 최저가는 같은 구성이 664.4만 원에서 1,199만 원이 됐습니다. 저희가 실제로 얼마에 샀는지는 이 글에서 다루지 않습니다.
{"series":[{"type":"line","name":"Dell 128GB/2TB (Dell.com)","data":[{"time":"2025-10-19","value":3699},{"time":"2025-12-09","value":3699},{"time":"2026-01-30","value":4139.34},{"time":"2026-02-17","value":4191.34},{"time":"2026-04-17","value":4990.7},{"time":"2026-07-20","value":5688.18},{"time":"2026-09-08","value":5774.39},{"time":"2026-11-20","value":7901}]},{"type":"line","name":"NVIDIA DGX Spark FE 128GB/4TB","data":[{"time":"2025-10-15","value":3999},{"time":"2025-11-13","value":3999},{"time":"2026-02-23","value":4699},{"time":"2026-10-02","value":6950},{"time":"2026-10-10","value":6950}]}],"height":320,"options":[],"title":"미국 직판 표시가(달러). Dell 128GB/2TB와 NVIDIA DGX Spark FE 128GB/4TB"}| Time | Dell 128GB/2TB (Dell.com) |
|---|---|
| 2025-10-19 | 3699 |
| 2025-12-09 | 3699 |
| 2026-01-30 | 4139.34 |
| 2026-02-17 | 4191.34 |
| 2026-04-17 | 4990.7 |
| 2026-07-20 | 5688.18 |
| 2026-09-08 | 5774.39 |
| 2026-11-20 | 7901 |
| Time | NVIDIA DGX Spark FE 128GB/4TB |
|---|---|
| 2025-10-15 | 3999 |
| 2025-11-13 | 3999 |
| 2026-02-23 | 4699 |
| 2026-10-02 | 6950 |
| 2026-10-10 | 6950 |
Dell 값은 Dell.com 구성 페이지의 보관본과 11월 20일 페이지에서 읽은 표시가입니다. 일부 값은 4TB 기본가에서 2TB 옵션 차액을 빼 계산했습니다. NVIDIA 값은 NVIDIA 스토어 표시가와 가격 변경 공지입니다.
{"series":[{"type":"line","name":"128GB/2TB","data":[{"time":"2025-11-01","value":664.4},{"time":"2025-12-01","value":637.8},{"time":"2026-02-01","value":637.8},{"time":"2026-03-01","value":770},{"time":"2026-06-01","value":939.9},{"time":"2026-08-01","value":939.9},{"time":"2026-09-01","value":939.9},{"time":"2026-09-08","value":1199},{"time":"2026-11-20","value":1199}]},{"type":"line","name":"128GB/4TB","data":[{"time":"2025-11-01","value":719.4},{"time":"2025-12-01","value":690.6},{"time":"2026-02-01","value":690.6},{"time":"2026-03-01","value":1050},{"time":"2026-06-01","value":1069},{"time":"2026-08-01","value":1069},{"time":"2026-09-01","value":1069},{"time":"2026-09-08","value":1399},{"time":"2026-11-20","value":1399}]}],"height":320,"options":[],"title":"국내 다나와 최저가 추이(만 원). Dell Pro Max with GB10"}| Time | 128GB/2TB |
|---|---|
| 2025-11-01 | 664.4 |
| 2025-12-01 | 637.8 |
| 2026-02-01 | 637.8 |
| 2026-03-01 | 770 |
| 2026-06-01 | 939.9 |
| 2026-08-01 | 939.9 |
| 2026-09-01 | 939.9 |
| 2026-09-08 | 1199 |
| 2026-11-20 | 1199 |
| Time | 128GB/4TB |
|---|---|
| 2025-11-01 | 719.4 |
| 2025-12-01 | 690.6 |
| 2026-02-01 | 690.6 |
| 2026-03-01 | 1050 |
| 2026-06-01 | 1069 |
| 2026-08-01 | 1069 |
| 2026-09-01 | 1069 |
| 2026-09-08 | 1399 |
| 2026-11-20 | 1399 |
다나와 상품 페이지의 최저가 추이 데이터입니다. 월별 값은 각 월의 1일에 놓았고, 9월 8일은 주별 추이, 11월 20일은 상품 페이지 표시가입니다. 부가세 포함입니다.
국내 가격은 2026년 3월과 9월 둘째 주에 크게 뛰었습니다. 2TB는 9월 1일 939.9만 원에서 9월 8일 1,199만 원으로 한 주 만에 260만 원 가까이 올랐고, 그 뒤로 그대로입니다. 출시 무렵에는 국내가가 미국 표시가의 원화 환산(부가세 포함)보다 약 15% 비쌌는데, 지금은 그 차이가 약 3%로 줄었습니다(하나은행 매매기준율, 2025-10-15 1,422.50원과 2026-11-20 1,335.50원 기준).
차트에 담기지 않는 관측점은 표로 정리했습니다.
| 제품·구성 | 출시 무렵 | 2026-11-20 | 가격 유형 |
|---|---|---|---|
| Dell 128GB/4TB, 미국 | $3,998.99 | $10,351 | Dell 직판. 11월 값은 2TB 표시가에 4TB 옵션 차액(+$2,450)을 더한 값 |
| NVIDIA DGX Spark FE 128GB/4TB, 국내 | 715만 원 | 1,194만 원 | 출시가는 2025년 7월 예약 판매 때 확정된 값, 현재가는 다나와 정식 유통 최저가 |
| ASUS Ascent GX10 128GB/1TB, 국내 | 499.9만 원 | 939만 원 | 다나와 최저가(유통사 두 곳 중 낮은 값) |
| HP ZGX Nano G1n 128GB/4TB, 국내 | 879.2만 원(2026-03) | 1,100만 원 | 다나와 최저가 |
| GB10 64GB 모델, 미국 | 2026-10-23 출시 | $4,999부터 | 파트너사 전용, NVIDIA 직판 없음 |
미국 Dell 페이지는 11월 20일 “기술 문제로 이 작업을 할 수 없다”는 안내를 함께 띄우고 있어 실제 주문 가능 여부는 확인하지 못했습니다. NVIDIA FE의 $6,950은 10월 10일 스토어 보관본의 품절 표시가이며, 11월 20일 스토어는 응답하지 않았습니다.
NVIDIA는 2026년 2월 가격을 $4,699로 올리며 “업계 전반의 메모리 공급 제약”을 이유로 들었습니다. 시장조사업체 TrendForce는 같은 달 LPDDR5X 계약 가격이 2026년 1분기에 전 분기보다 약 90% 오를 것으로 전망했습니다. GB10은 128GB LPDDR5X를 기판에 직접 붙인 구조라 이 영향을 그대로 받습니다. 10월에는 128GB 가격이 $6,950까지 오르는 사이 64GB 모델이 $4,999부터 새로 나왔는데, 이 값도 128GB 출시가 $3,999보다 높습니다.
3. 사양으로 보면 메모리는 크고 대역폭은 좁습니다
GB10은 Arm CPU와 Blackwell GPU가 128GB 통합 메모리(unified memory)를 나눠 쓰는 작은 상자입니다. 사양표에서 판단에 가장 중요한 숫자는 메모리 128GB와 대역폭 273GB/s 두 개입니다.
| 항목 | GB10(Dell Pro Max with GB10 기준) |
|---|---|
| CPU | Arm 20코어(Cortex-X925 10 + Cortex-A725 10) |
| GPU | Blackwell, 5세대 Tensor Core. “FP4 최대 1 PFLOP”은 희소성(sparsity)을 가정한 값 |
| 메모리 | LPDDR5x 128GB(64GB 구성도 있음), 256비트, 273GB/s |
| 저장 장치 | Dell은 2TB(M.2 2230, QLC) 또는 4TB(TLC), PCIe Gen4 |
| 네트워크 | 10GbE, ConnectX-7 QSFP 2개(200Gbps), Wi-Fi 7 |
| 전원·크기 | Dell 280W USB-C 어댑터(FE는 240W), 150×150×51mm |
| 운영체제 | DGX OS(Ubuntu 기반), aarch64 |
LLM이 토큰을 하나씩 생성(decode)할 때는 매번 활성 가중치를 메모리에서 읽어야 하므로 속도가 대역폭에 묶입니다. 반대로 긴 입력을 한꺼번에 계산하는 입력 처리(prefill)는 연산 성능을 더 탑니다. GB10은 이 둘 중 입력 처리 쪽이 상대적으로 강한 장비입니다.
| 장비 | 메모리 | 메모리 대역폭 |
|---|---|---|
| AMD Ryzen AI Max+ 395(Strix Halo) | 최대 128GB | 256GB/s |
| GB10(DGX Spark 계열) | 128GB | 273GB/s |
| Apple Mac Studio M5 Max | 최대 128GB | 614GB/s |
| Apple Mac Studio M5 Ultra | 최대 512GB | 1.2TB/s |
| NVIDIA RTX 5090 | 32GB | 약 1.8TB/s |
| NVIDIA RTX PRO 6000 Blackwell | 96GB | 약 1.8TB/s |
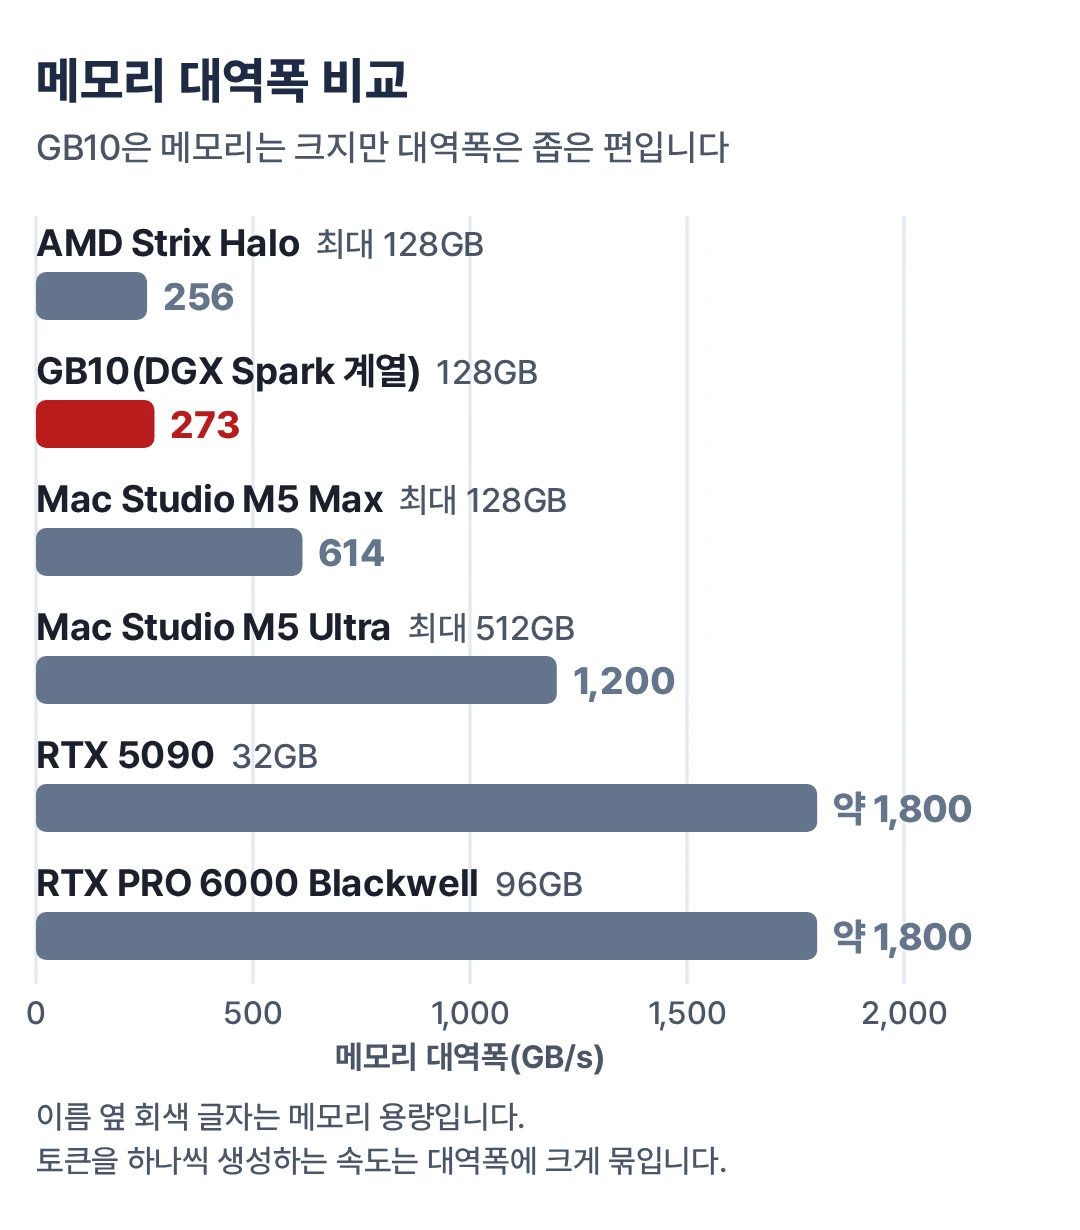
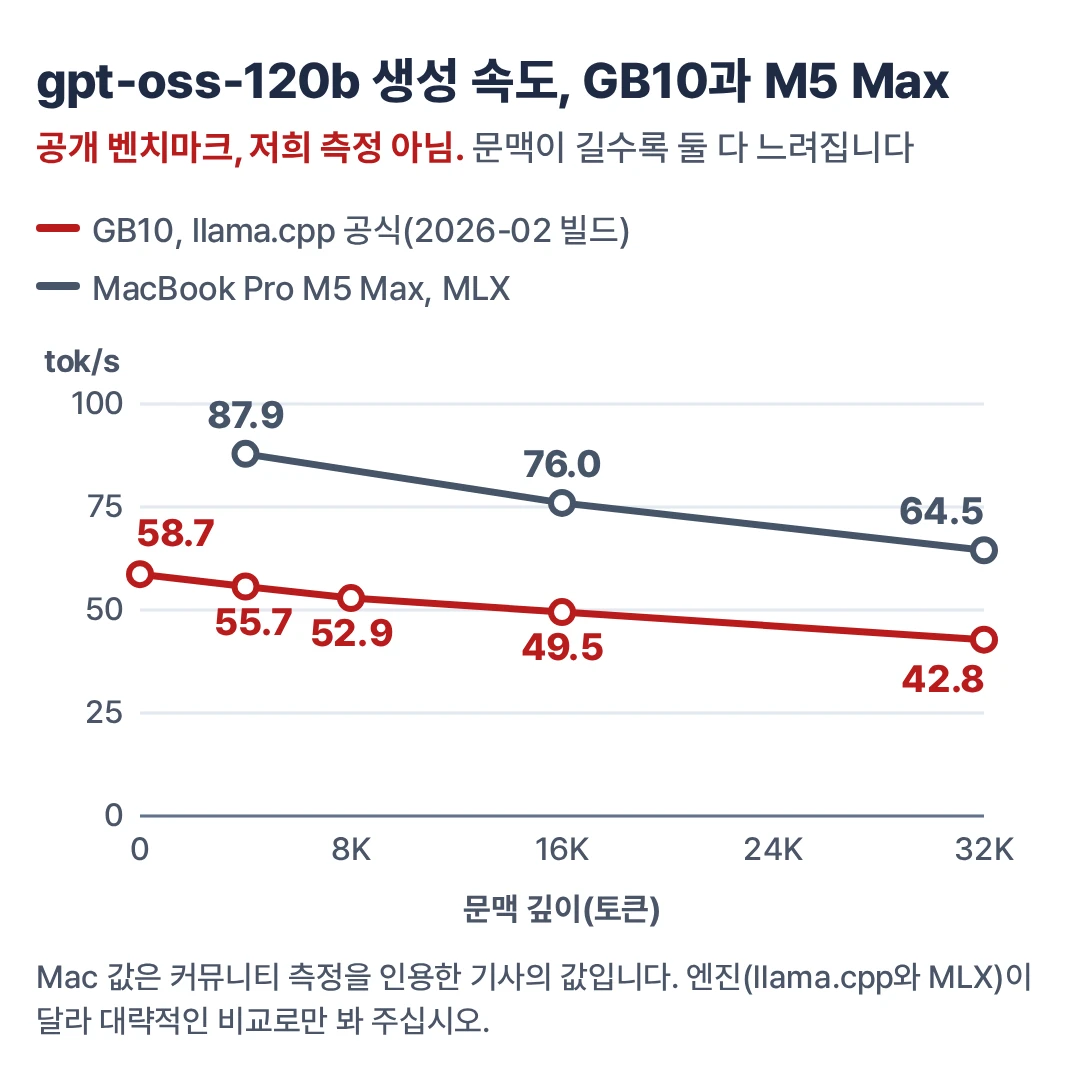
저희 모델은 토큰 하나에 약 6B 파라미터만 활성화되는데, 정밀도별 크기를 더하면 토큰당 읽는 양이 약 5.4-6.0GB입니다. 273GB/s로 나누면 추측 디코딩 없이 요청 하나를 처리할 때의 이론 상한은 초당 약 46-51토큰입니다. 저희가 계산한 추정치이고, 실제로 커뮤니티에서 추측 디코딩 없이 잰 값은 초당 약 23-25토큰이었습니다. 비교 대상으로 자주 쓰이는 gpt-oss-120b는 llama.cpp 공식 벤치마크에서 초당 58.7토큰(2026년 2월 빌드)이 나왔고, 빌드에 따라 공개 결과가 약 46-61토큰까지 갈립니다. 같은 하드웨어라도 소프트웨어 성숙도가 속도를 크게 바꾼다는 뜻입니다.
4. 11월 6일, 서비스 연결 시험에서 생각 모드가 답을 비웠습니다
11월 6일에는 원고 작성 보조 서비스의 연결을 시험했습니다. OpenAI Responses 호환 API에 JSON 스키마로 출력 형식을 강제하는 방식이고, 운영에 켜기 전에 추론 설정·출력 상한·시간 제한의 값을 정하려고 시험했습니다. 입력은 모두 합성 자료였습니다.
이 모델은 기본값에서 답을 쓰기 전에 생각 토큰을 먼저 냅니다. 문제는 그 생각 토큰이 출력 상한을 함께 쓴다는 점이었습니다.
| 단계 | 설정 | 결과 |
|---|---|---|
| 사전 소량 호출 | 출력 상한 64 | 출력 전체가 생각 토큰, 본문 없음 |
| 〃 | reasoning.effort=low(1회) | 생각 토큰이 줄지 않음 |
| 격리 환경 시험, 과업 8종 14회 | 추론 설정 기본값, 상한 3,072/2,048 | 14회 모두 상한을 생각 토큰으로 소진, 본문 없음, 58.6-107.4초 |
| 상한만 상향, 3회 | 상한 16,000 | 1회는 479.8초 동안 16,000토큰을 모두 생각에 쓰고 잘림, 1회는 본문 자리에 추측한 JSON이 들어감 |
| 생각 모드 끔(측정 도구가 주입), 21회 | reasoning.effort=none | 18회 성공. 잘림 2회는 긴 입력 과업의 상한 부족 |
| 서비스 코드로 반영 후 재측정, 22회 | thinking=disabled 설정이 reasoning.effort=none으로 전달, 과업별 상한 일부 조정 | 21회 성공, 잘림 0, 생각 토큰 0, 최장 67.0초 |
마지막 두 단계의 나머지 실패 1회씩은 입력 항목이 비어 있던 시험용 설정에서 결과 목록이 0개로 나온 경우입니다.
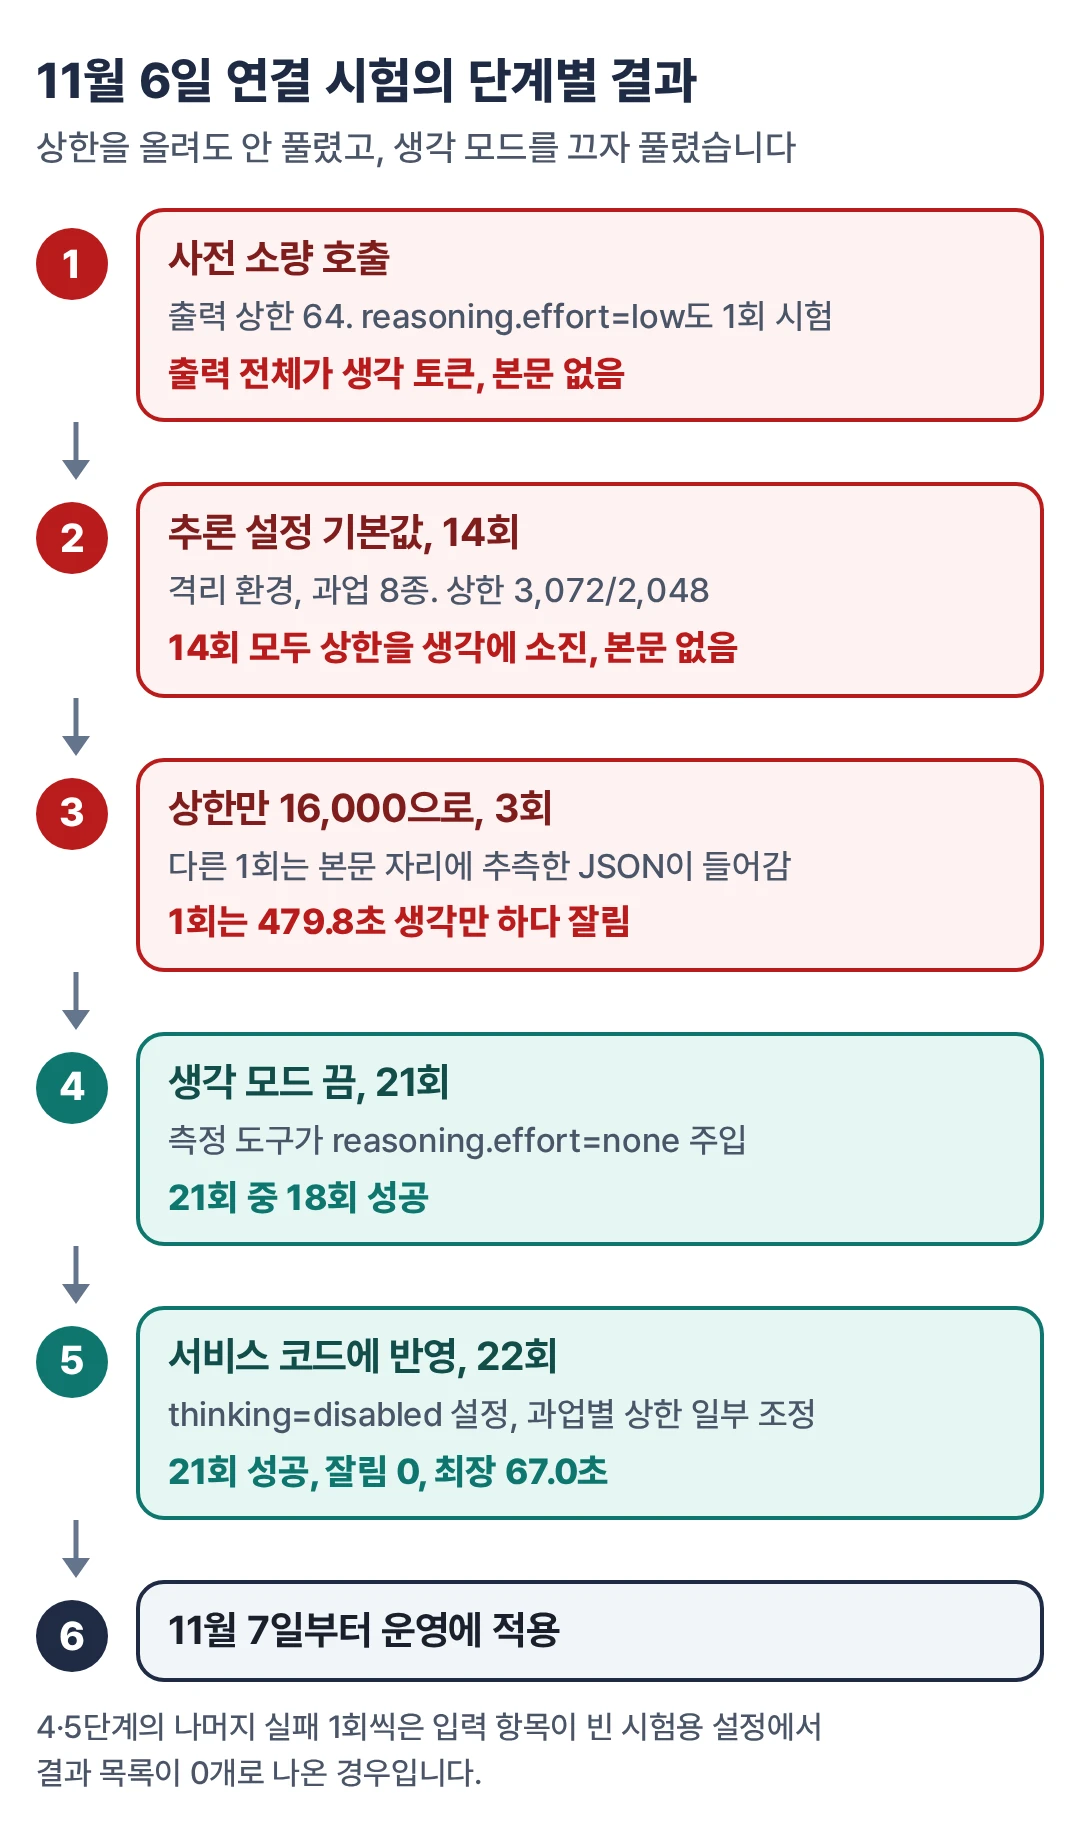
상한을 올리는 것으로는 풀리지 않았습니다. 생각 토큰 수가 2,839개에서 16,000개 이상까지 들쭉날쭉했고, 그만큼 시간도 늘었습니다. 생각 모드를 끄자 성공률이 올랐고, 다음 날인 11월 7일부터 운영에도 이 설정을 적용했습니다. 추론을 켜고 끄는 선택이 비용과 지연에 어떤 영향을 주는지는 추론 effort와 비용·지연 글에서 더 다뤘습니다.
5. 11월 7일, 생성률을 따로 쟀습니다
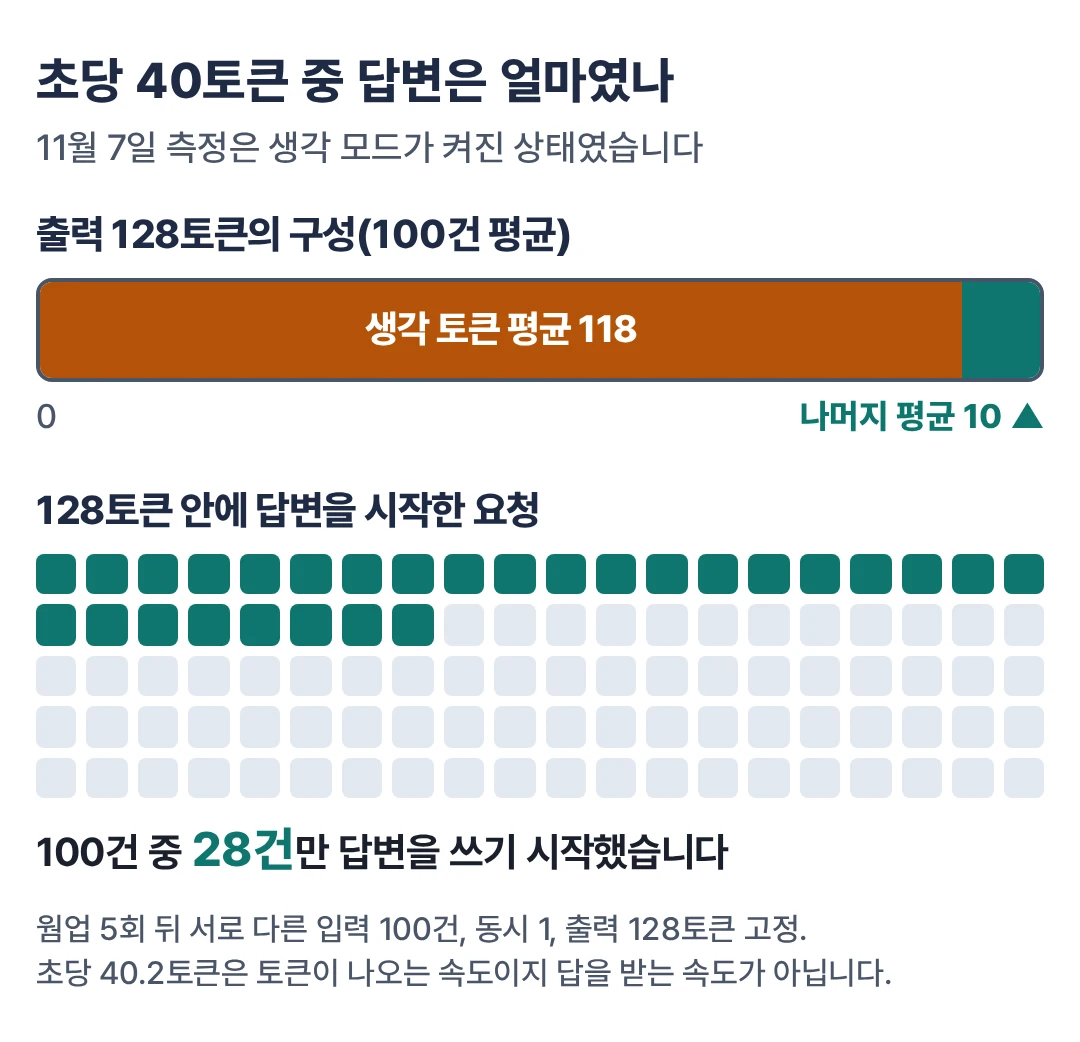
서비스와 별개로 장비의 기본 속도를 재는 시범 측정을 했습니다. 같은 사내망의 다른 기기에서 표준 API로 요청했고, 웜업 5회 뒤 서로 다른 입력 100건을 동시 1로 보냈습니다. 출력은 ignore_eos로 항상 128토큰을 생성하게 고정했습니다. 출력 길이가 요청마다 다르면 요청끼리 시간을 비교할 수 없기 때문입니다. 요청마다 고유 번호를 붙여 prefix cache가 재사용되지 않게 했고, 생각 모드는 기본값(켜짐) 그대로였습니다.
| 측정 | 결과 |
|---|---|
| 전체 지연(128토큰) | p50 3.42초, p99 4.00초 |
| 첫 토큰 시간(TTFT, Time To First Token) | p50 0.27초 |
| 요청당 생성률 | p50 초당 40.2토큰 |
| 동시 2 / 동시 4 합산 처리량 | 초당 53.0 / 77.2토큰 |
| 임베딩(약 42토큰 1문장) | p50 11.1ms |
| 리랭커(질의+문서 5개, 약 556토큰) | p50 20.5ms |
동시 2·4는 각 20건이라 경향 확인 수준입니다. 합산 처리량은 그 단계의 전체 출력 토큰을 경과 시간으로 나눈 값입니다.
초당 40토큰이라는 숫자는 답변 속도로 읽으면 안 됩니다. 128토큰 중 평균 118개가 생각 토큰이었고, 128토큰 안에 실제 답변을 쓰기 시작한 요청은 100건 중 28건뿐이었습니다. 이 값은 “토큰이 나오는 속도”이지 “답을 받는 속도”가 아닙니다.
첫 토큰 시간은 처음 7건이 약 0.05초였다가 8번째부터 약 0.27초로 계단처럼 바뀌었습니다. 전체 지연에는 변화가 없었고, 원인은 확인하지 못했습니다.
6. 11월 10-20일, 영상 분석과 문서 검색 서비스에서 바꾼 것
영상 분석에서는 한 번에 보내는 장면 수를 바꿨고, 문서 검색에서는 생각 모드를 끈 뒤 캐시와 임베딩 처리량을 다시 쟀습니다.
영상 분석: 한 번에 보내는 장면 수를 늘렸습니다
영상 분석 서비스는 영상에서 뽑은 장면(폭 512px JPEG)을 여러 장씩 묶어 대화 모델에 보내고 장면 설명을 받습니다. 생각 모드는 끈 상태입니다. 11월 10일 공개 애니메이션 영상 1편(10분 34초)으로 쟀더니, 1초 간격으로 뽑은 설정에서 전체 분석에 17분 33초가 걸렸고 그중 약 90%가 이 비전 단계였습니다. 4장씩 묶은 호출 하나에 약 7.3초가 걸렸습니다.
| 같은 48장을 한 번에 몇 장씩 보냈나 | 비전 단계 시간 | 빠진 장면 |
|---|---|---|
| 4장 | 107.4초 | 0 |
| 16장 | 75.6초 | 0 |
| 24장 | 68.8초 | 0 |
시험 뒤 기본값은 4장에서 16장으로 바꿨습니다. 설명이 얼마나 정확했는지는 평가하지 않았고, 영상 1편을 설정마다 한 번씩 돌린 결과입니다.
문서 검색·답변: 생각 모드를 끄고, 캐시를 확인하고, 숫자를 바로잡았습니다
사내 문서 검색·답변 서비스는 11월 16일부터 개발하며 이 장비에 연결해 시험했습니다. 이 서비스는 문서 조각을 근거로 넣고 답하게 하는 RAG(Retrieval-Augmented Generation, 검색 증강 생성) 구조입니다.
11월 17일에는 근거 약 9천 토큰과 질문을 넣고 출력 상한을 300으로 두었더니, 생각 모드가 기본으로 켜진 상태에서 300토큰을 모두 생각에 써서 답이 빈 채로 돌아왔습니다. 질문 끝에 /no_think를 붙이는 방법은 효과가 없었고, 요청 본문에 chat_template_kwargs.enable_thinking=false를 넣어야 꺼졌습니다. 11월 6일과 같은 종류의 문제를 다른 API 경로에서 다시 만난 셈입니다.
11월 20일 오후에 근거 약 7,230토큰짜리 합성 문서로 다시 쟀습니다.
| 조건(각 1회) | 전체 시간 | 비고 |
|---|---|---|
| 생각 모드 켬(기본값) | 6.60초 | 생각 113토큰 뒤 답변 |
질문에 /no_think 추가 | 6.05초 | 생각 106토큰, 효과 없음 |
enable_thinking=false | 4.04초 | 답변 38토큰 |
| 같은 요청 재전송 | 0.84초 | 첫 토큰 0.068초 |
4초의 대부분은 약 7천 토큰의 입력 처리 시간이었습니다. 같은 요청을 다시 보내자 이미 처리해 둔 앞부분을 prefix cache에서 재사용해 첫 토큰이 0.07초 만에 나왔습니다. 같은 문서로 이어지는 질문이나 같은 시스템 프롬프트가 빠른 이유입니다.
임베딩 처리량은 숫자를 바로잡았습니다. 11월 17일에 기록한 값은 1,000자 조각을 64개씩 보내 초당 약 330조각이었는데, 비슷한 문장으로 만든 표본이었습니다.
| 표본(조각 64개씩) | 초당 조각 | 초당 토큰 |
|---|---|---|
| 11-17 기록, 비슷한 문장 | 약 330 | 약 14만 |
| 11-20, 서로 다른 조각 | 약 61 | 약 4.4만 |
| 11-20, 서로 다른 조각, 유휴 확인 후 | 60.1-61.9 | 약 4.4만 |
| 11-20, 같은 조각 반복 | 223 / 273 | 약 16만 / 20만 |
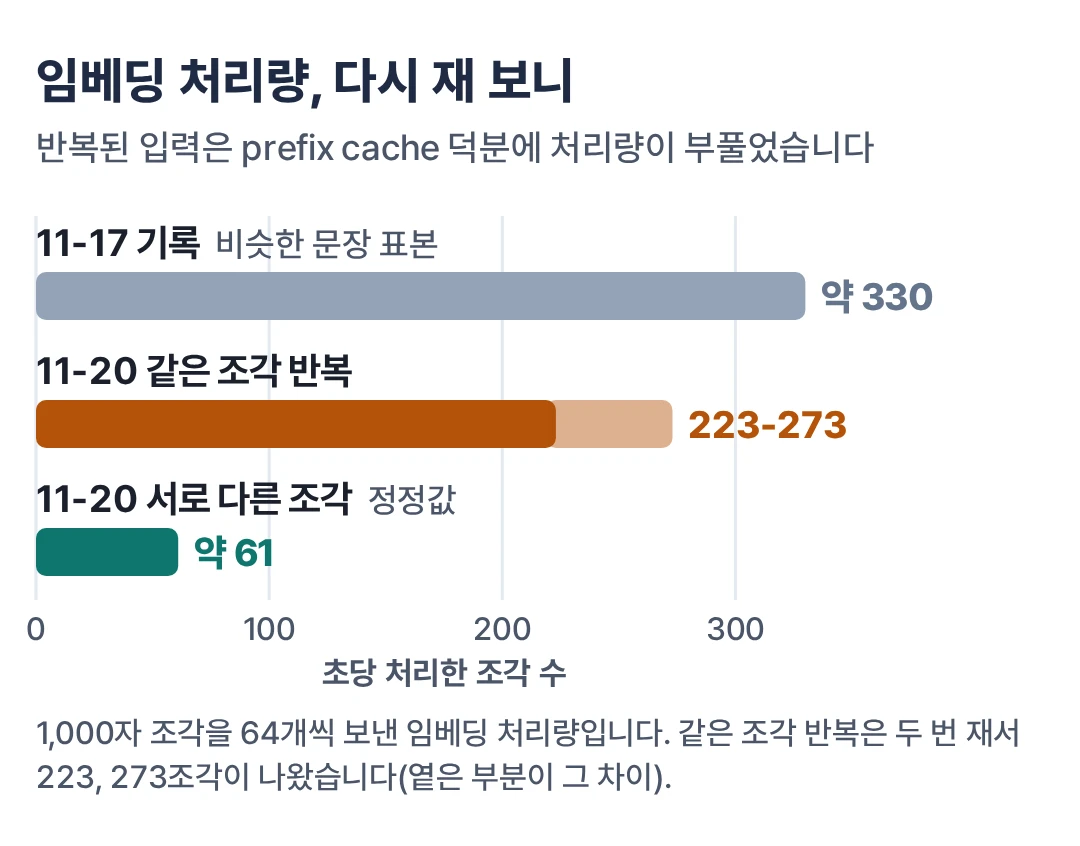
다른 작업과 겹쳐서 느려진 것이 아닌지 확인하려고, 측정 직전 서버 지표에서 처리 중·대기 요청이 0인지 보고 측정 전후 서버의 누적 토큰 증가량이 저희 요청의 합과 같은지도 대조했습니다. 그 조건에서도 초당 61조각이었습니다. 같은 조각을 반복하자 초당 223-273조각까지 올랐고, 앞머리만 바꾼 조각은 63조각 안팎으로 돌아왔습니다. 임베딩 서버에도 prefix cache가 켜져 있어서 생긴 차이로 봤습니다. 11월 17일 표본은 조각당 토큰 수도 달라 차이 전부를 캐시로 설명할 수는 없지만, 반복 입력이 처리량을 부풀린다는 것은 분명했습니다. 처리량을 잴 때는 서로 다른 입력을 써야 합니다.
7. 11월 20일 저녁, 이 글을 위해 다시 쟀습니다
운영 중에 쌓인 숫자는 서비스마다 조건이 달라 한 표로 비교하기 어려웠습니다. 그래서 같은 장비를 같은 방법으로 다시 쟀습니다. 공유 서버라 측정 단계마다 다른 요청이 섞이지 않았는지 먼저 확인했습니다.
측정 방법
| 항목 | 설정 |
|---|---|
| 호출 | 같은 사내망의 다른 기기에서 OpenAI 호환 /v1/chat/completions, 스트리밍 |
| 생각 모드 | chat_template_kwargs.enable_thinking=false(생각 모드 비교만 예외) |
| 출력 | temperature 0, ignore_eos로 길이 고정(동시 실행 256토큰, 긴 문맥 128토큰) |
| 캐시 억제 | 요청마다 앞에 고유 번호를 붙여 prefix cache 재사용을 막음 |
| 유휴 확인 | 단계 시작 전 /metrics의 처리 중·대기 요청이 0이 될 때까지 기다림 |
| 혼입 검사 | 단계 전후 서버 누적 생성 토큰 증가량이 저희 요청 합과 같은지 대조 |
| 시간 | 클라이언트 기준(사내망 왕복 포함). 생성률 = (출력 토큰 − 1) ÷ (전체 시간 − 첫 토큰 시간) |
측정에 쓴 Python 요청 예시입니다. 표준 라이브러리만 쓰며, 같은 옵션을 지원하는 vLLM 계열 채팅 API와 /metrics에 접근할 수 있는 환경이라면 서버 주소와 모델 ID만 바꿔 실행할 수 있습니다.
실제 측정 스크립트에서 핵심만 줄인 것입니다. 혼입 검사는 측정 전후 /metrics의 vllm:generation_tokens_total 차이를 저희 요청의 출력 토큰 합과 비교하는 방식입니다.
동시 요청 수: 8건에서 포화됐습니다
입력 약 52토큰의 짧은 요청에 출력 256토큰을 고정하고 동시 요청 수를 늘렸습니다.
| 동시 요청 | 요청 수 | 전체 지연 p50 | 첫 토큰 p50 | 첫 토큰 최대 | 요청당 생성률 p50 | 합산 처리량 |
|---|---|---|---|---|---|---|
| 1 | 8 | 7.86초 | 0.235초 | 0.241초 | 33.5 tok/s | 32.4 tok/s |
| 2 | 8 | 10.52초 | 0.384초 | 0.416초 | 25.2 tok/s | 48.5 tok/s |
| 4 | 16 | 14.39초 | 0.430초 | 0.538초 | 18.4 tok/s | 69.2 tok/s |
| 8 | 32 | 20.48초 | 0.658초 | 0.773초 | 12.9 tok/s | 96.4 tok/s |
| 12 | 48 | 25.62초 | 6.30초 | 21.4초 | 12.6 tok/s | 96.9 tok/s |
동시 4는 첫 측정에 다른 요청이 섞여 있어(서버 생성 4,237토큰, 저희 요청 4,096토큰) 깨끗한 두 번째 측정값을 썼습니다. 세 번째 측정은 69.0 tok/s였습니다. 합산 처리량은 그 단계의 전체 출력 토큰 ÷ 경과 시간입니다.
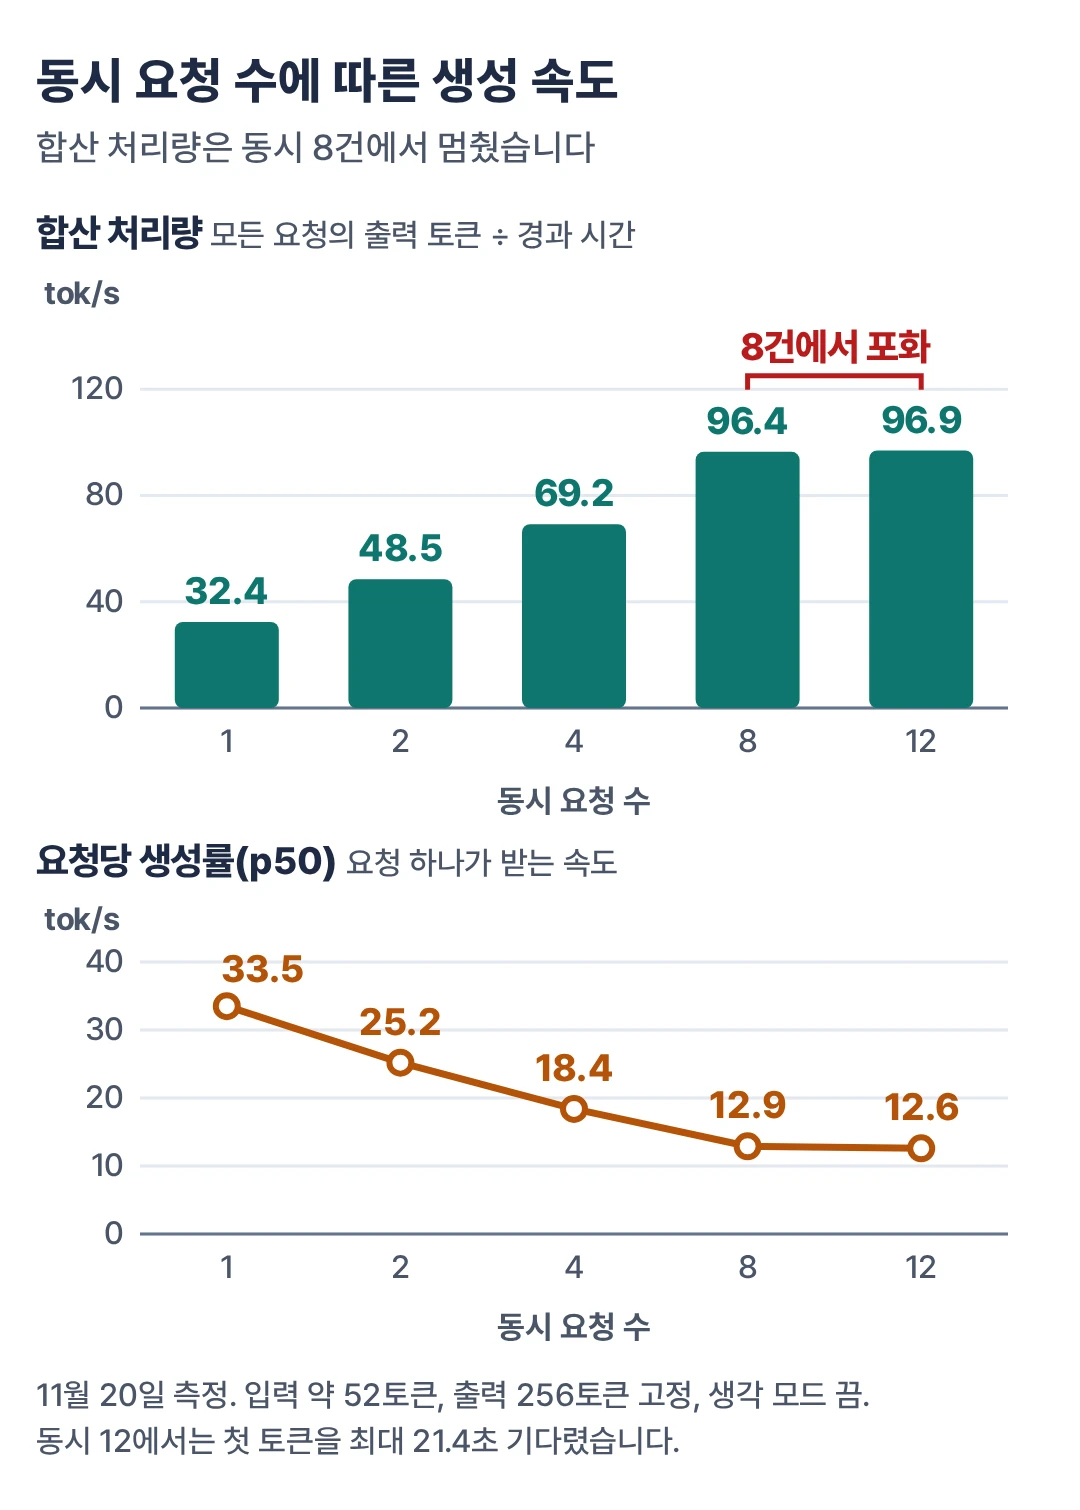
동시 8에서 합산 처리량이 초당 약 96토큰으로 멈췄고, 동시 12는 처리량이 늘지 않은 채 첫 토큰을 최대 21초 기다렸습니다. 대화 서버가 한 번에 8건까지만 처리하도록 설정돼 있어 그 이상은 대기열에 쌓이기 때문입니다. 이 상한을 모든 서비스가 나눠 쓰기 때문에, 문서 검색 서비스는 앞서 서버 설정을 확인하고 에이전트 작업을 전체 4건, 사용자당 1건으로 제한해 두었습니다. 이번 측정에서도 대화 요청이 8건을 넘자 첫 토큰을 기다리는 시간이 길어졌습니다.
긴 문맥: 첫 토큰 시간은 입력 길이에 거의 비례했습니다
동시 1로 입력 길이를 1천 토큰에서 28만 토큰까지 늘렸습니다. 문서 중간에 확인 코드를 하나 숨겨 두고 찾게 했습니다.
| 실제 입력 토큰 | 첫 토큰 시간 | 입력 처리 속도 | 생성률 | 확인 코드 |
|---|---|---|---|---|
| 1,087 | 0.68초 | 1,594 tok/s | 34.2 tok/s | 찾음 |
| 8,537 | 3.79초 | 2,251 tok/s | 40.5 tok/s | 찾음 |
| 34,493 | 14.65초 | 2,354 tok/s | 40.6 tok/s | 찾음 |
| 70,011 | 30.15초 | 2,322 tok/s | 35.3 tok/s | 찾음 |
| 140,989 | 62.39초 | 2,260 tok/s | 41.8 tok/s | 찾음 |
| 283,130 | 132.09초 | 2,143 tok/s | 43.4 tok/s | 찾음 |
283,130토큰은 1건, 나머지는 2건 중 첫 번째 값입니다. 두 번째 값의 생성률은 29.2-39.7 tok/s였고, 14만 토큰의 두 번째 표본은 다른 요청이 섞여 생성률을 쓰지 않았습니다. 확인 코드 찾기는 쉬운 과제라 긴 문서 이해력 평가가 아닙니다.
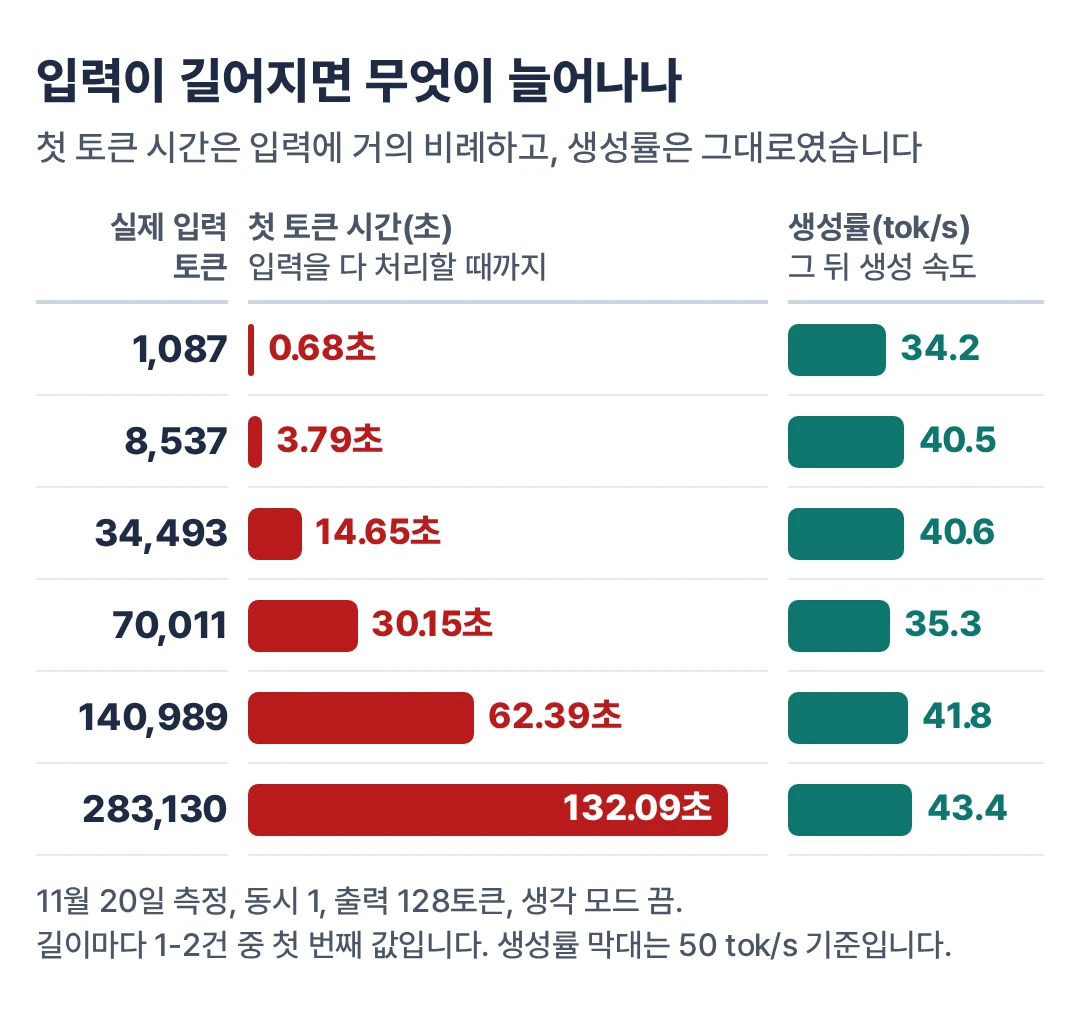
입력 처리 속도가 8천 토큰 이상에서 초당 약 2,150-2,350토큰으로 거의 일정해서, 첫 토큰 시간은 입력 길이에 거의 비례했습니다. 14만 토큰이면 약 1분, 28만 토큰이면 약 2분 12초입니다. 긴 문서를 통째로 넣는 RAG라면 답을 기다리는 시간의 대부분이 여기서 나옵니다.
반면 생성률은 이 단일 요청 표본에서 입력 길이에 따른 일관된 저하가 보이지 않았습니다. 이 모델은 48층 중 36층이 문맥 길이와 상관없이 크기가 고정된 상태를 쓰는 Gated DeltaNet이고, 나머지 12층도 일부 블록만 골라 계산하는 희소 attention이라 그런 결과와 맞습니다. 어느 블록을 고를지 정하는 인덱서는 전체 문맥을 훑으므로 길이에 따른 비용이 아예 없지는 않습니다. 공개된 llama.cpp 결과에서 gpt-oss-120b의 생성 속도가 3만 2천 토큰 깊이에서 27% 떨어진 것과는 다른 모습입니다.
생성률이 요청마다 흔들리는 이유: MTP 채택 길이
같은 조건인데도 요청별 생성률은 29-43 tok/s 사이를 오갔습니다. 서버 지표로 보니 요청별 생성률을 MTP의 평균 채택 길이로 나눈 값이 약 16으로 거의 일정했습니다. 채택 길이가 2.76이면 43.4 tok/s, 1.79이면 29.2 tok/s였습니다. 즉 이 구성의 단일 요청 생성은 “초당 약 16번의 검증 단계 × 단계마다 확정되는 토큰 수”로 움직이고, 확정 토큰 수는 무엇을 생성하느냐에 따라 달라집니다. 미리 제안한 토큰 여러 개를 본 모델이 한꺼번에 검증하는 원리는 추측 디코딩 글에서 설명했습니다.
11월 7일의 40 tok/s와 이번 33 tok/s의 차이도 이 때문일 수 있지만, 그때는 생각 모드가 켜져 있었고 질문과 출력 길이도 달랐으므로 원인을 하나로 단정하지 않습니다.
prefix cache, 임베딩, 생각 모드
| 측정 | 결과 |
|---|---|
| 같은 34,448토큰 입력 3회 | 첫 토큰 14.64초 → 0.112초 → 0.106초. 서버 prefix cache 적중 카운터가 2·3회차에 각각 34,448 증가 |
| 임베딩 동시 워커 1 → 4(서로 다른 조각, 조각당 약 1,485토큰) | 초당 약 4.2만 토큰 → 4.5만 토큰, 거의 같음 |
| 생각 모드 끔 → 켬(같은 6문항, 출력 상한 4,096, 자연 종료) | 완료 시간 중앙값 30.6초 → 61.1초, 출력 토큰 중앙값 1,201 → 2,519 |
prefix cache는 API 응답의 cached_tokens가 이 빌드에서 비어 있어 서버 카운터로 확인했습니다. 임베딩은 워커를 늘려도 처리량이 그대로라, 서버 설정이 처리량의 상한을 정하는 것으로 보입니다.
생각 모드 비교에서는 출력 길이를 고정하지 않고 실제 질문에 끝까지 답하게 했습니다. 켰을 때 생각 토큰 자체는 134-794개로 많지 않았지만 답변이 길어지는 경향이 있어(6문항 중 4문항) 완료 시간이 두 배가 됐고, 1문항은 상한 4,096토큰에 걸려 잘렸습니다. 6문항을 한 번씩 돌린 결과라 답변 품질은 비교하지 않았습니다.
세 번 반복했을 때
| 항목 | 1차 | 2차 | 3차 |
|---|---|---|---|
| 동시 1, 요청당 생성률 p50 | 33.5 | 32.3 | 33.8 tok/s |
| 동시 1, 합산 처리량 | 32.4 | 31.7 | 32.3 tok/s |
| 동시 4, 합산 처리량 | (혼입) | 69.2 | 69.0 tok/s |
| 동시 8, 합산 처리량 | 96.4 | 97.7 | 96.5 tok/s |
| 3만 4천 토큰, 입력 처리 | 2,354 | 2,357 | 2,355 tok/s |
| 14만 토큰, 입력 처리 | 2,260 | 2,261 | 2,261 tok/s |
다른 요청이 섞이지 않은 회차끼리 합산 처리량은 동시 1이 약 2.3%, 동시 8이 약 1.4% 차이였고, 긴 입력의 처리 속도는 거의 같았습니다. 요청 하나의 생성률은 생성 내용에 따라 더 흔들립니다.
8. 같은 돈이면 무엇을 살 수 있나
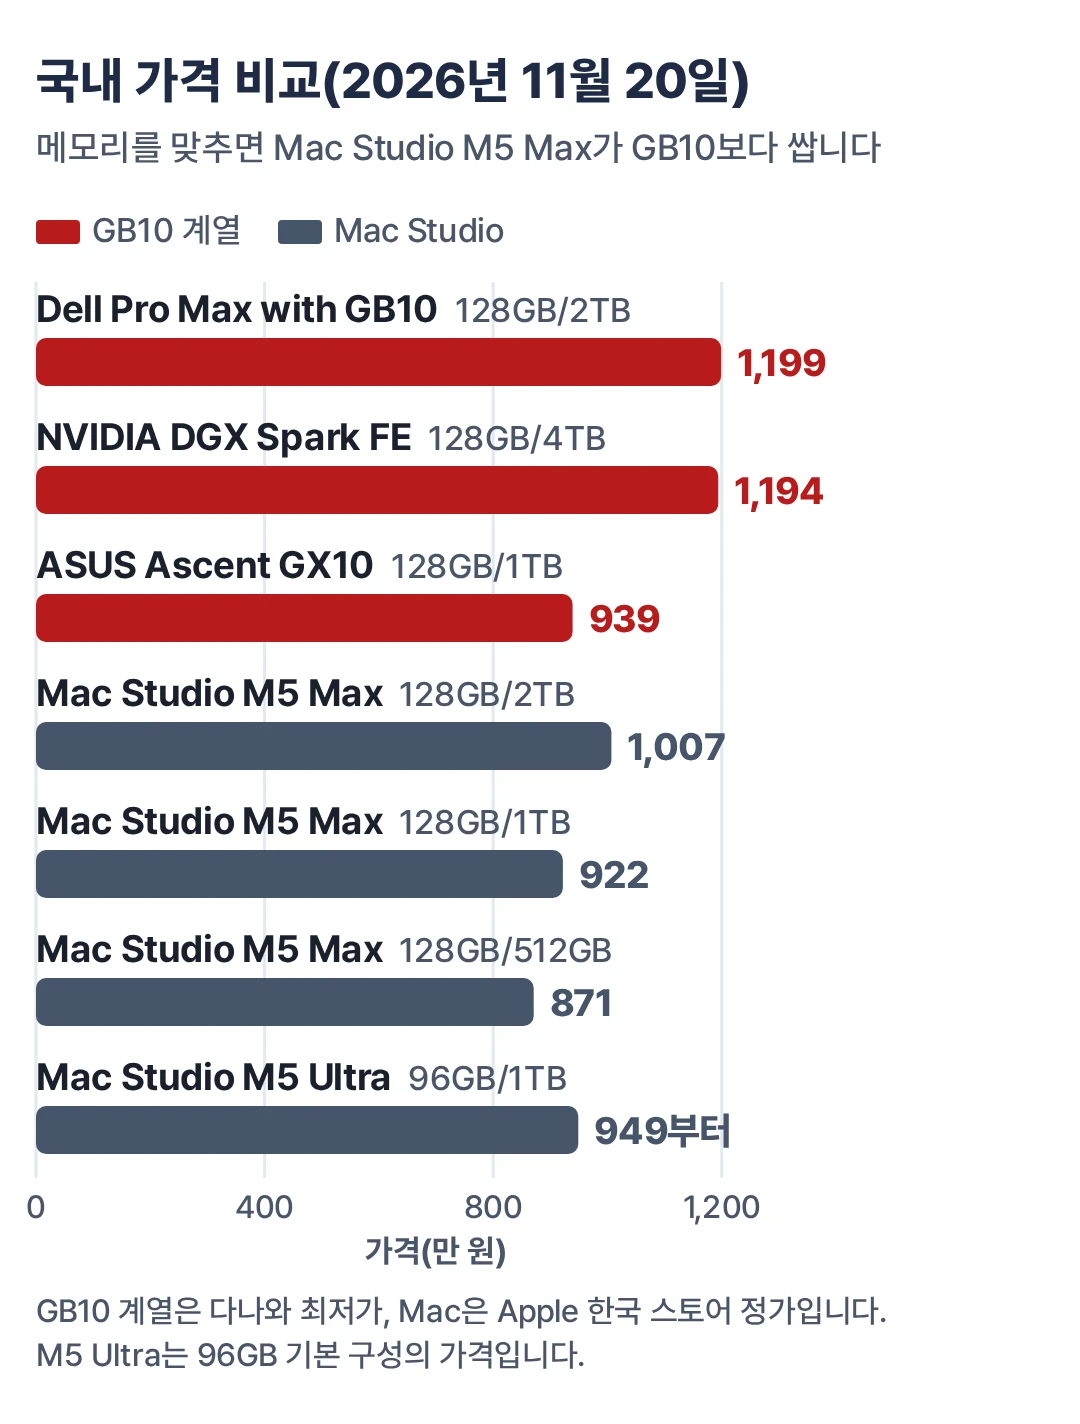
메모리와 저장 용량을 맞추면 Mac Studio M5 Max 128GB가 Dell GB10 2TB보다 192만 원, ASUS GX10 1TB보다 17만 원 쌉니다. GB10이 출시가 그대로였다면 반대였을 관계입니다.
| 장비 | 구성 | 가격(2026-11-20) |
|---|---|---|
| Dell Pro Max with GB10 | 128GB / 2TB | 1,199만 원 |
| NVIDIA DGX Spark FE | 128GB / 4TB | 1,194만 원 |
| ASUS Ascent GX10 | 128GB / 1TB | 939만 원 |
| Apple Mac Studio M5 Max(40코어 GPU) | 128GB / 512GB | 871만 원 |
| 〃 | 128GB / 1TB | 922만 원 |
| 〃 | 128GB / 2TB | 1,007만 원 |
| Apple Mac Studio M5 Ultra | 96GB / 1TB | 949만 원부터 |
GB10 계열은 다나와 최저가, Mac은 Apple 한국 온라인 스토어 정가(옵션 차액 합산)입니다. 유통 최저가와 제조사 정가라 가격 유형이 다릅니다.
Mac Studio M5 Max(614GB/s)와 M5 Ultra(1.2TB/s)는 메모리 대역폭이 GB10(273GB/s)보다 커서 생성 속도가 빠릅니다. 이전 세대 Mac Studio M4 Max도 gpt-oss-120b 생성이 GB10의 평균 약 1.5배였고, 같은 모델을 4K 문맥에서 돌리면 M5 Max를 탑재한 MacBook Pro는 초당 약 88토큰, GB10은 약 56토큰이었습니다. 이 Mac 비교는 저희가 직접 잰 것이 아니라 공개 벤치마크를 근거로 한 추정 비교입니다.
입력 처리는 세대에 따라 다릅니다. M4 Max와 비교한 리뷰에서는 3만 2천 토큰 문맥 과업을 GB10이 입력 처리 덕분에 더 빨리, 더 적은 전력량으로 끝냈습니다. 반면 M5 세대에서는 긴 문맥에서 Mac이 앞선 결과가 있고, M5 Ultra는 입력 처리에서도 GB10을 앞섰습니다. 결국 GB10에 남는 분명한 강점은 CUDA 생태계를 그대로 쓴다는 점입니다.
CUDA 기반 도구와 서빙 스택(vLLM, TensorRT-LLM 등)을 그대로 써야 하면 GB10, 생성 속도와 가격이 우선이면 Mac 쪽이 맞습니다. M5 Ultra는 기본 구성이 96GB라 128GB가 필요하면 상위 구성으로 올라가야 합니다.
64GB GB10은 NVIDIA 공식 플레이북이 Qwen3.8 27B(NVFP4) 같은 모델을 권장 예시로 듭니다. 쓰려는 모델이 그 정도 크기라면 실질적인 대안입니다. 저희 모델처럼 96GiB짜리 체크포인트는 들어가지 않습니다.
GPU 임대와 API
| 선택지 | 단위 가격(2026-11 조회) | 이 모델을 한 장에 올릴 수 있나 | $7,901로 쓸 수 있는 시간 |
|---|---|---|---|
| RunPod RTX PRO 6000(96GB) | $1.69 / $2.69 per hour(Community / Secure) | 일부 가중치를 디스크로 빼는 오프로드 조건으로 가능 | 4,675 / 2,937시간 |
| CoreWeave RTX PRO 6000 | 8장 묶음 $20.00/h(1장당 $2.50) | 위와 같음 | 8장 단위 청구라 395시간 |
| AWS g7e.2xlarge(RTX PRO 6000) | $3.363/h | 위와 같음 | 2,349시간 |
| RunPod H200(141GB) | $3.59 / $5.29 per hour | 가능 | 2,201 / 1,494시간 |
| AWS p5en.48xlarge(H200 8장) | $63.296/h(1장당 $7.91) | 가능 | 125시간 |
| H100 80GB | 공급자별 시간당 $2-7 | 체크포인트가 커서 한 장에 그대로는 안 됨 | — |
| Qwen3.8-Flash API | 입력 $0.15, 출력 $0.47 per 1M 토큰 | — | 출력만 약 168억 토큰 |
$7,901은 미국 Dell 128GB/2TB 표시가입니다. 전기료·저장소·전송료는 뺐습니다. Qwen3.8-Flash API는 같은 계열의 상용 모델이지만, 로컬에서 돌리는 FP4 체크포인트와 같은 모델이라는 보장은 없습니다.
24시간 상시로 빌리면 몇 달 만에 장비값에 닿습니다. 그런데 같은 작업량을 처리하는 데 드는 임대 비용은 GPU마다 처리 속도가 달라 이 표만으로는 알 수 없고, 이 모델을 임대 GPU에서 직접 돌려 보지도 않았습니다. 사용량이 적고 외부 처리가 가능하다면 임대도 비교해 볼 만하다는 정도로만 봐 주십시오.
토큰 단위로 보면 API가 크게 유리합니다. 동시 8 포화 처리량 96.4 tok/s를 24시간 30일 유지한다고 가정하면 월 약 2.5억 출력 토큰이고, 출력 단가 $0.47로 환산하면 월 약 $117입니다. 이 금액이 장비 표시가 $7,901과 같아지려면 약 67개월이 걸립니다. 이것은 짧은 입력에 출력 길이를 고정한 과업에서 “API 출력 단가 환산액이 장비 표시가와 같아지는 시점”일 뿐이고, 구매비 회수 기간이 아닙니다. 입력이 긴 RAG는 입력 비용이 출력보다 커져(근거 7,200토큰 + 답변 500토큰이면 입력 비용이 출력의 약 4.6배) API 쪽 비용이 올라가고, 캐시 할인이나 낮은 가동률은 API 쪽 비용을 내립니다.
자기 사용량으로 계산하려면 아래 순서로 넣어 보면 됩니다.
| 단계 | 계산 |
|---|---|
| 월 API 비용 | 월 입력 토큰 × 입력 단가 + 월 출력 토큰 × 출력 단가 − 캐시 할인 |
| 월 로컬 운영비 | 전기료 + 관리에 드는 시간을 금액으로 환산한 값 |
| 장비값과 같아지는 시점 | 장비 가격 ÷ (월 API 비용 − 월 로컬 운영비). 괄호 안이 0 이하이면 장비값에 닿는 시점이 없습니다 |
| 확인할 조건 | 지연 목표, 피크 동시 요청 수, 장비의 남은 가치 |
전기료는 크지 않습니다. 공개 리뷰에서 잰 소비 전력은 유휴 약 30-37W(Dell 모델 기준), LLM 추론 중 약 60-90W, GPU 고부하에서 약 145-160W였습니다. 평균 75W로 1년 내내 켜 두면 약 657kWh이고, 주택용 누진 2단계 한계단가(kWh당 약 258원)를 적용하면 연 약 17만 원입니다. 사용 패턴과 누진 단계에 따라 연 약 3만-36만 원 범위입니다. 저희 장비의 전력은 직접 재지 않았습니다.
9. 자료가 밖으로 나가지 않는다는 것
비용으로는 API를 이기기 어렵지만, 로컬 추론에는 API가 구조적으로 줄 수 없는 장점이 있습니다. 사내 장비에서 추론하면 프롬프트와 문서 문맥, 생성 결과가 외부 모델 API로 나가지 않습니다.
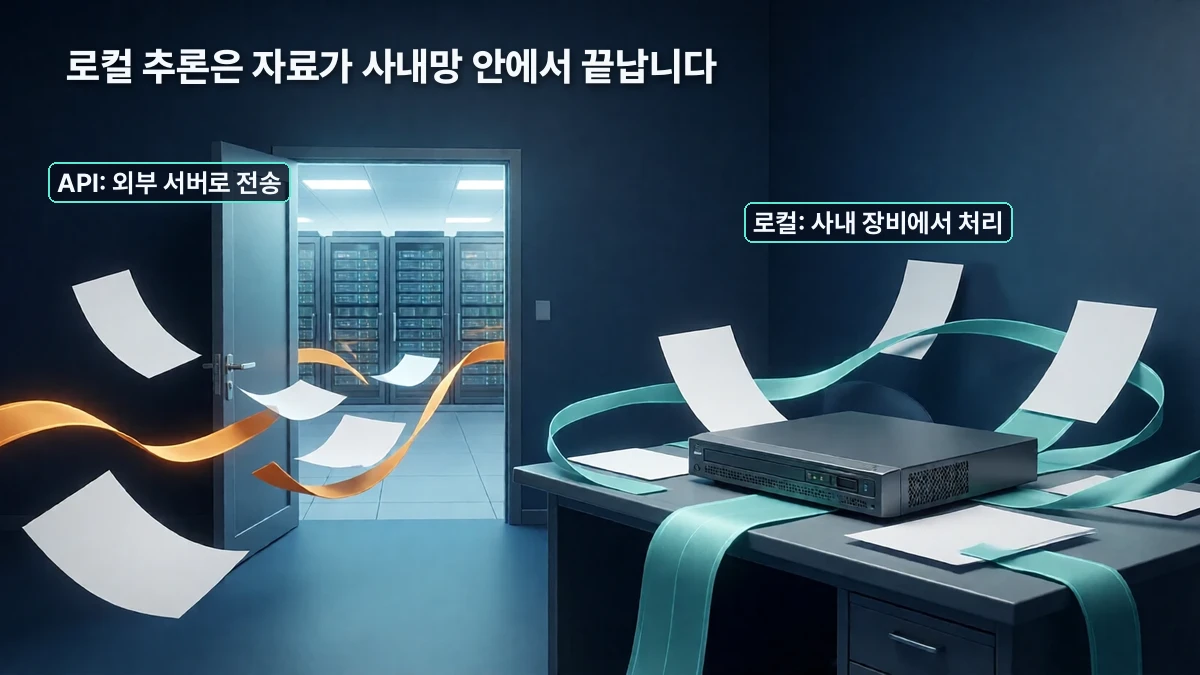
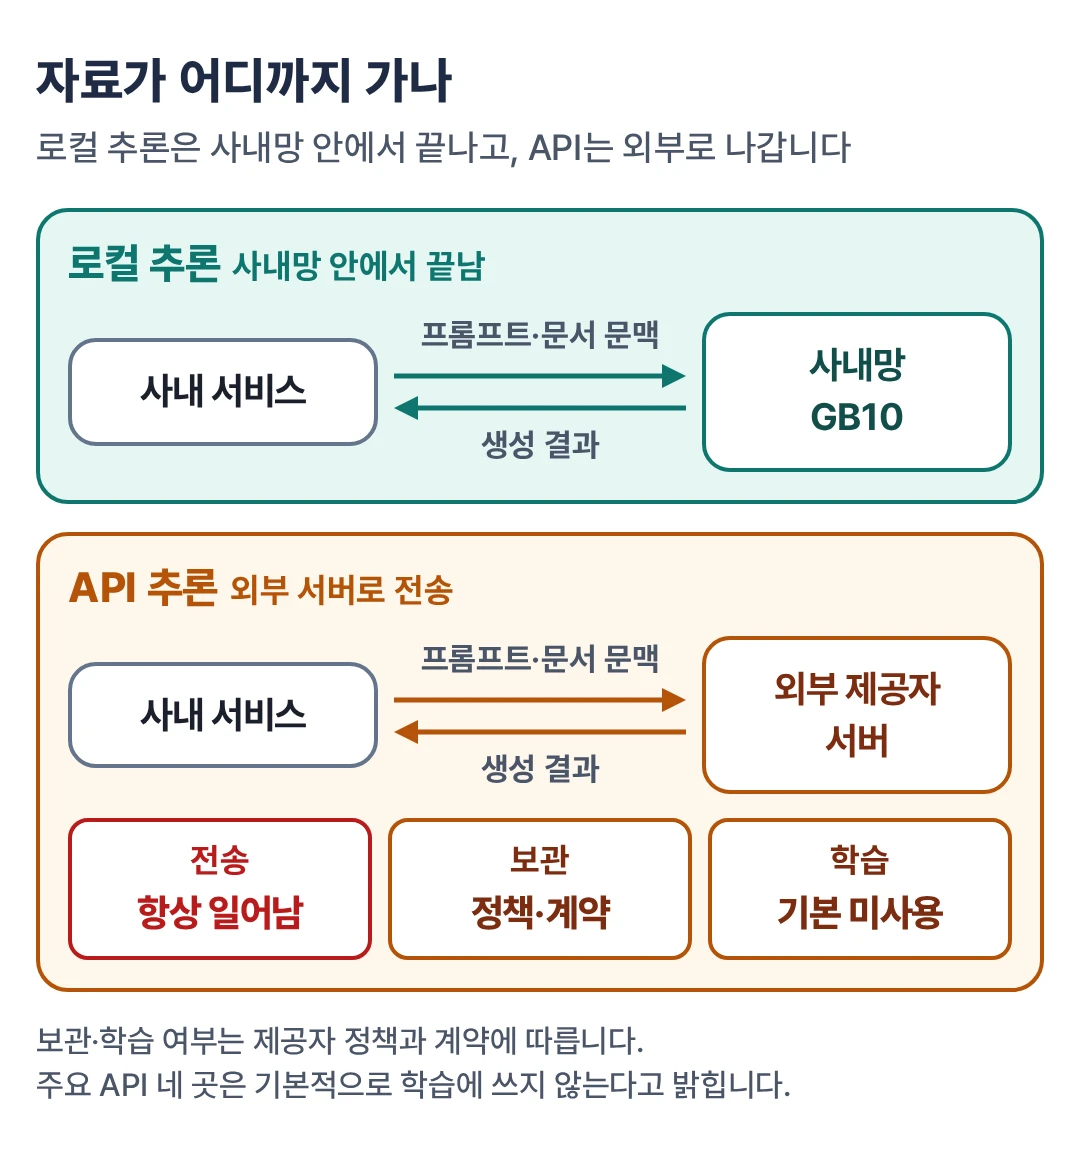
API 쪽 사정을 과장하지 않으려면 전송·보관·학습을 나눠 봐야 합니다.
| 구분 | 주요 API의 현재 정책(2026-11-20 확인) |
|---|---|
| 전송 | 프롬프트와 첨부 문서, RAG 문맥이 제공자 서버로 갑니다. 서버가 국외에 있으면 개인정보 국외이전 검토 대상이 됩니다 |
| 보관 | OpenAI(남용 모니터링 로그)·Anthropic·Alibaba Cloud Model Studio는 기본 최대 30일, OpenRouter 자체는 미저장이 기본입니다. Anthropic은 정책 위반으로 분류되면 최대 2년, 파일 기능에 올린 자료는 지울 때까지 보관합니다. 무보관 설정(ZDR, Zero Data Retention)은 제공자에 따라 승인이나 계약이 필요합니다 |
| 학습 | 네 곳 모두 API 데이터를 기본적으로 학습에 쓰지 않는다고 밝힙니다. 중개 서비스는 실제로 처리하는 하위 제공자의 정책을 따로 봐야 합니다 |
국내 지침도 외부 AI 사용 자체를 막지는 않습니다. 개인정보보호위원회의 「생성형 인공지능(AI) 개발·활용을 위한 개인정보 처리 안내서」(2025년 8월)는 API형 서비스를 쓸 때 데이터 보관·재이용(학습 포함)·국외이전 여부를 미리 검토하라고 권하고, 기업용 API 계약과 내부 프록시를 거치는 구성을 방법으로 제시합니다. 국외이전 자체는 개인정보 보호법 제28조의8의 요건을 갖춰야 합니다.
국가·공공기관에는 더 구체적인 기준이 있습니다. 국가정보원의 국가 망 보안체계(N²SF) 가이드라인은 인터넷의 상용 생성형 AI에는 공개 등급 업무정보만 다루게 하는 통제를 둡니다. 한편 범정부 「공공부문 초거대 AI 도입·활용 가이드라인」 2.0은 민간 클라우드 도입을 우선 검토하라고 하면서 민감 자료의 유출 방지 설계와 보안성 검토를 요구합니다.
그러니 “로컬이어야만 한다”는 결론은 아닙니다. 외부 처리가 허용되는 자료라면 기업용 API 계약과 보관 설정으로도 충분할 수 있습니다. 다만 외부로 보내기 어려운 자료를 다룬다면, 로컬 추론은 그 조건을 구조적으로 맞추기 쉬운 방법입니다.
로컬이라고 저절로 안전해지지는 않습니다. 저희 장비도 사내망 안에서 평문 HTTP로, 모델 서버 인증 없이 돌고 있습니다. 이 장비를 쓰는 서비스 하나는 원격 작업자 연결에 HTTP를 허용하던 것을 높은 등급 결함으로 판정해 HTTPS만 쓰도록 고쳤습니다. 서버에 요청 본문이 남는지도 아직 확인하지 않았습니다. 접근 통제와 암호화, 로그 관리는 로컬에서도 따로 챙겨야 하고, 모델 라이선스(이 모델은 NVIDIA Open Model Agreement와 Qwen Community License)도 운영자가 직접 확인해야 합니다.
10. 그래서 누구에게 맞나
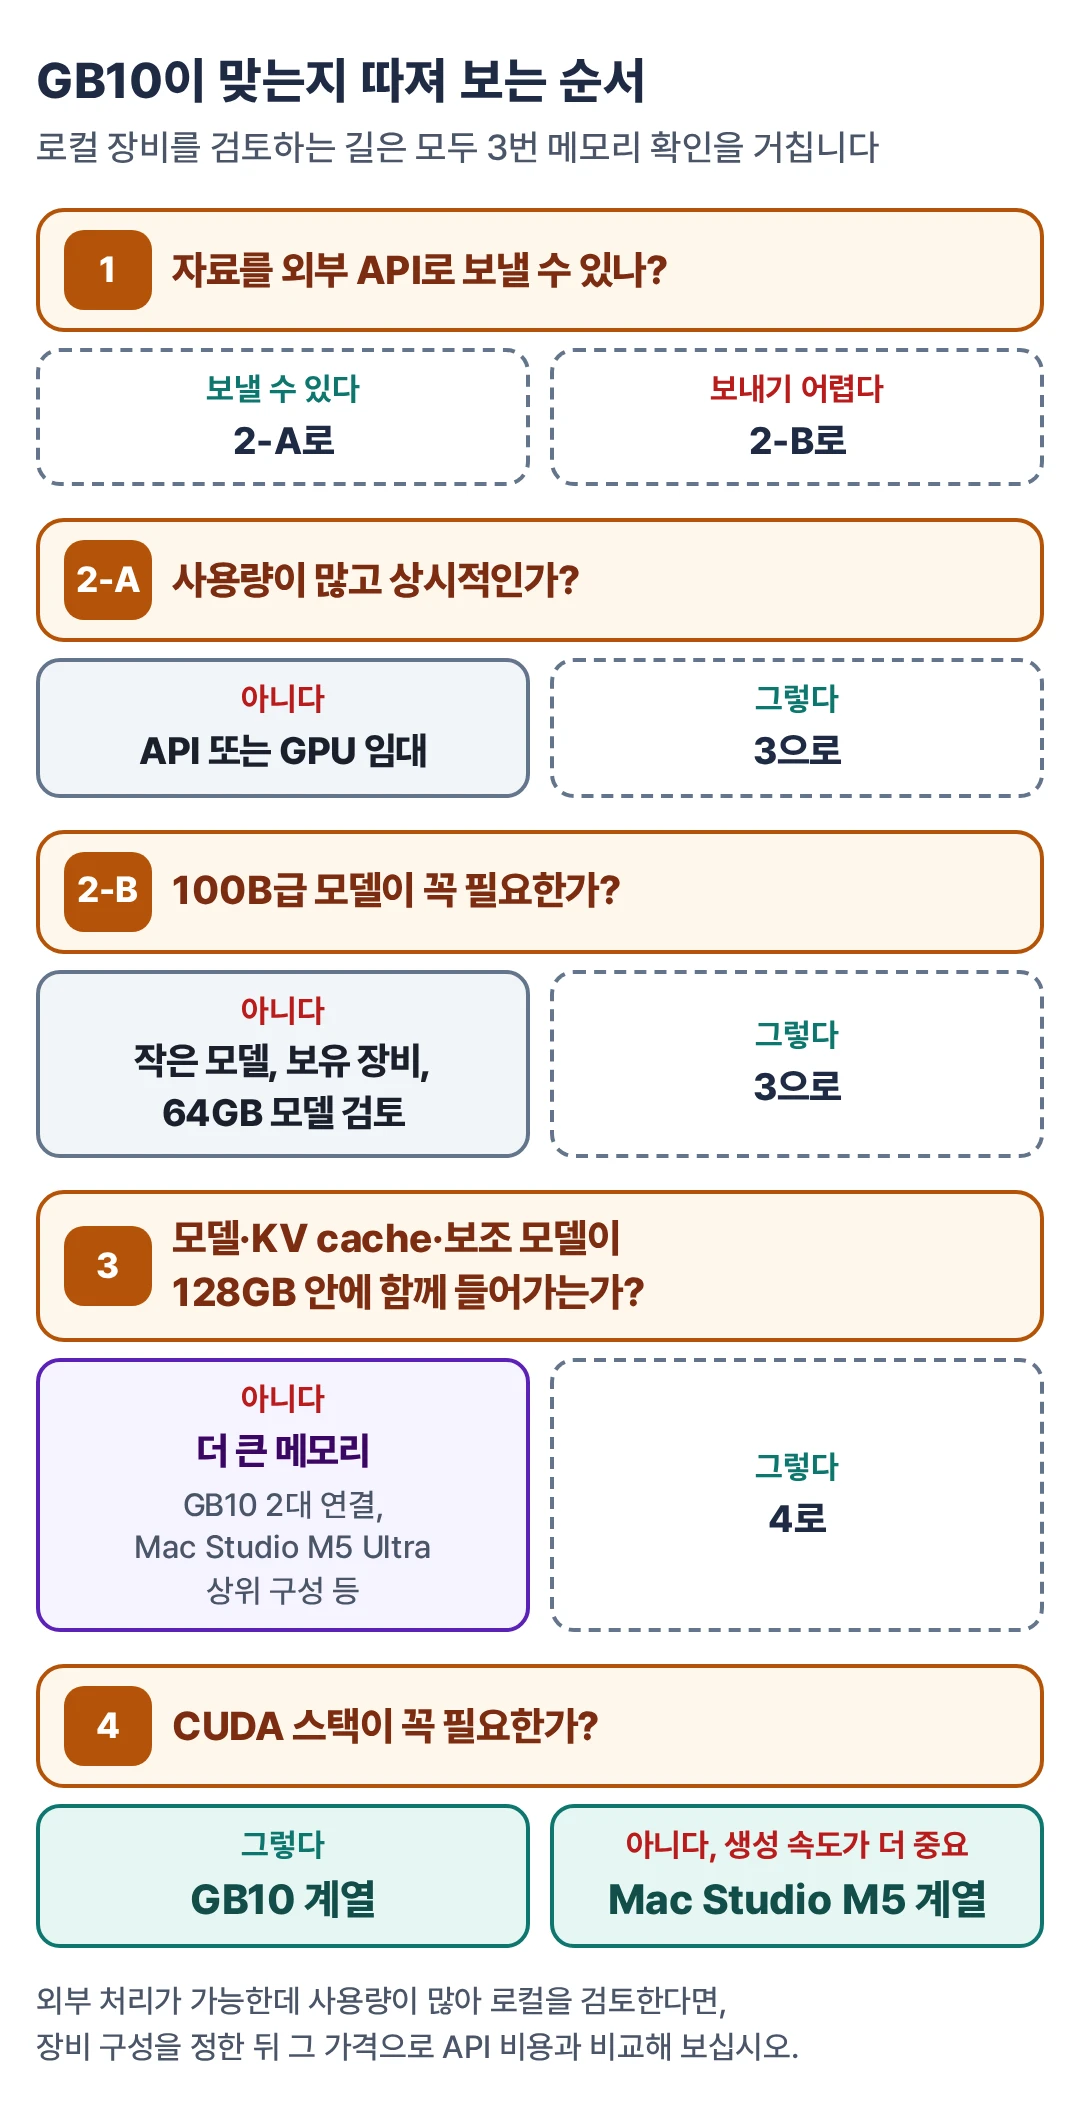
저희처럼 외부로 보내기 어려운 자료를 다루고, 100B급 모델 하나와 임베딩·리랭커를 상시 띄워 서비스 몇 개가 나눠 쓰는 경우에는 GB10이 여전히 맞는 선택지입니다. 128GB에 이 구성이 한 번에 올라가고, 긴 문서 입력도 초당 2천 토큰대로 꾸준히 처리합니다. 반대로 외부 처리가 가능하고 사용량이 간헐적이라면 장비를 살 이유가 약합니다. 외부 처리는 어렵지만 사용량이 간헐적이라면 작은 모델이나 이미 가진 장비로 충분한지부터 확인해 보는 편이 낫습니다. 중고나 국내 임대는 매물과 조건을 확인하지 못해 비교에서 뺐습니다.
| 약점 | 내용 |
|---|---|
| 소프트웨어 지원 | aarch64와 GB10 전용 GPU 구조(SM121)를 지원하는 공식 빌드가 늦습니다. 저희 모델도 커뮤니티 vLLM 빌드가 있어야 돌아갑니다 |
| 업데이트 안정성 | DGX OS 업데이트 뒤 가용 메모리 감소나 화면 출력 문제 같은 회귀가 NVIDIA 포럼에 여러 건 보고돼 있습니다 |
| 시작 시간 | vLLM 공식 블로그는 큰 모델 가중치 적재에 10-15분이 걸렸다고 적었습니다 |
| 동시 처리 | 짧은 요청 기준 동시 8건 부근에서 합산 처리량이 포화됩니다(이 모델·이 설정) |
| 보증·저장 장치 | Dell 기본 보증은 1년(국내는 최대 3년 지원 옵션), 2TB 구성은 QLC SSD입니다 |
| 유휴 전력 | Dell 모델은 유휴 약 30-37W로, 펌웨어 업데이트 뒤 22-25W로 내려간 FE보다 높습니다 |
장비 두 대를 ConnectX-7로 직접 묶으면 메모리를 256GB로 늘려 더 큰 모델을 올릴 수 있지만, 이는 여러 PC에 요청을 나눠 보내는 방식과는 다릅니다. 요청 분산 쪽은 NVIDIA PAIR 글에서 정리했습니다.
11. 이 측정으로 말할 수 없는 것
| 한계 | 내용 |
|---|---|
| 공유 서버 | 운영 중인 장비라 다른 요청이 섞일 수 있습니다. 섞인 단계는 표시하고 대표값에서 뺐습니다 |
| 표본 크기 | 동시 요청 시험은 단계당 8-48건, 긴 문맥은 길이별 1-2건, 캐시 시험은 3건. 반복 3회는 동시 1·4·8과 3만 4천·14만 토큰 입력만, 동시 2·12와 나머지 길이는 1회. 생각 모드 비교는 6문항 1회입니다 |
| 시간 기준 | 클라이언트에서 잰 시간이라 사내망 왕복이 포함됩니다 |
| 소프트웨어 | 커뮤니티 vLLM 빌드와 이 모델·설정의 값입니다. 공식 빌드나 다른 모델에 그대로 옮길 수 없습니다 |
| 입력 자료 | 합성 입력과 공개 영상 표본만 썼습니다 |
| 품질 | 답변·설명의 품질은 평가하지 않았습니다 |
| 다른 플랫폼 | 임대 GPU나 다른 장비에서 같은 과업을 돌리지 않았습니다 |
| 운영 용량 | 세 서버가 동시에 부하를 받는 경우, 짧은 요청과 긴 RAG 요청이 섞인 경우는 재지 않았습니다 |
| 전력 | 장비 전력은 직접 재지 않았습니다 |
참고자료
장비·가격
- NVIDIA DGX Spark 하드웨어 사양
- NVIDIA 개발자 포럼, 2026년 2월 가격 변경 공지
- NVIDIA 블로그, DGX Spark 64GB 발표
- The Register, 128GB 가격 $6,950 인상 보도(보도 기사)
- Dell.com 미국, Dell Pro Precision(Pro Max) with GB10 구성 페이지
- 다나와, DELL Pro Max GB10 128GB/2TB
- 뉴스1, DGX Spark 국내 출시가 715만 원(보도 기사)
- TrendForce, 2026년 1분기 메모리 가격 전망
- Dell Pro Max with GB10 스펙시트(PDF)
- Apple 한국 스토어, Mac Studio M5 Max 구성
모델·소프트웨어
- NVIDIA 모델 카드, Qwen3.8-Flash-Next-FP4-Local
- Qwen 모델 카드, Qwen3.8-Flash-Next
- NVIDIA DGX Spark 플레이북, vLLM
- vLLM 공식 블로그, DGX Spark에서 vLLM 실행
- vLLM 문서, 추측 디코딩 채택 지표
- NVIDIA 개발자 포럼, SM121 소프트웨어 지원 스레드
벤치마크·리뷰(제3자)
- llama.cpp 공식 DGX Spark 벤치마크
- Tom’s Hardware, Mac Studio M4 Max와 GB10·Strix Halo 비교
- Tom’s Hardware, Mac Studio M5 Ultra 리뷰
- Hardware Corner, M5 Max 로컬 LLM 벤치마크(커뮤니티 측정 인용 기사)
- StorageReview, Dell Pro Max with GB10 리뷰
- ServeTheHome, DGX Spark 리뷰(전력 측정)
- Tom’s Hardware, DGX Spark 유휴 전력 업데이트
비용·데이터 정책
- RunPod 가격, CoreWeave 가격, AWS EC2 온디맨드 가격
- Qwen Cloud, Qwen3.8-Flash 가격
- OpenAI API 데이터 정책
- Anthropic 데이터 보관 기간, 모델 학습 이용 여부
- Alibaba Cloud Model Studio 데이터 보관 정책
- OpenRouter 데이터 수집 안내
- 한국전력 주택용 전기요금표
국내 지침